GPT-Image-2.5 实测:画质见顶,“快”成了突破口
OpenAI 推出 GPT-Image-2.5,拆分为效率款 Flare 与精工款 Sunburst,生成延迟最高降低 50%,API 单价不变。8 组案例对比 GPT-Image-2:画质提升有限,速度与多轮编辑一致性才是真正的升级。
2026 年 9 月 9 日,距 GPT-6 Astra 发布仅 5 天,OpenAI 又推出了 ChatGPT Images 2.5 的两款图像模型。
OpenAI 在发布稿开头给出了一个数字:每周,人们在 ChatGPT 和 GPT-Image API 中生成的图片超过 30 亿张,折算下来约每秒 5000 张。
如果 AI 绘图还只是小众玩具,迭代的重点自然是画质天花板——画质再突破 10%,圈内就能热闹好几天。但一周 30 亿张已成常态,说明它已经是许多人的生产力工具,属于基础设施;而基础设施的一大痛点,正是生产效率。
因此,这次更新清单里最重要的一条是:生成延迟最高降低 50%,API 单价不变。
从 2.0 到 2.5:一个模型拆成两个
这次升级有一个结构性变化,需要先把版本理清。
此前是 GPT-Image-2 一个模型包揽所有任务,无论需求复杂与否都交给它。现在,Images 2.5 在 ChatGPT 中仍是一个模型,在 API 中则拆成了两个:
- GPT-Image-2.5 Flare(默认款):主打效率,画质高于 GPT-Image-2,延迟减半。Manus 评测团队的说法是:同等高质量下,速度是 GPT-Image-2 的 2–4 倍。适合批量出图、社媒素材、快速原型、视觉搜索这类高吞吐场景。
- GPT-Image-2.5 Sunburst(精工款):主打精准,用更长的生成时间换取更严格的控制,面向广告级物料、精修产品图这类终稿不能出错的生产管线。
两款模型的 token 单价完全相同(图像输出每百万 token $30)。据第三方估算,在同等高质量档位下,2.5 的单张实际成本约为上一代的四分之一——效率提高了,每张图消耗的 token 也就少了。
一句话概括这次的产品升级:不再逼用户在“快”和“好”之间二选一,而是把两个答案分别装进两个接口。
四个升级方向,被低估的是多轮一致性
官方这次更新了四个方向:参考图保真、精准编辑、多轮一致性、智能与风格。前两项最容易让人惊叹,但真正的分水岭是第三项。
参考图保真。给一张真人照片,生成的图里仍是同一个人,五官、神态和辨识度在风格变换之后依然得以保留。第三方实测中有一个出圈案例:一张用鼠标画的粗糙猫咪涂鸦被转成写实照片,再追加一句指令只改瞳孔颜色,其余部分纹丝不动。
精准编辑。“只改指定的部分”从碰运气变成了可以兑现的承诺。替换海报里的一个产品、改掉派对合照里的一件衣服,构图、光线和周围细节都原样保留。对电商和营销团队来说,改图不再等于从头再来。
多轮编辑一致性。用过 AI 绘图的人大多经历过这样的场景:第 1 轮生成,很满意;第 2 轮改个背景,脸有点歪了;第 3 轮想把脸改回来,衣服款式又没了……每一轮编辑都像重新摇号,改上十轮,画面早已面目全非。
Images 2.5 的做法是:在多轮对话中记住早期的修改,每次编辑都在已有成果上累加,而不是推倒重来。
这之所以是分水岭,是因为真实的创作从来不是一锤子买卖,而是“生成→不满意→修改→再修改”的循环。多轮编辑不崩,意味着 AI 绘图第一次能够支撑工作流,而不只是支撑灵感。灵感是一次性的,工作流才是生产力。
榜单排名
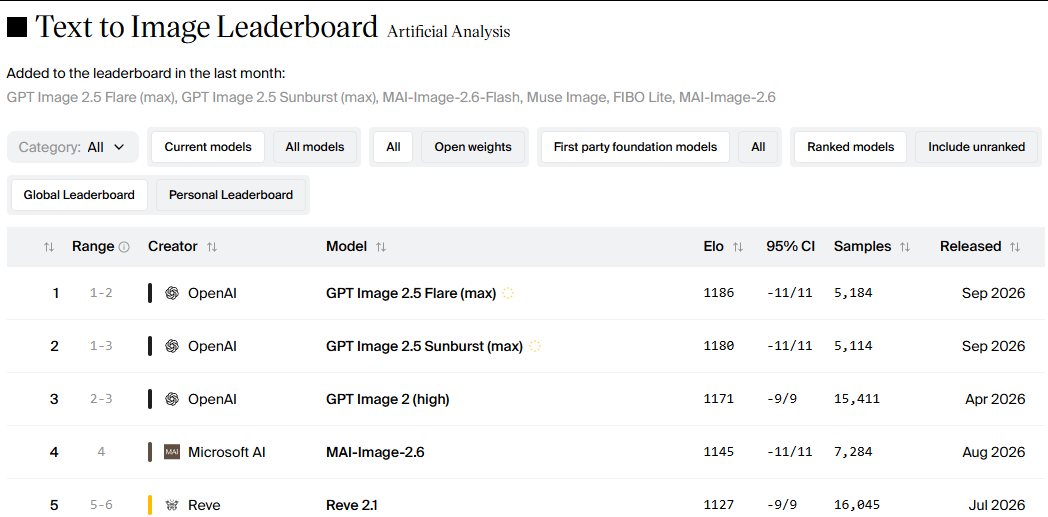
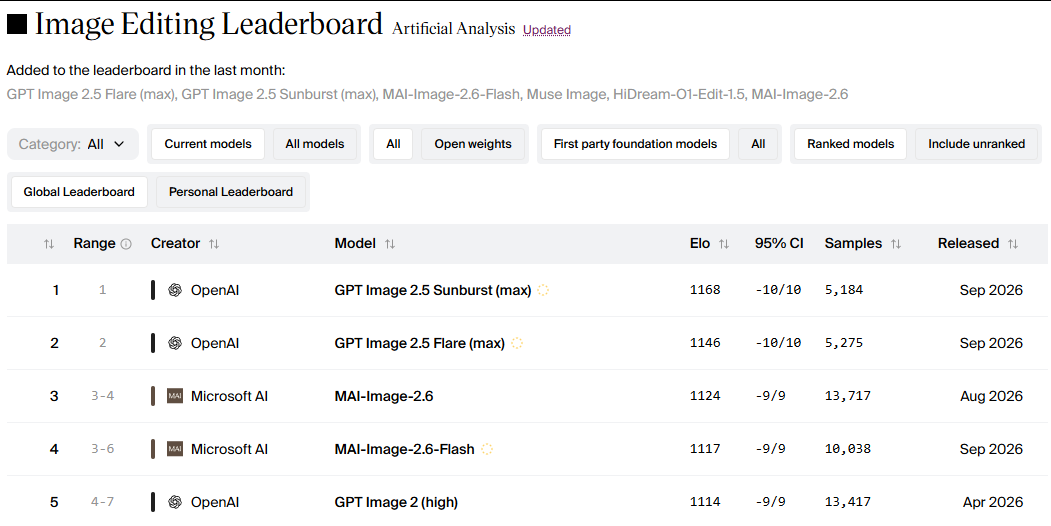
在 Artificial Analysis 的文生图和图像编辑两个榜单中,GPT-Image-2.5 的两款模型分别占据第 1、2 名。
测评方法
本次实测选用 GPT-Image-2.5 Sunburst,对比长期占据 SOTA 位置的上一代模型 GPT-Image-2,看这次的能力提升能否一眼感知。
- 测评目标:一是生成质量与美学,评估模型生成画面的视觉效果,包括提示词遵循、细节表现,以及是否存在伪影或失真;二是指令理解与执行准确性,测试模型对文本或图像指令的理解能力,检查生成结果是否准确反映用户意图。
- 测评工具:均通过 API 在线调试功能生成。
- 测评方法:各案例均使用统一的中/英文提示词和图片进行生成,均取第一次生成结果,评测结果仅供参考。
案例 1:文生图·人像拟真
提示词:
时尚特写大片:
20岁出头亚洲女性,湿发造型黑长发凌乱贴面,晒伤妆(鼻梁脸颊大面积红腮红),光泽唇,真实皮肤质感带雀斑毛孔。
侧身回眸直视镜头,眼神平静微迷离,唇微启。裸肩,怀中紧抱云朵般的巨大白色褶皱织物,下巴轻靠。
周围环绕巨大超现实花卉,前景背景共同框住头部。背景蓝天深绿树叶。
正午硬光,皮肤与花瓣强烈高光,阴影锐利,盛夏午后氛围。
高饱和时尚超现实主义,粉橙蓝绿强对比,35mm胶片颗粒,皮肤细节真实无磨皮。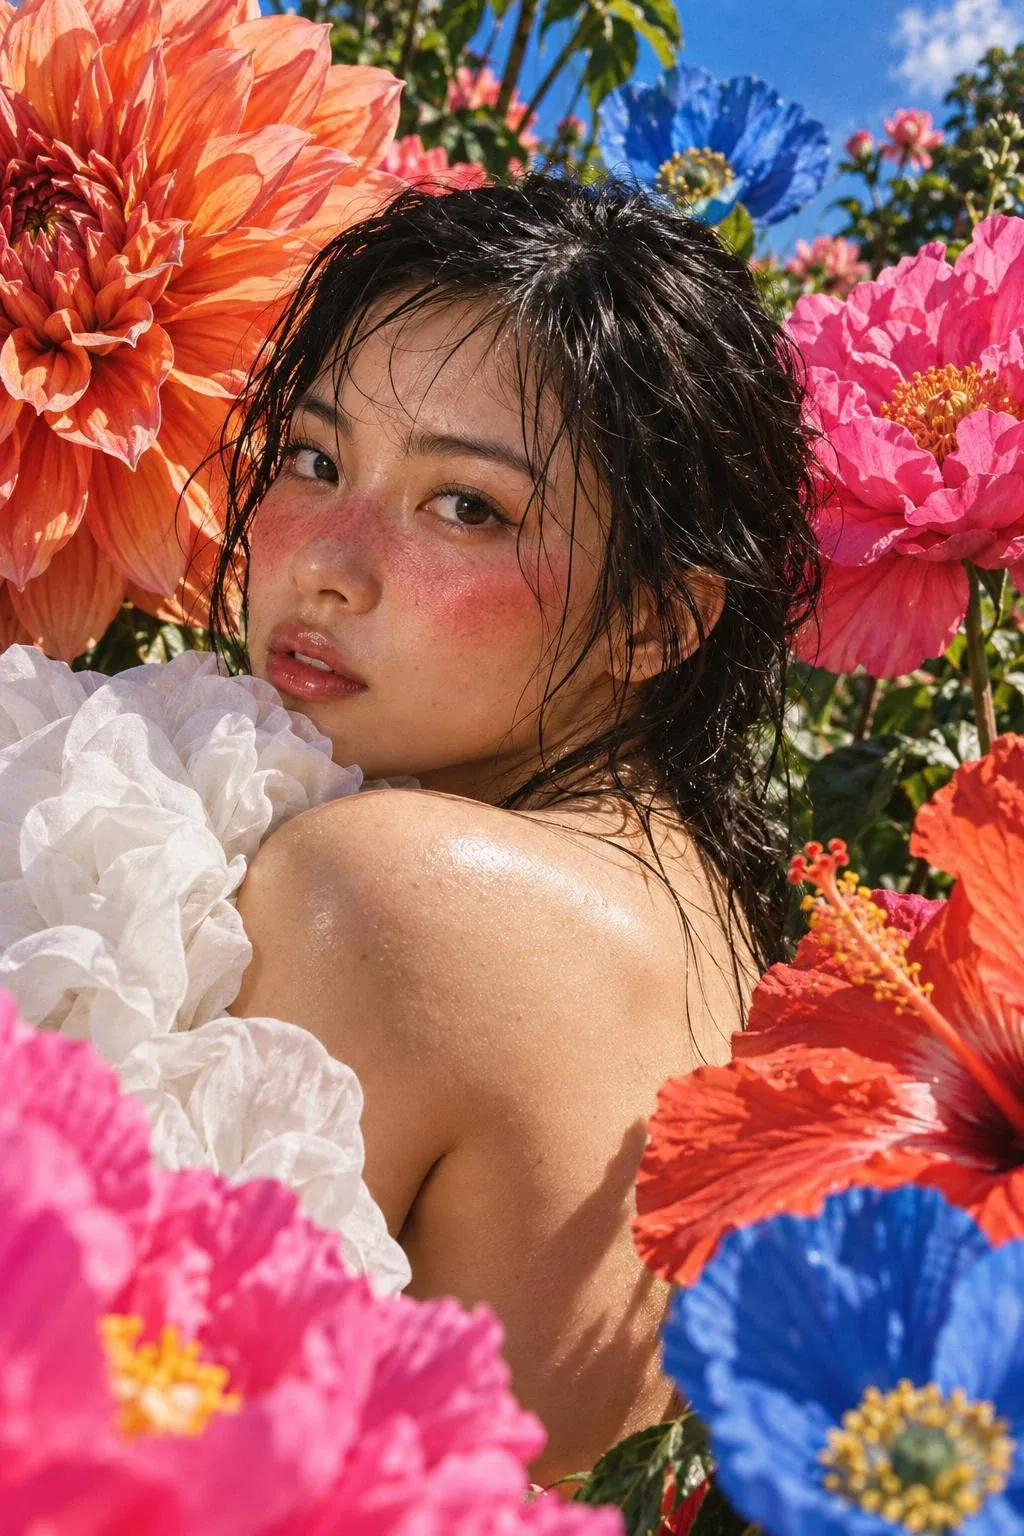
| 模型 | GPT-Image-2.5 Sunburst | GPT-Image-2 |
|---|---|---|
| 评分 | 5/5 | 4.5/5 |
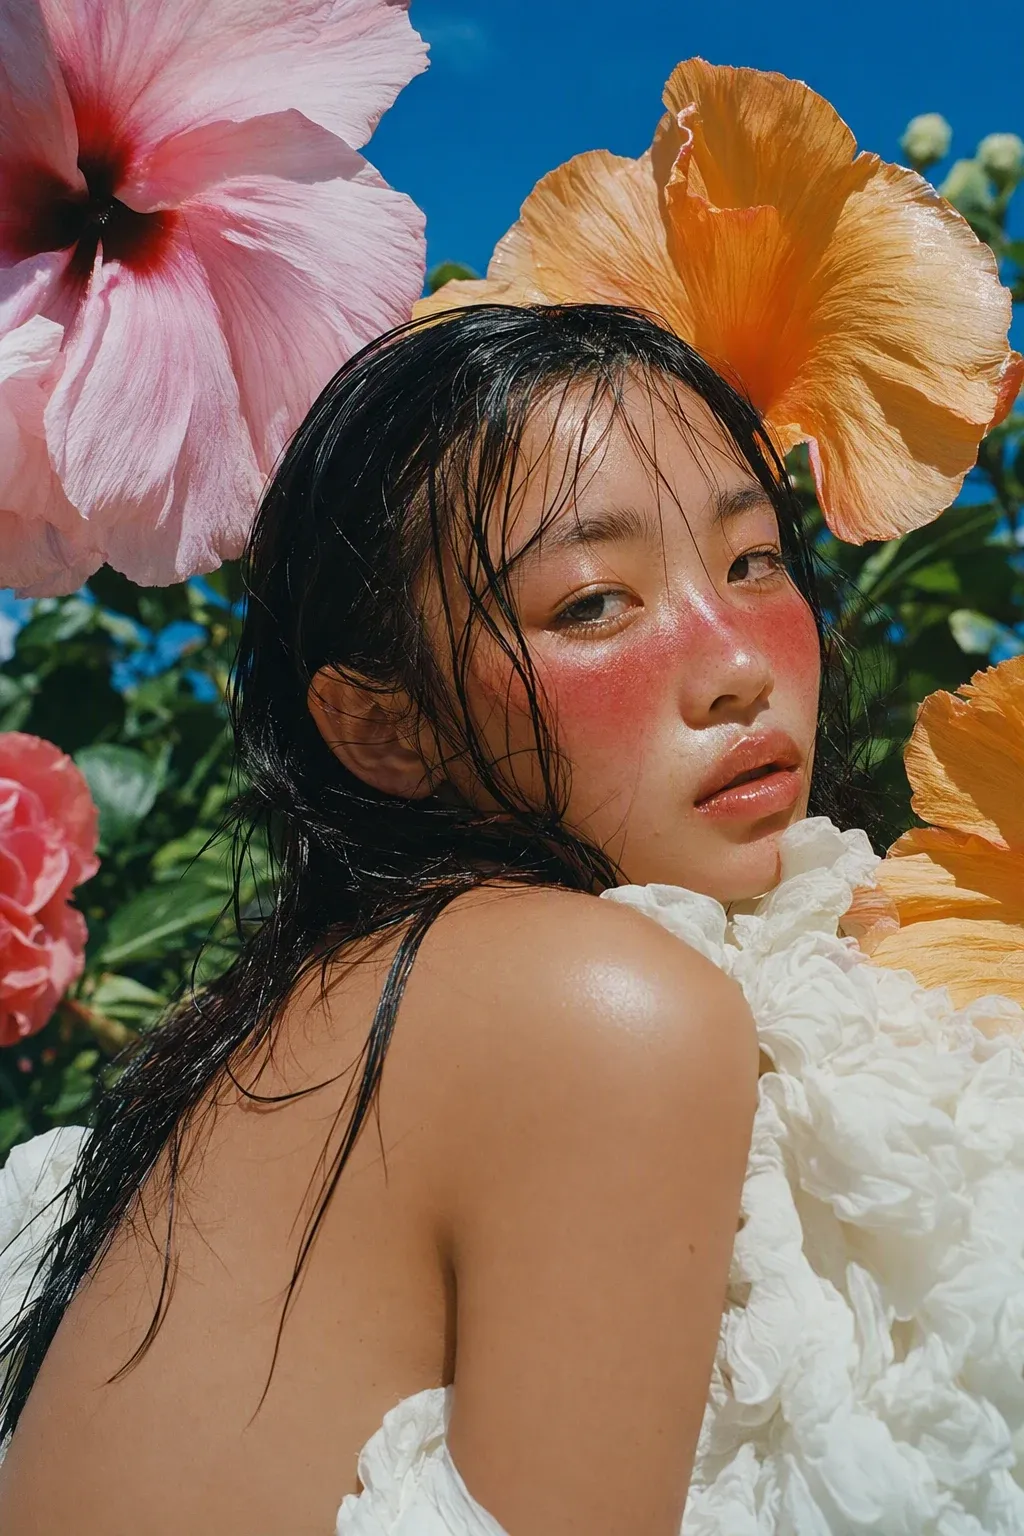
简评:两者都准确遵循了提示词,画面真实、美感在线,主观上喜欢哪张都说得过去。从摄影角度看,2.5 的花卉形态细节更丰富,包含花蕊和前景,景深层次更饱满;光线打在模特背上,也增强了画面的立体感。
案例 2:文生图·风格化摄影
提示词:
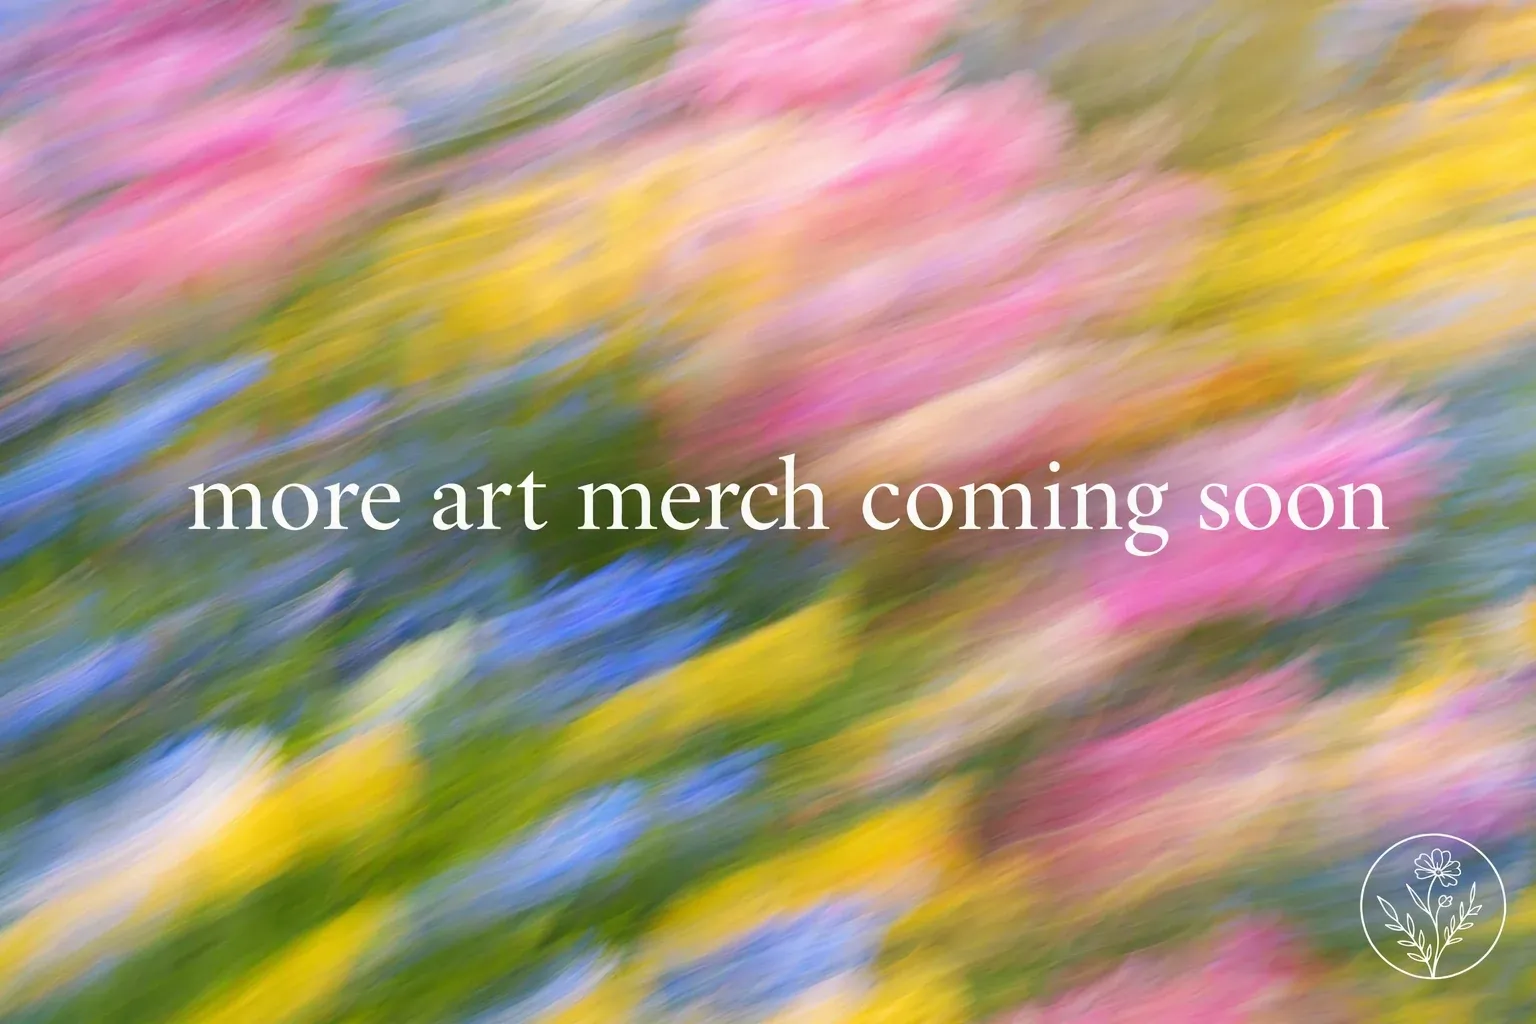
一幅色彩缤纷、抽象风格的花卉摄影作品,带有强烈的运动模糊效果。画面中充满了由各种花朵和茎叶交融晕染而成的粉色、黄色、蓝色与绿色色块。画面正中以白色衬线字体书写着小写文字 “more art merch coming soon”。整体氛围轻盈而富于奇思妙趣。右下角有一个小巧的圆形白色标志。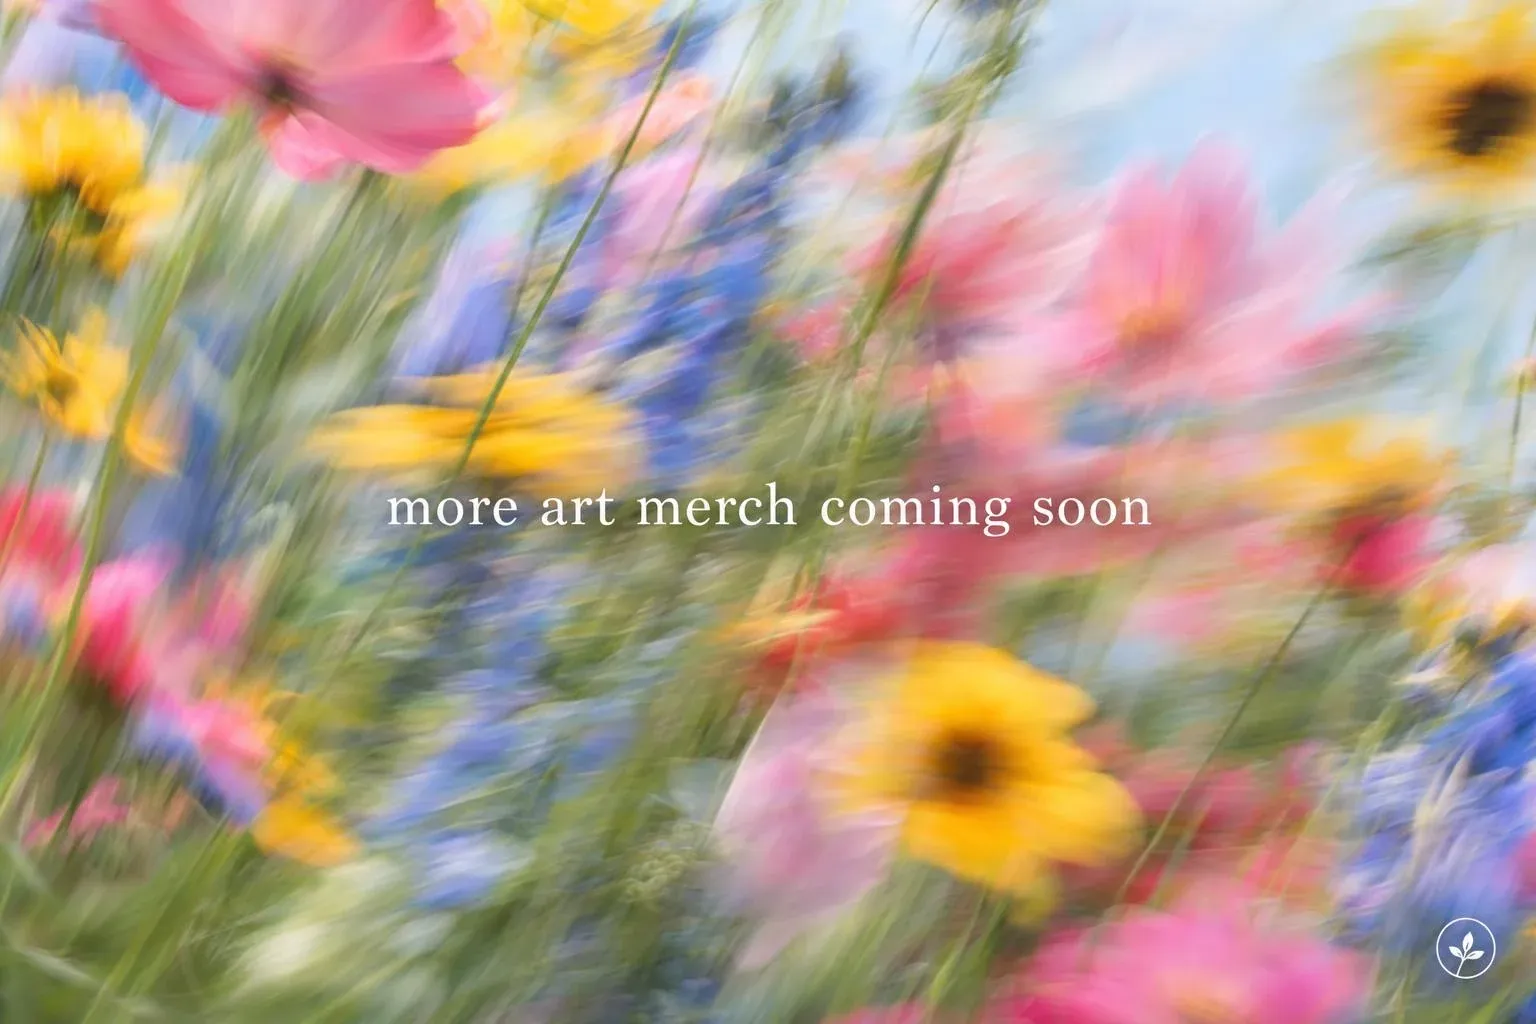
| 模型 | GPT-Image-2.5 Sunburst | GPT-Image-2 |
|---|---|---|
| 评分 | 5/5 | 3/5 |
简评:2.5 胜在两点。一是失焦和慢门效果控制在合理范围,能轻松看出拍摄对象是花卉(GPT-Image-2 的画面显然过于抽象);二是文字和 logo 尺寸克制、不抢戏,排版合理。
案例 3:文生图·科幻场景
提示词:
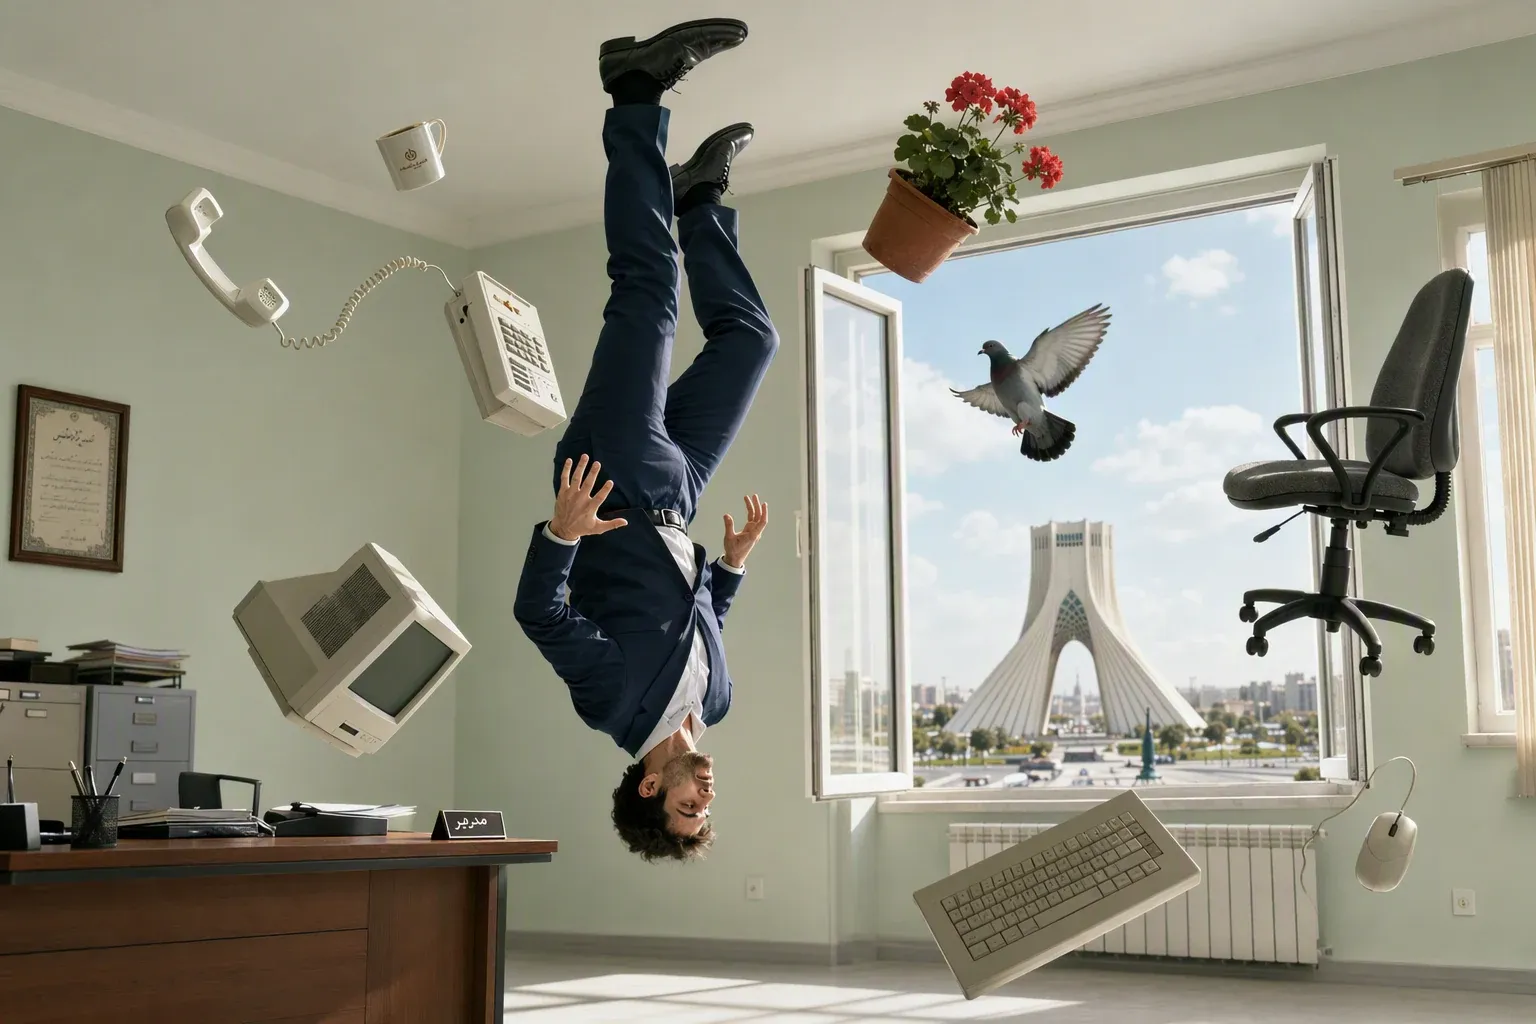
一幅超现实的照片,拍摄于现代办公室内的一名男子,画面呈倒置构图,仿佛重力已经消失。
他身穿一套深蓝色正装西服。他的头部靠近地面,双腿向上延伸至天花板方向。他的双手抬至躯干附近,掌心朝上,身体呈现出自然的紧绷感,仿佛悬停于半空。
办公室环境完全正常且真实——房间内的一切都没有被改变,看起来就是一间典型的日常办公室。室内有一张木质办公桌,墙面漆成非常浅的淡绿色。然而,唯有这名男子及其周围的物体漂浮在半空中,营造出强烈的失重感与一种受控的混乱。
一部带螺旋线的白色台式电话正处于分裂的动态瞬间——听筒朝一个方向飘散,而话机底座则独立漂浮。一只咖啡杯悬停在附近。其他办公用品也在漂浮:一台笨重的老式电脑显示器、配套的老式键盘、一只鼠标,以及一把办公椅——它们以不同的姿态漂移,轻微旋转并倾斜。一盆红色天竺葵花盆栽同样悬浮在空中,增添了一抹鲜明的色彩对比。
窗户敞开着,正午明媚的阳光倾泻入室。窗外,德黑兰自由广场的景色清晰可见。一只鸽子飞入室内,同样悬停于半空,双翅微张,仿佛动作被定格。光线明亮、高调而干净,呈现极简美学风格。色彩基调柔和、略微降低饱和度,富有电影感。整体氛围强调超现实主义、失重感,被定格的瞬间。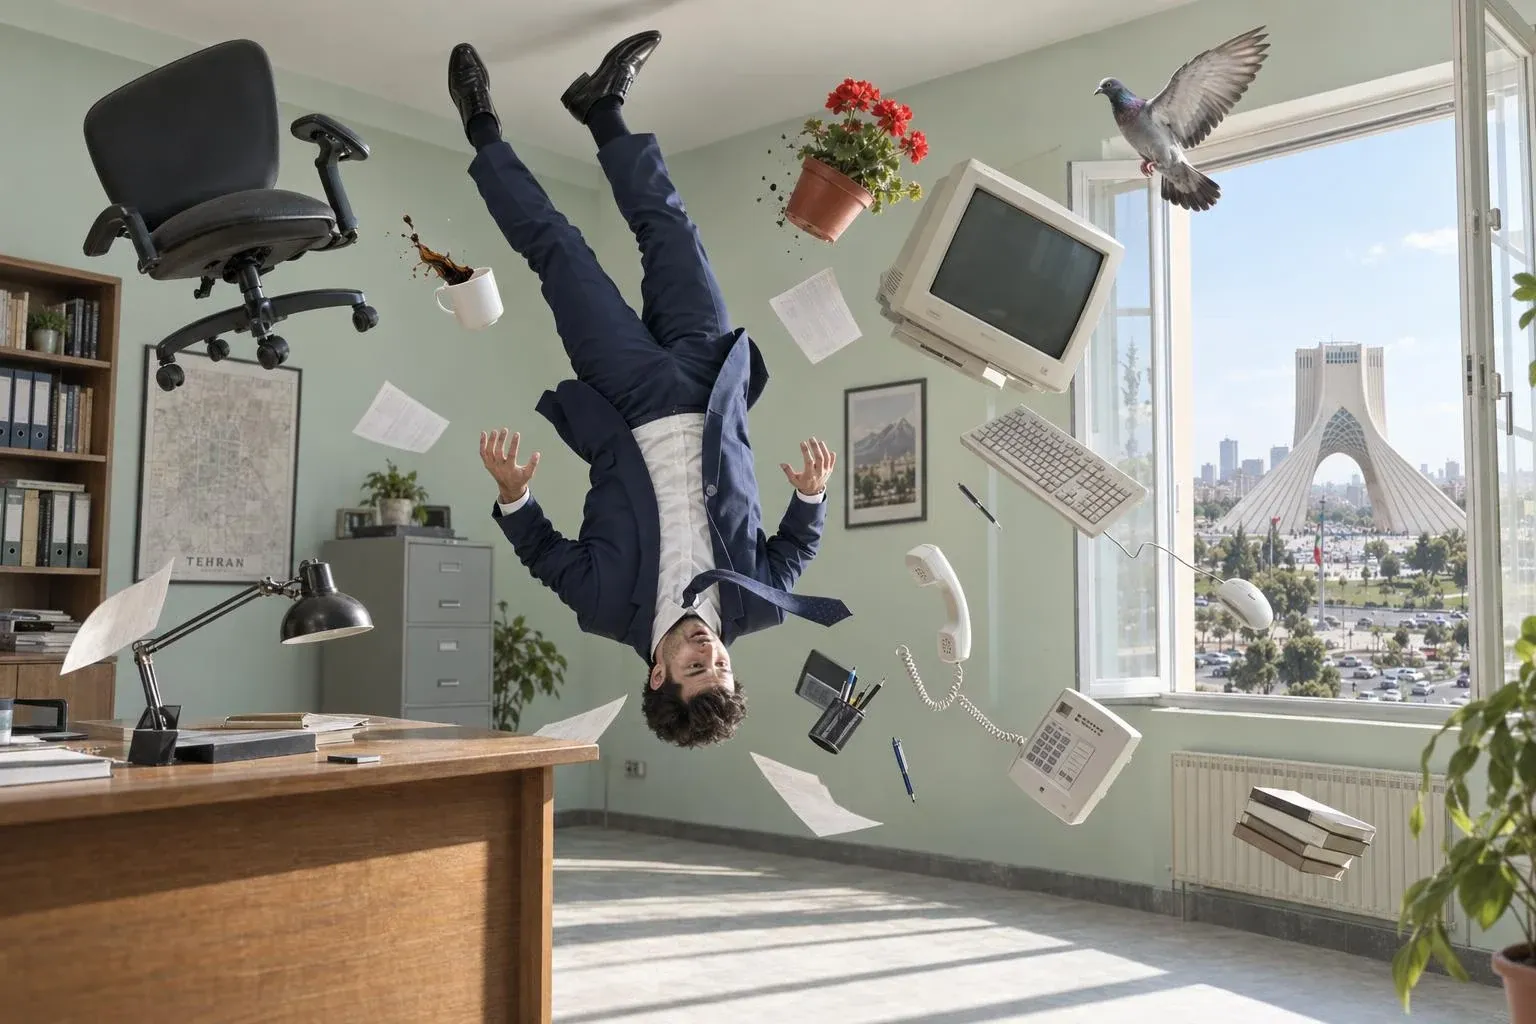
| 模型 | GPT-Image-2.5 Sunburst | GPT-Image-2 |
|---|---|---|
| 评分 | 4.5/5 | 4/5 |
简评:一眼就能看出两张图出自同一模型系列,色调、空间布局和构图高度相似。2.5 的瑕疵在于:左上角的办公椅有扭曲变形,电话线不连贯,有断开感。
案例 4:文生图·当代绘画
提示词:
一幅富有表现力的油画肖像:一位年轻女子越过裸露的肩头直视观者,特写构图。肤色白皙、肌理分明,可见雀斑,脸颊与鼻尖呈现自然的红晕,灰绿色的眼睛,浓密的天然眉形。她的神情——目光低垂,端庄含蓄,睫毛投下柔和的阴影。她的头发整体向后梳得油光服帖,露出整张脸庞。她身穿一件炭灰色西装外套,锁骨裸露。
背景:鼠尾草绿/橄榄绿背景布,可见绘画性的笔触肌理,无任何景物。柔和的漫射自然光从左前方照入,在面部形成轻柔的造型过渡,没有生硬的阴影。
风格:当代表现主义油画,厚涂笔触清晰可见,头发与织物处是粗犷的有方向性的笔触,手绘帆布质感,柔和的莫兰迪式大地色系(白、黑、鼠尾草绿、带红橙点缀的暖肤色),博物馆级肖像画,杰作。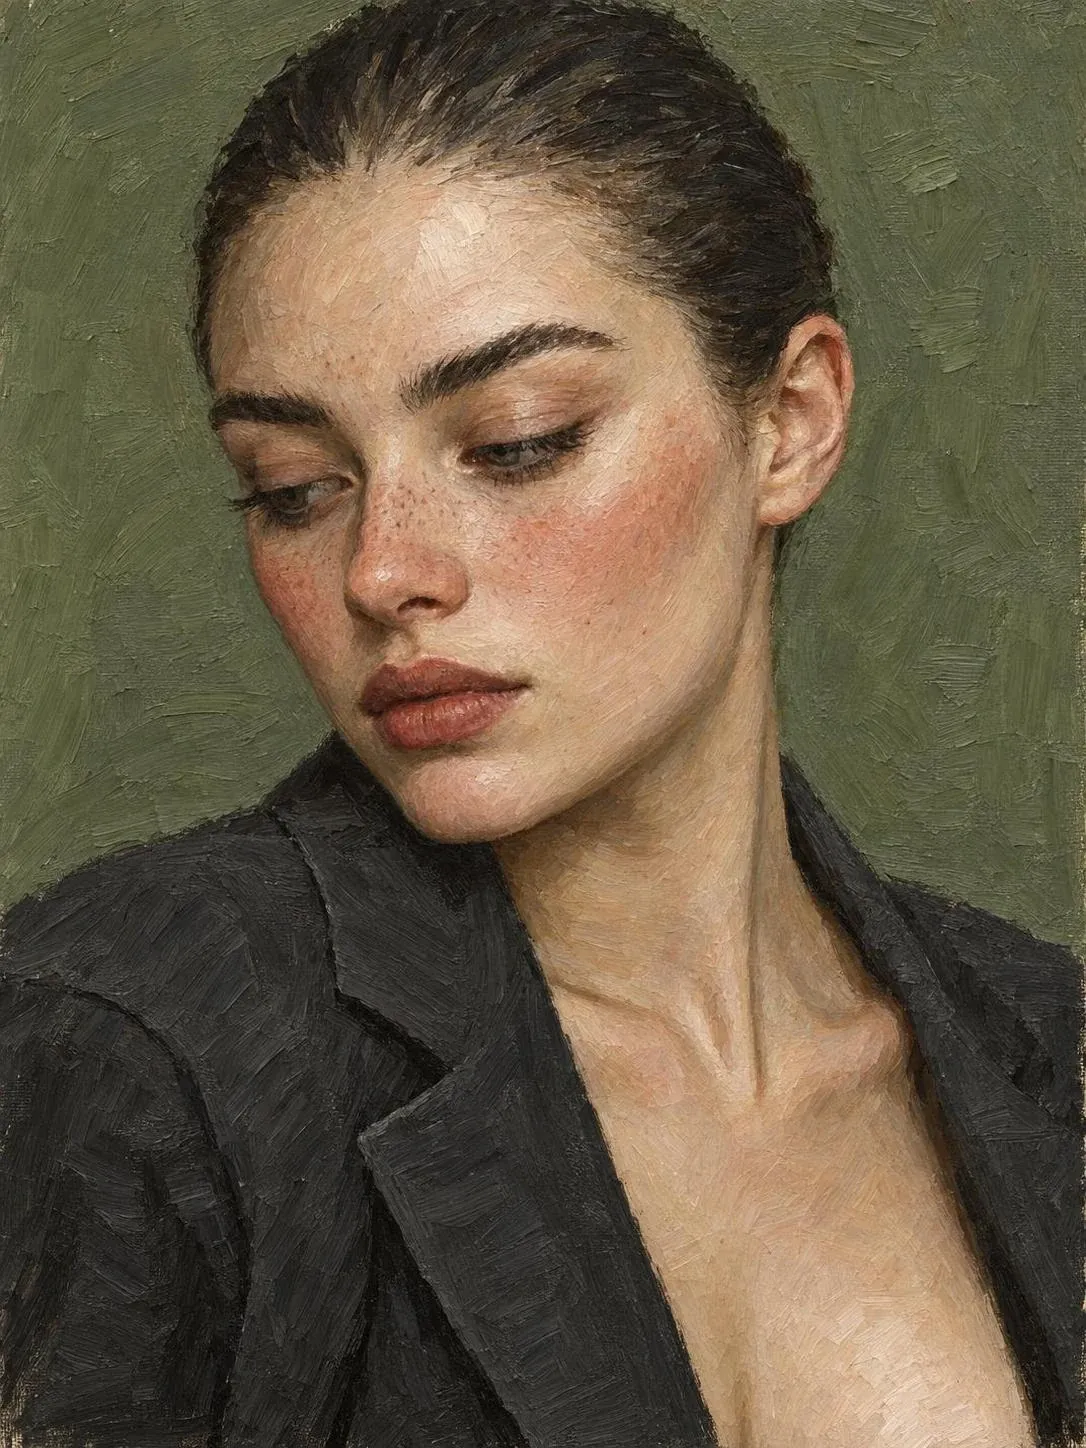
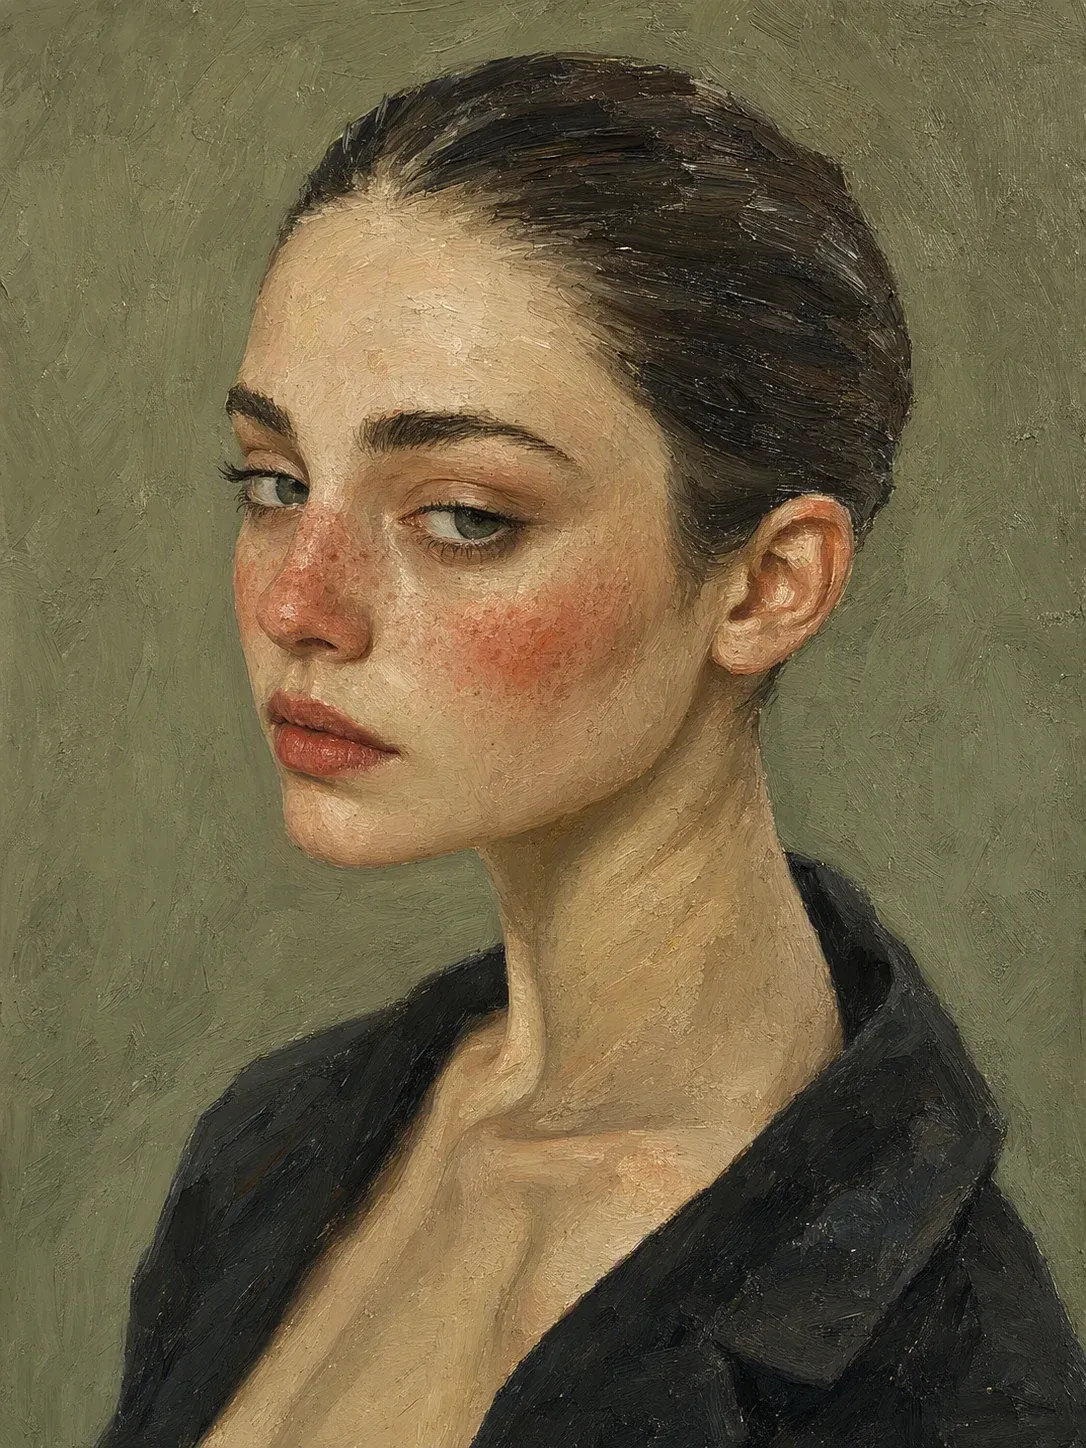
| 模型 | GPT-Image-2.5 Sunburst | GPT-Image-2 |
|---|---|---|
| 评分 | 4/5 | 5/5 |
简评:两幅画最明显的区别在于女子的视线朝向。提示词原文是“一位年轻女子越过裸露的肩头直视观者”,显然 GPT-Image-2 的还原更准确。此外,在女子的形象、神态以及整体笔触与色调美感上,两款模型都没有明显问题。
案例 5:文生图·文字渲染
提示词(原文):
A photorealistic overhead shot of an open premium design magazine lying flat on a minimalist light-oak desk, soft natural window light from the left, a matte ceramic coffee cup and a brass pen resting nearby, shallow depth of field, editorial photography.
The magazine’s two-page spread displays a full article, typeset in a clean modern editorial layout (large display title, pull-quote, body columns, page numbers “38 · 39”). ALL TEXT MUST BE RENDERED EXACTLY AS WRITTEN BELOW, correctly spelled, no gibberish, no missing or fused strokes:
LEFT PAGE — header label in small caps gray: “封面专题 · COVER STORY /
深度拆解 · DEEP DIVE” Title block, bold serif Chinese, two lines: 「GPT-Image-2.5 深度拆解: 30亿张图/周的生意,OpenAI 为什么突然把「速度」当主角?」
Directly beneath, English title in lighter italic sans-serif:
“GPT-Image-2.5 Deep Dive: The 3-Billion-Images-a-Week Business — Why Did OpenAI Suddenly Make Speed the Star?”
A red pull-quote strip: 「从『谁画得更惊艳』转向『谁能让创作跟得上思维』」
BODY TEXT in three bilingual column pairs (Chinese paragraph followed by its English translation in smaller gray type):
Paragraph 1: “2026年9月8日,发布GPT-6 Astra仅仅5天后,OpenAI又甩出 ChatGPT Images 2.5:生成延迟比上代砍掉最多50%,但API单价一分不涨。”
Translation 1: “On September 8, 2026 — just five days after GPT-6 Astra — OpenAI unveiled ChatGPT Images 2.5: up to 50% lower generation latency, with API pricing completely unchanged.”
Paragraph 2: “表面看这是一次常规的版本号迭代,实际上藏着一个信号—— 图像模型的军备竞赛,正在从『谁画得更惊艳』转向『谁能让创作跟得上思维』。”
Translation 2: “On the surface, a routine version bump. In fact, a signal: the image-model arms race is shifting from ‘who draws better’ to ‘who keeps up with your thinking’.”
Paragraph 3: “本文将拆解Images 2.5的三大真实升级、Flare与Sunburst的 双子星布局,以及为什么这次『快』比『美』更值得聊。”
Translation 3: “This article breaks down its three real upgrades, the Flare & Sunburst twin-star lineup, and why ‘fast’ beats ‘beautiful’ this time.”
RIGHT PAGE — a large editorial illustration occupies the top half:
a stylized speedometer whose needle points past the red zone, rendered in flat magazine illustration style with the same red accent color as the pull-quote; caption beneath it in tiny type: “图1:速度计 · Fig.1 The Speedometer”. The bottom half continues the body columns. Footer:
“302.AI 基准实验室 · Benchmark Lab · 2026年9月”.
Typography: Chinese in a Song-style serif (思源宋体 feel), English in Inter; crisp, print-quality glyph rendering at legible small sizes; Paper has a subtle matte sheen where the window light crosses it.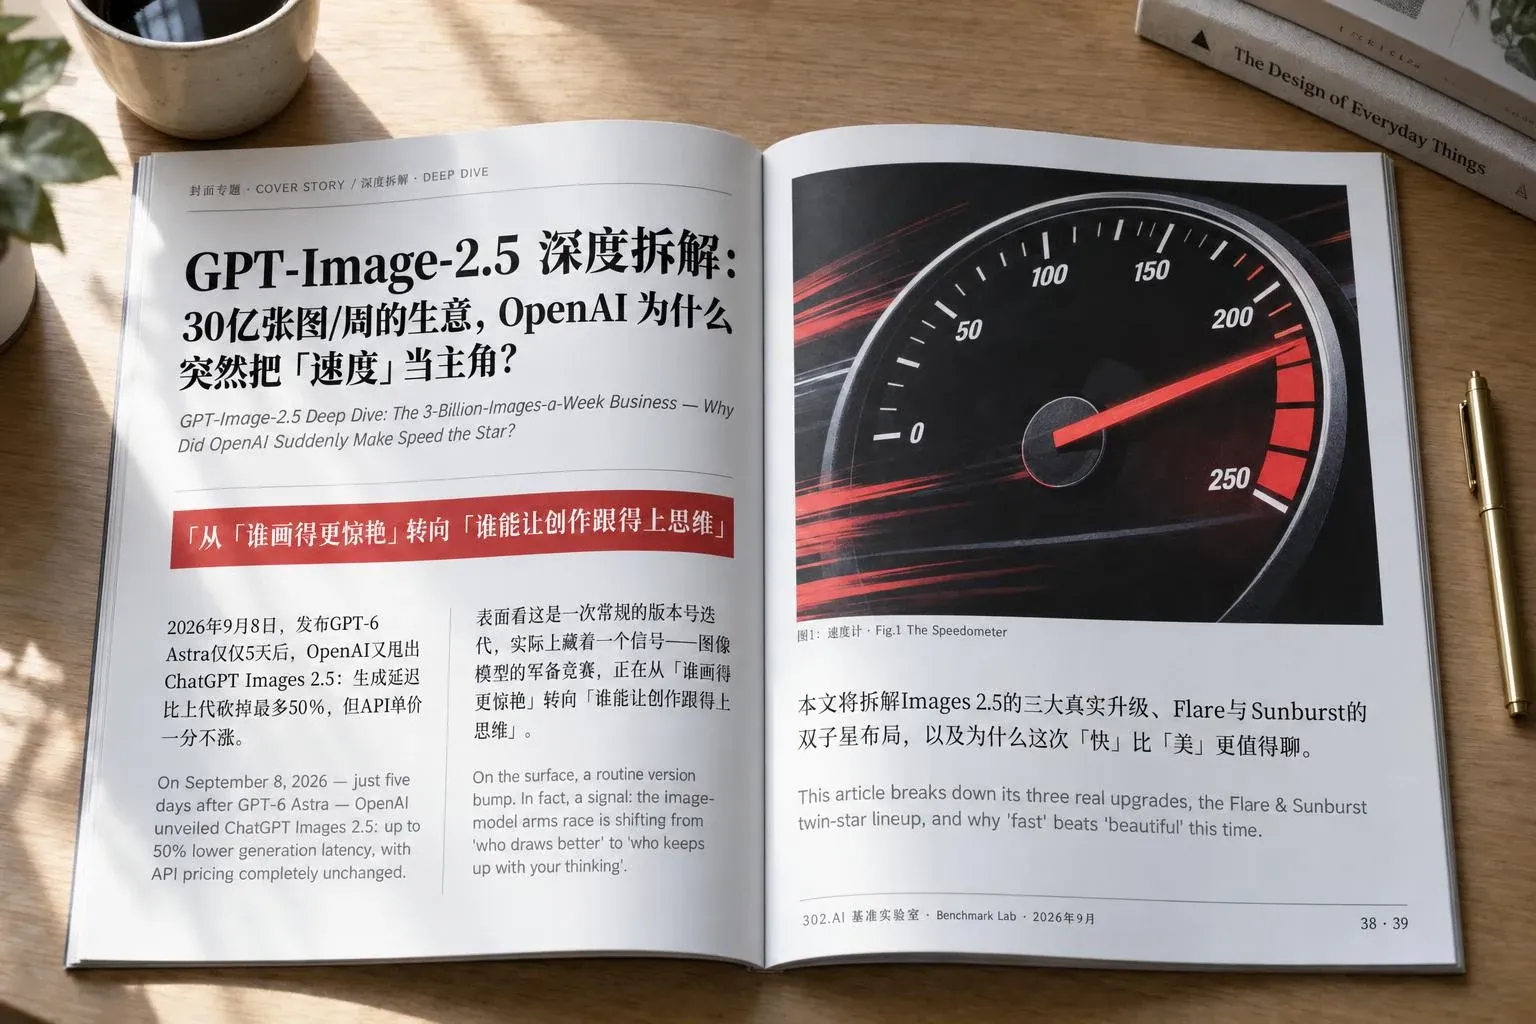
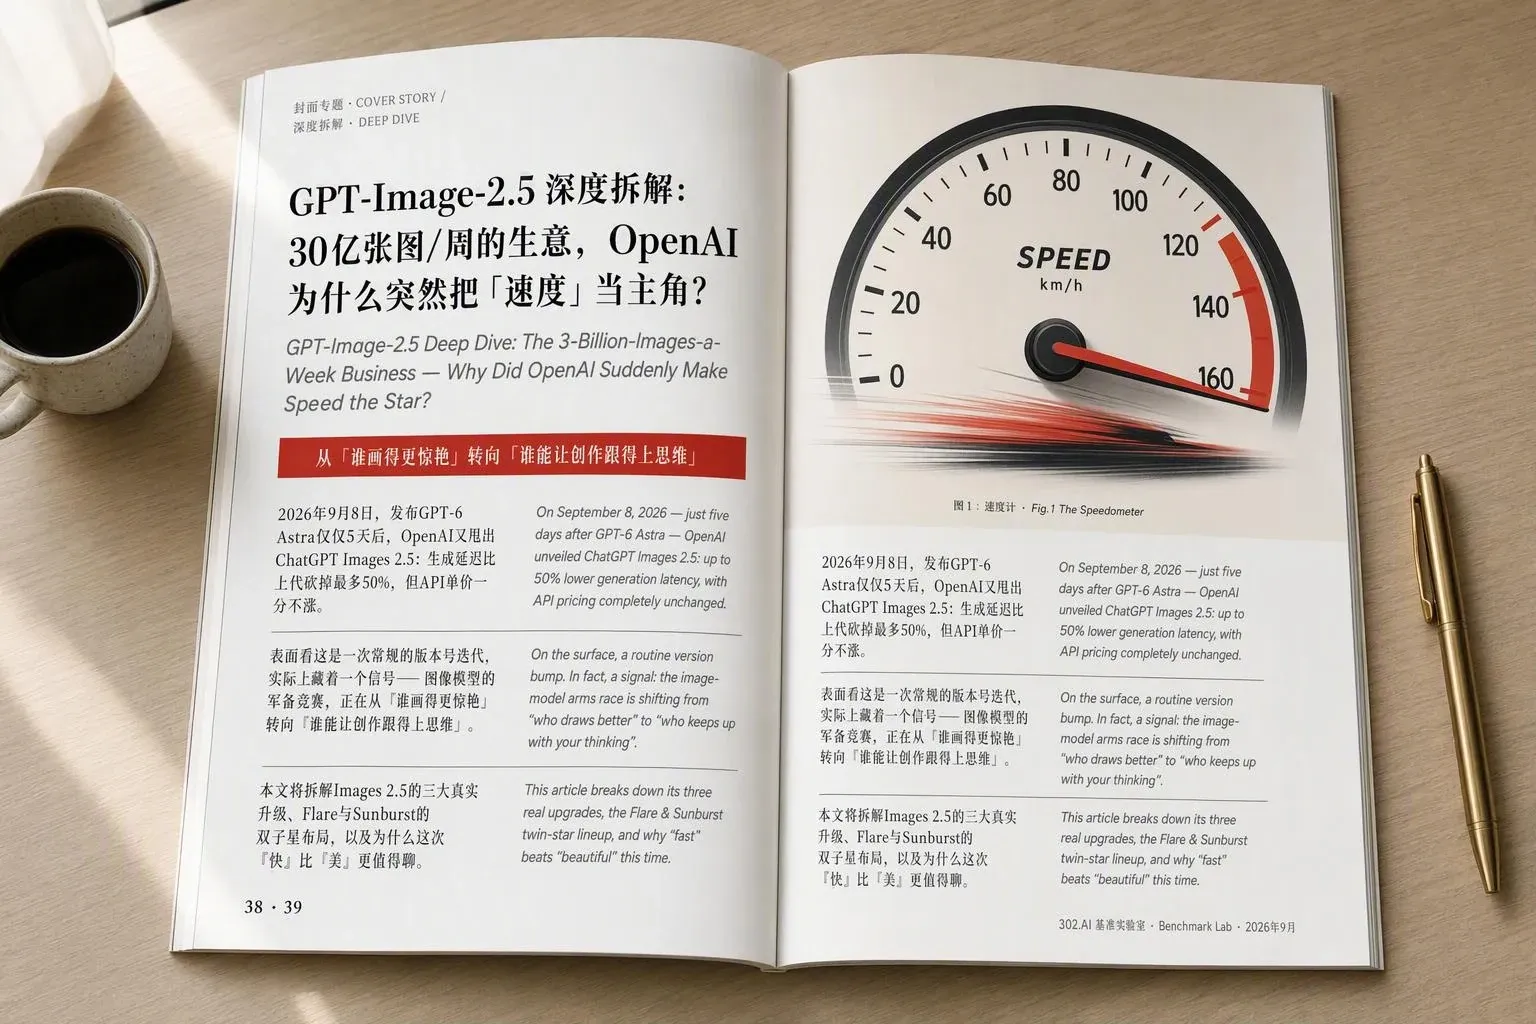
| 模型 | GPT-Image-2.5 Sunburst | GPT-Image-2 |
|---|---|---|
| 评分 | 5/5 | 3.5/5 |
简评:2.5 胜出。文字方面,两组结果均未出现乱码或模糊。2.5 胜在整体画面真实度更高,光影和质感更接近实拍效果;杂志图文排版合理,页眉页脚布局得当。GPT-Image-2 生成的杂志左右两页文字内容重复,部分排版不符合阅读逻辑。
案例 6:多图编辑·电商海报
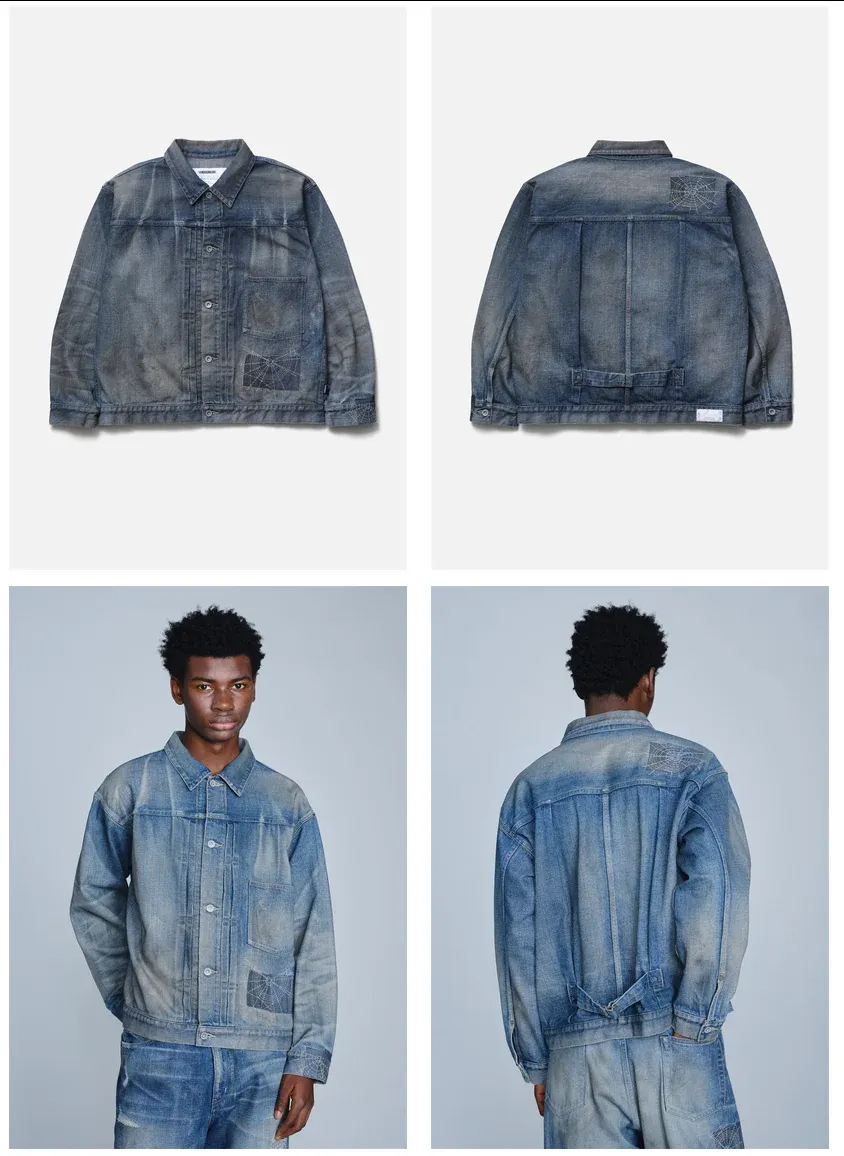
提示词:
单页电商产品详情页设计,美式复古工装(workwear heritage)美学风格,基于4张参考图。牛仔夹克的款式设计必须与参考照片保持100%一致——同样的水洗靛蓝丹宁、同样的蜘蛛网刺绣贴片、同样的后背束带下摆、同样的银色纽扣——并沿用参考图中的同一位模特。不得改动夹克的设计或模特的身份特征。
版式布局(竖版电商页面,3:4比例):
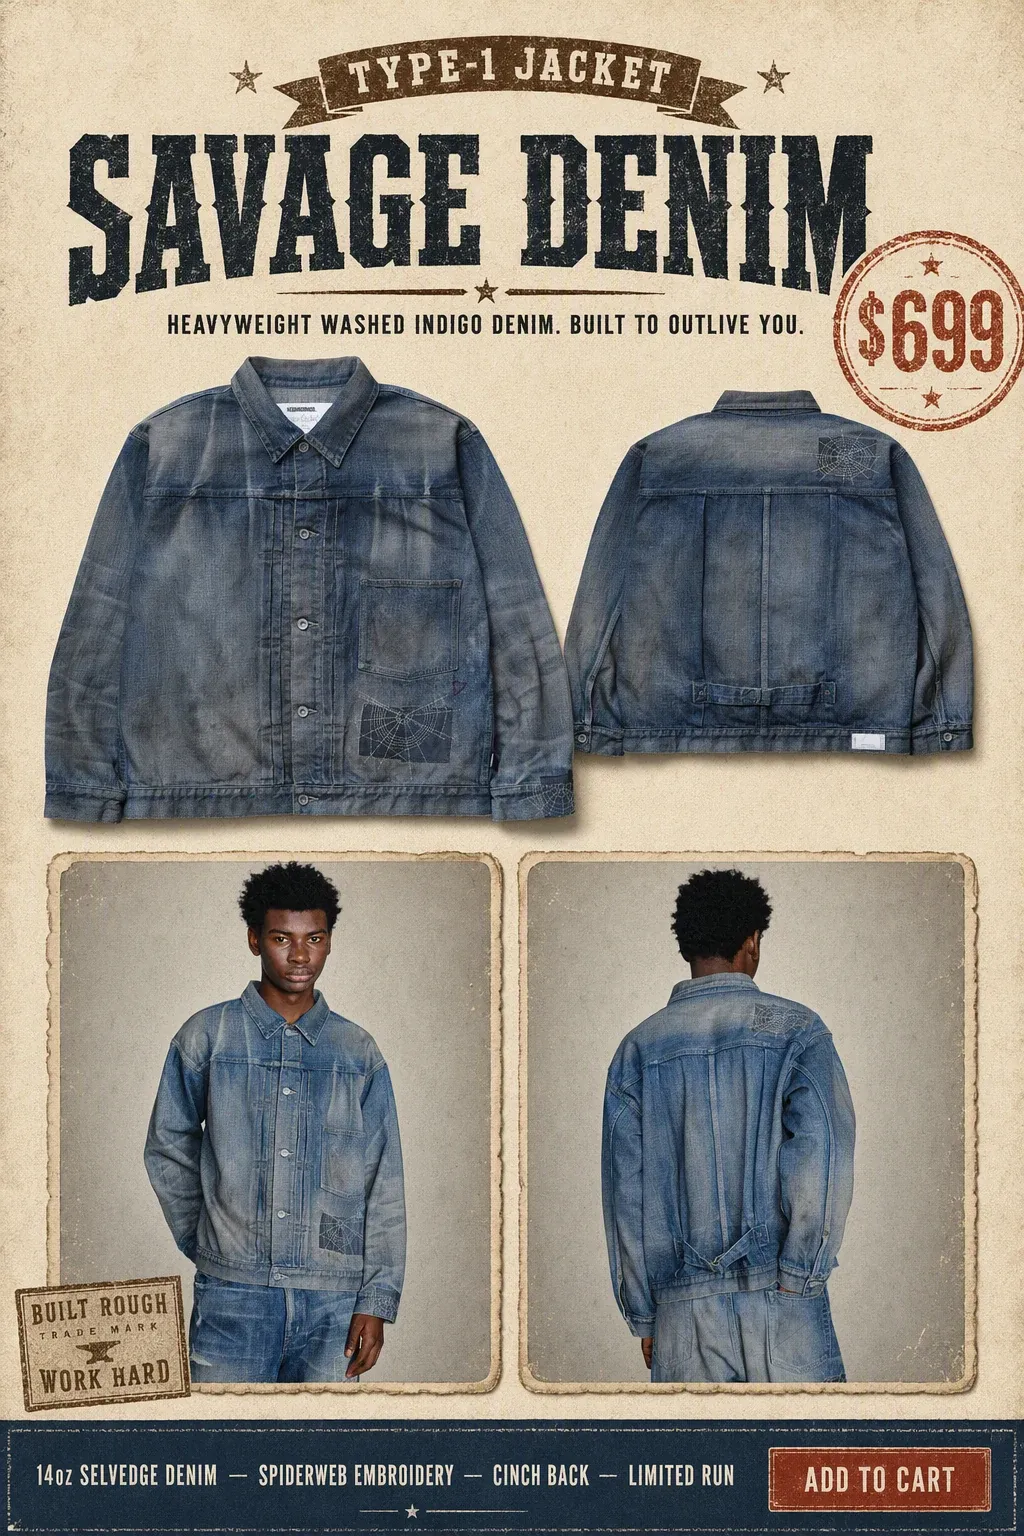
顶部主视觉区:奶油色/米白色纸质纹理背景。大号复古标题使用粗体西部板状衬线字体:”SAVAGE DENIM”,其上方有一条较小的拱形横幅,写着 “TYPE-1 JACKET”,另有一枚做旧橡胶印章风格的徽章:砖红色圆形内的 “$699″。副标语使用窄体无衬线字体:”Heavyweight washed indigo denim. Built to outlive you.”
中部:展示夹克的正面与背面——正面视图较大,置于左侧;背面视图略小,置于右侧;两者均抠图呈现,在奶油色背景上带有柔和的投影。
下半部分:两张模特照并排放置在复古相框内,纸边略微撕裂——正面姿势与背面姿势——并施加微妙的暖调胶片颗粒处理。
底栏:深靛蓝色横条配白色字体:”14oz Selvedge Denim — Spiderweb Embroidery — Cinch Back — Limited Run”,以及一个砖红色小按钮:”ADD TO CART”。
色彩基调:奶油色 #F2EBDC、丹宁靛蓝 #2E4A66、砖红色 #B3402A、墨黑色 #1A1A1A、褪色烟草棕作为点缀色。
字体风格:美式复古招牌风格——标题用粗体板状衬线/西部展示字体,正文用窄体无衬线字体,标签用带字距的小型大写字母,所有字体带有轻微的油墨洇渗和凸版印刷质感。做旧印章与工会标签风格徽章作为装饰元素。
质量要求:专业电商版式设计,网格对齐干净利落,印刷海报级品质,复古美式工装氛围(1950–70年代海报的感觉),无水印,无多余产品,所有英文文字拼写正确且清晰可读。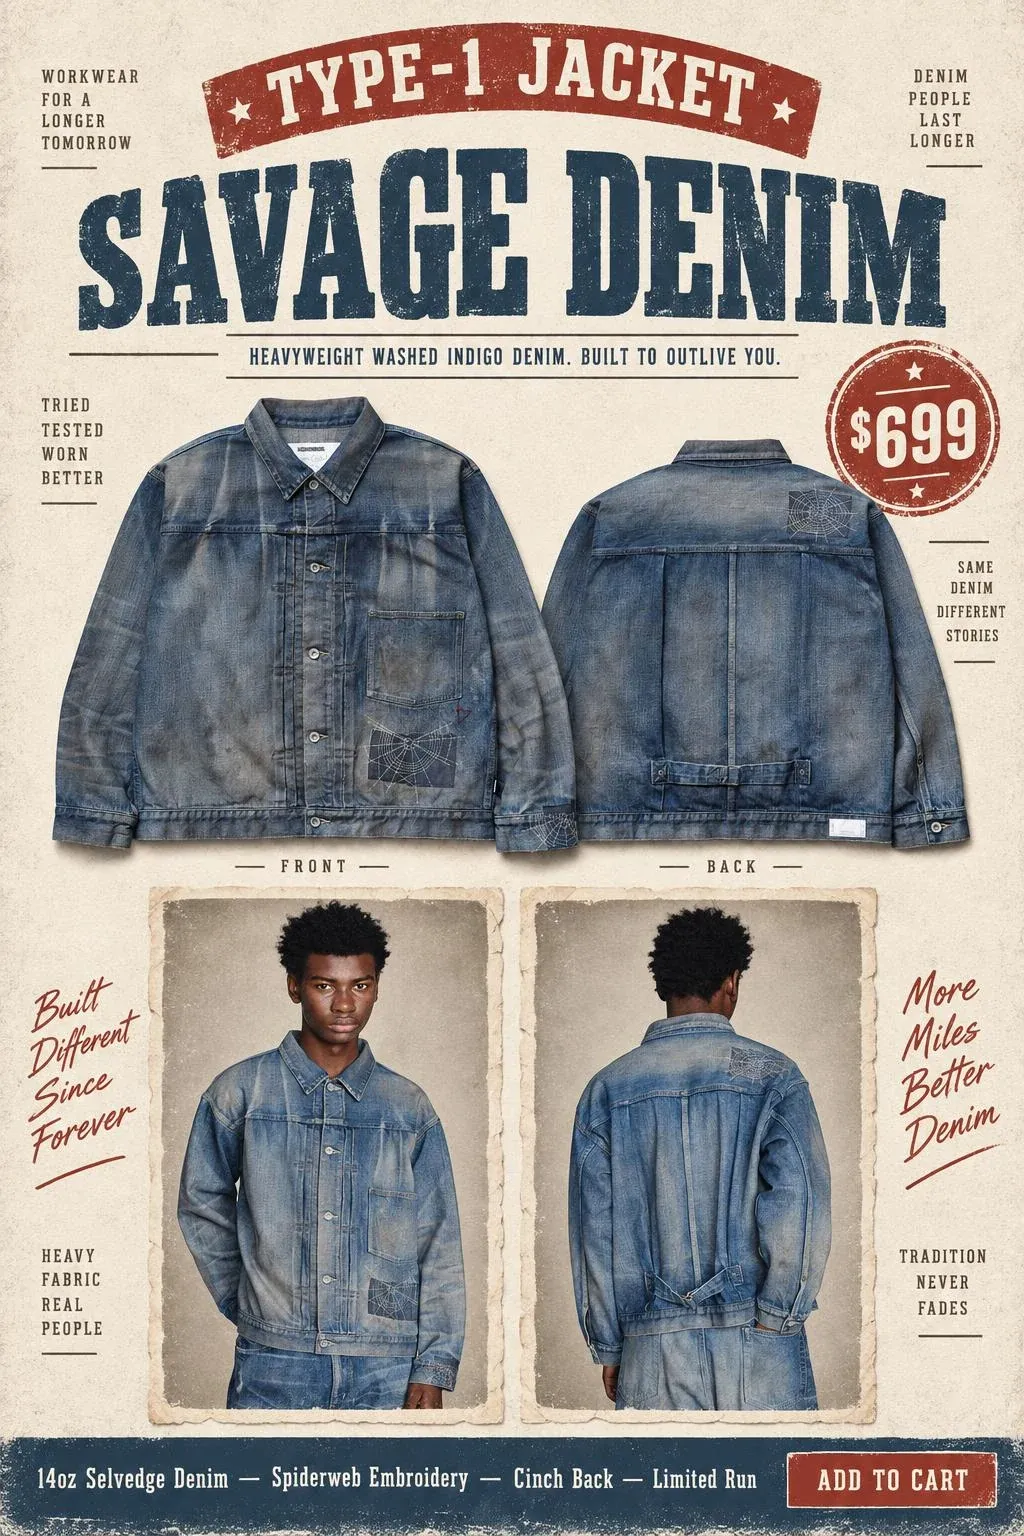
| 模型 | GPT-Image-2.5 Sunburst | GPT-Image-2 |
|---|---|---|
| 评分 | 5/5 | 4/5 |
简评:两者抠图都准确干净,排版布局相近。GPT-Image-2 的排版有明显的失衡问题:标题 SAVAGE DENIM 不居中,左右边距不一致;服装正、背面两张图大小差距过大。2.5 海报的色彩搭配、做旧细节和丰富的装饰性文字,都达到了可以直接交付使用的水平。
案例 7:单图生图·分镜绘制
提示词:
单一画布上的 2×2 网格,每个格子大小相同,格子之间由细白色间距分隔。四个格子中的主体完全一致。 角色锁定:同一位阿森纳球员——红白主场球衣(红色衣身、白色袖子、”Emirates FLY BETTER” 赞助商字样、阿迪达斯标志、俱乐部徽章、袖口欧冠星球章)、白色短裤、红色球袜,深色长发向后梳拢并微微飘动,左臂有纹身,体格健硕、肤色偏白。场景锁定:夜场足球比赛,泛光灯照亮的绿色草坪,看台上虚化的暗色人群,橙白色 LED 广告板,官方欧冠星球用球(白色球体配黑色星形图案)。照片级写实的职业体育摄影,高速快门凝固动作,浅景深,轻微低机位仰拍,色彩饱和。
将参考图作为图1。
图2:基于参考图:同一位阿森纳球员刚刚完成停球——皮球从他大腿处落下,现已静止在他支撑脚正前方的草地上。他保持直立、姿态平衡的运动站姿,双脚踩在草坪上,抬头观察前方场上局势,目光聚焦远处,双臂微张保持平衡。同样的角色、同样的球衣、同样的泛光灯夜场球场、同样的浅景深。照片级写实体育摄影,全景,动感而克制的瞬间。
图3:同一位阿森纳球员正全力加速向前冲刺,带球推进——足球位于他右脚鞋前半步,深色长发因速度向后飞扬,身体前倾呈驱进式奔跑。他身后,一名身穿宝蓝色配白色点缀球衣的切尔西防守球员正全力伸体追赶,手臂抓向他的肩膀,略微失焦。同样的泛光灯夜场球场与虚化人群,背景带运动模糊,焦点清晰锁定阿森纳球员。照片级写实体育摄影,跟拍镜头质感,低机位。
图4:同一位阿森纳球员已摆脱防守球员并正在射门——经典射门姿态:左腿支撑踩在球侧,右腿摆动完成击球,双臂张开保持平衡,视线锁定目标。欧冠星球球刚刚离开他的鞋面,带有轻微运动模糊。蓝衣切尔西防守球员落后一步,重心不稳,铲抢为时已晚,部分虚化。照片级写实体育摄影,富有戏剧张力的低机位仰拍,高速快门凝固瞬间,皮球与摆动腿上带有细腻的运动模糊。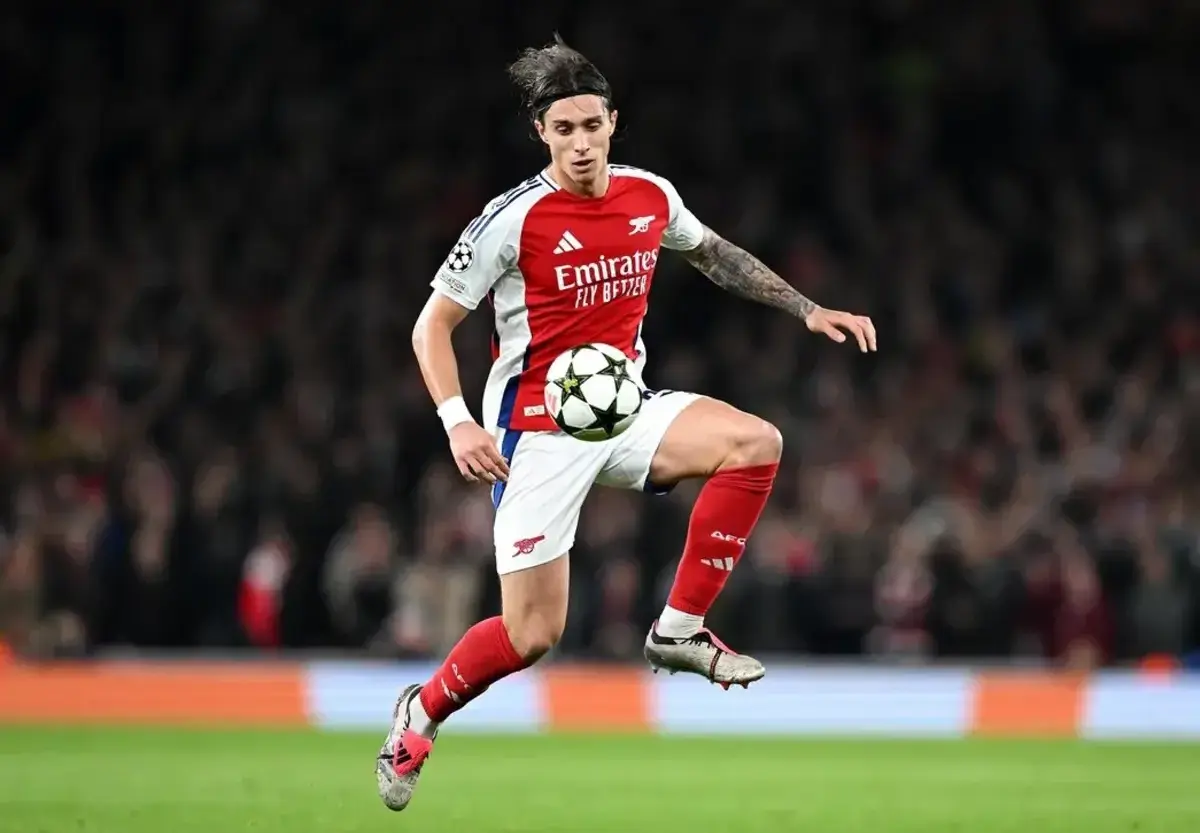
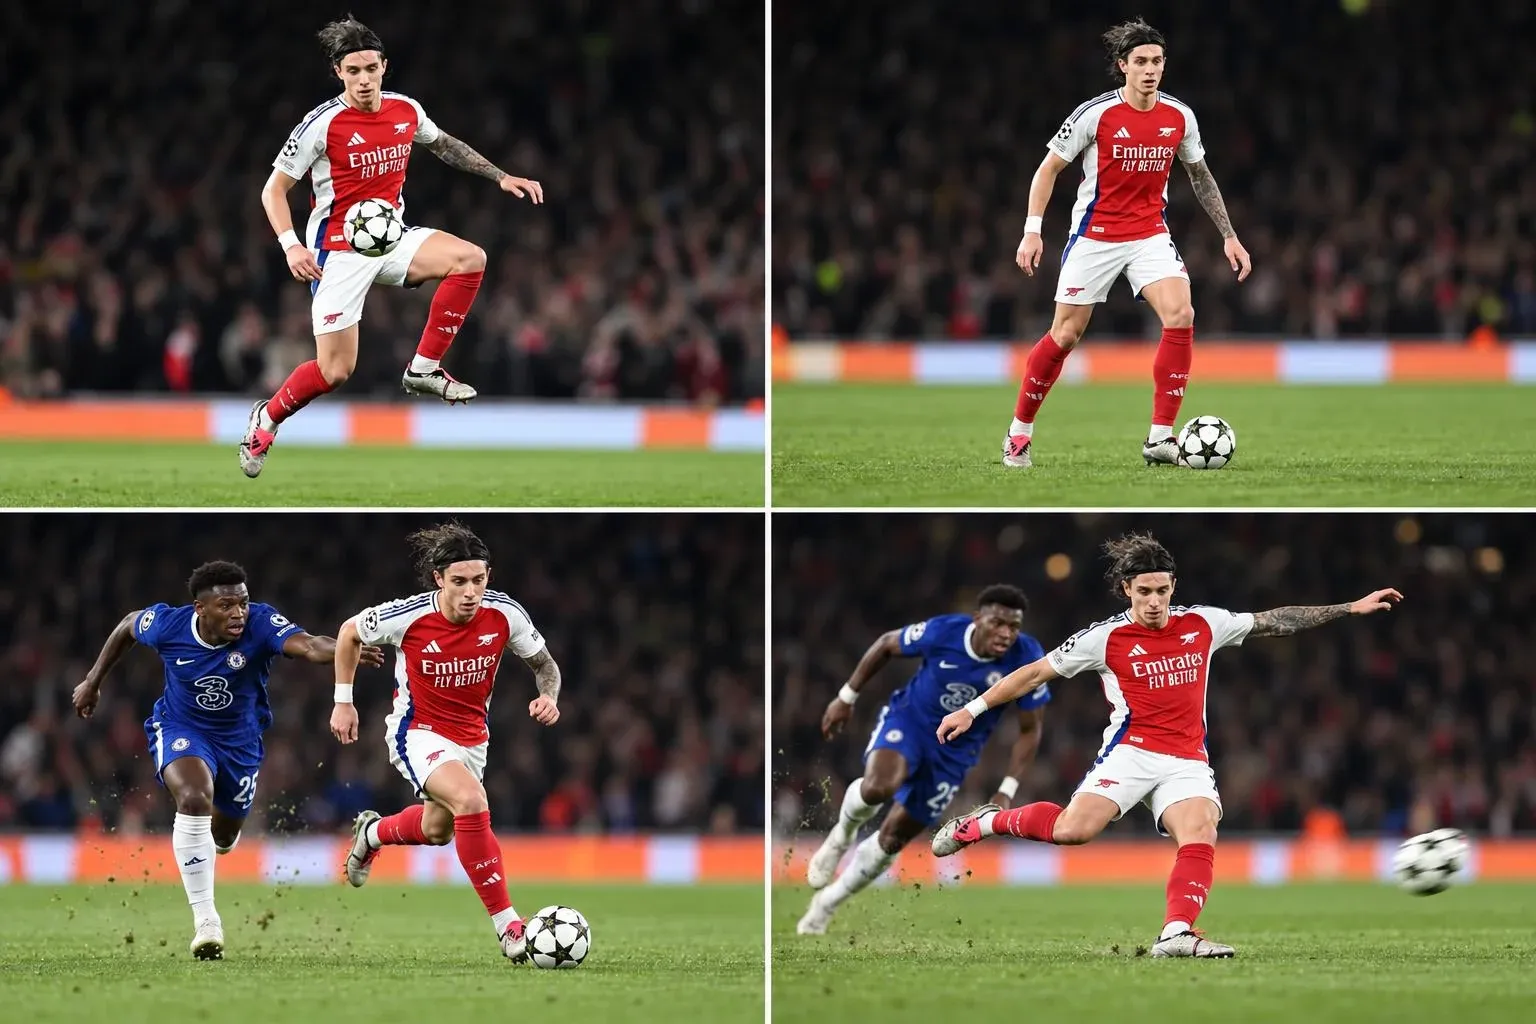
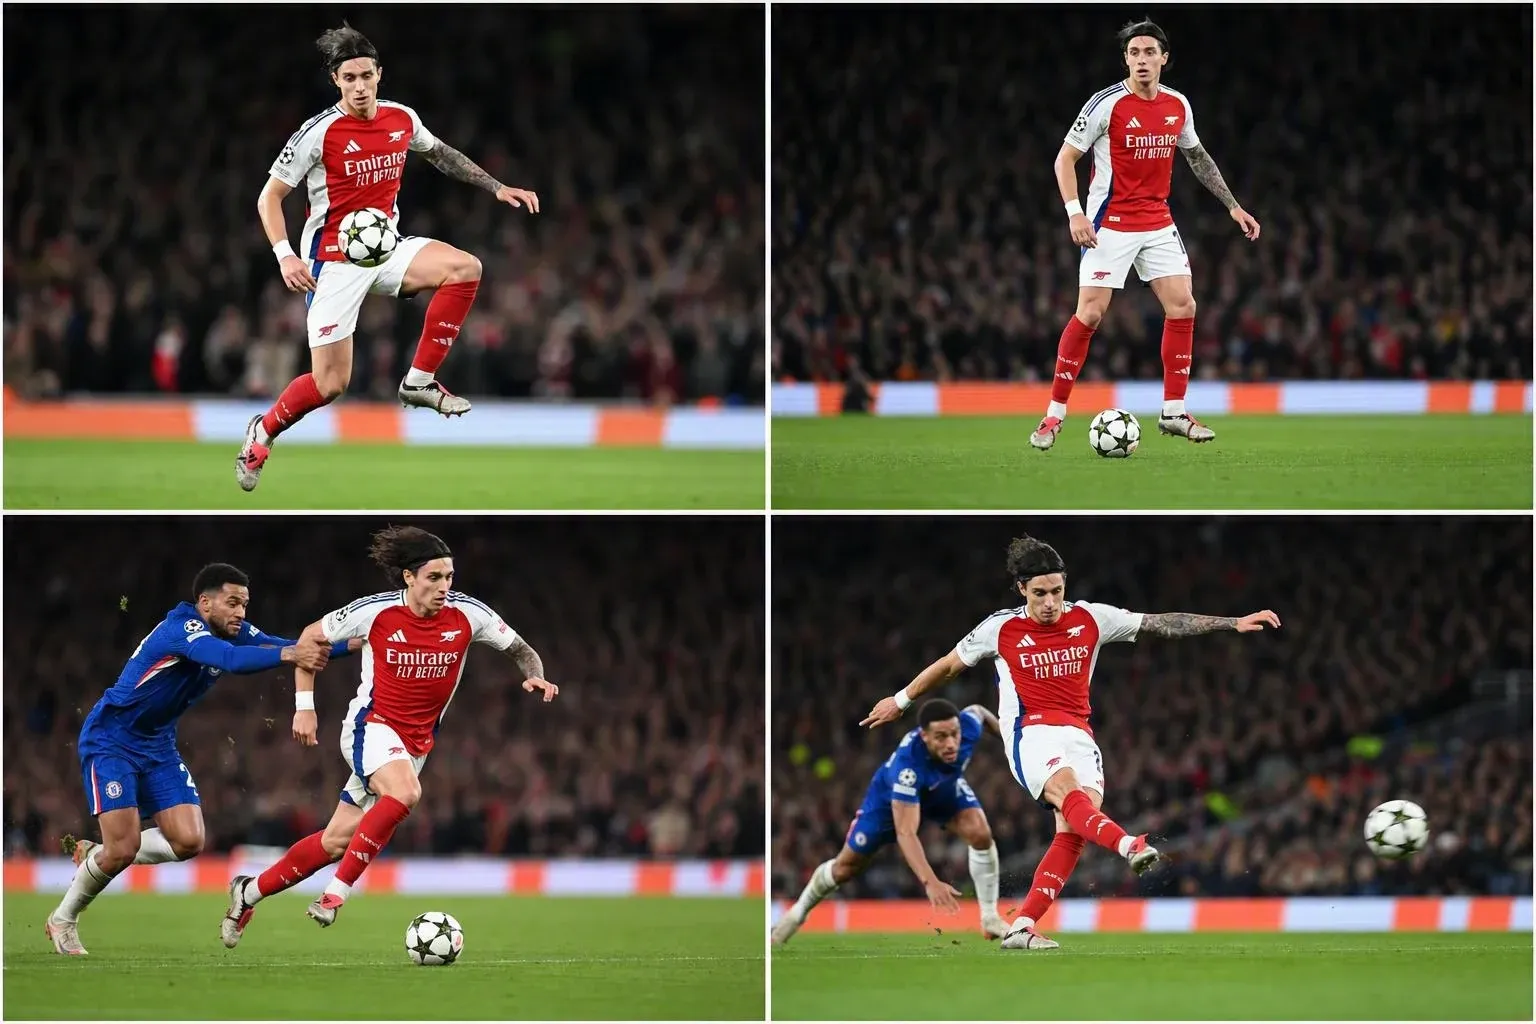
| 模型 | GPT-Image-2.5 Sunburst | GPT-Image-2 |
|---|---|---|
| 评分 | 4.5/5 | 4/5 |
简评:直接说两组的破绽。2.5 的问题出在下方两张图,都出现了明显的草皮飞起,但无论是带球突破还是射门,这都不合理(只有下铲才会铲起草皮);图 4 的射门动作也不合理,球员目光应直视传球/射门方向,而不是盯着脚下,足球还出现了不合理的残影。GPT-Image-2 的问题在右上图,球员双脚离地、悬浮在空中;图 4 同样有球员视线方向的问题。除此之外,两款模型在人物一致性和动作逻辑合理性上都堪称完美。
案例 8:图像编辑·多轮编辑
原图:
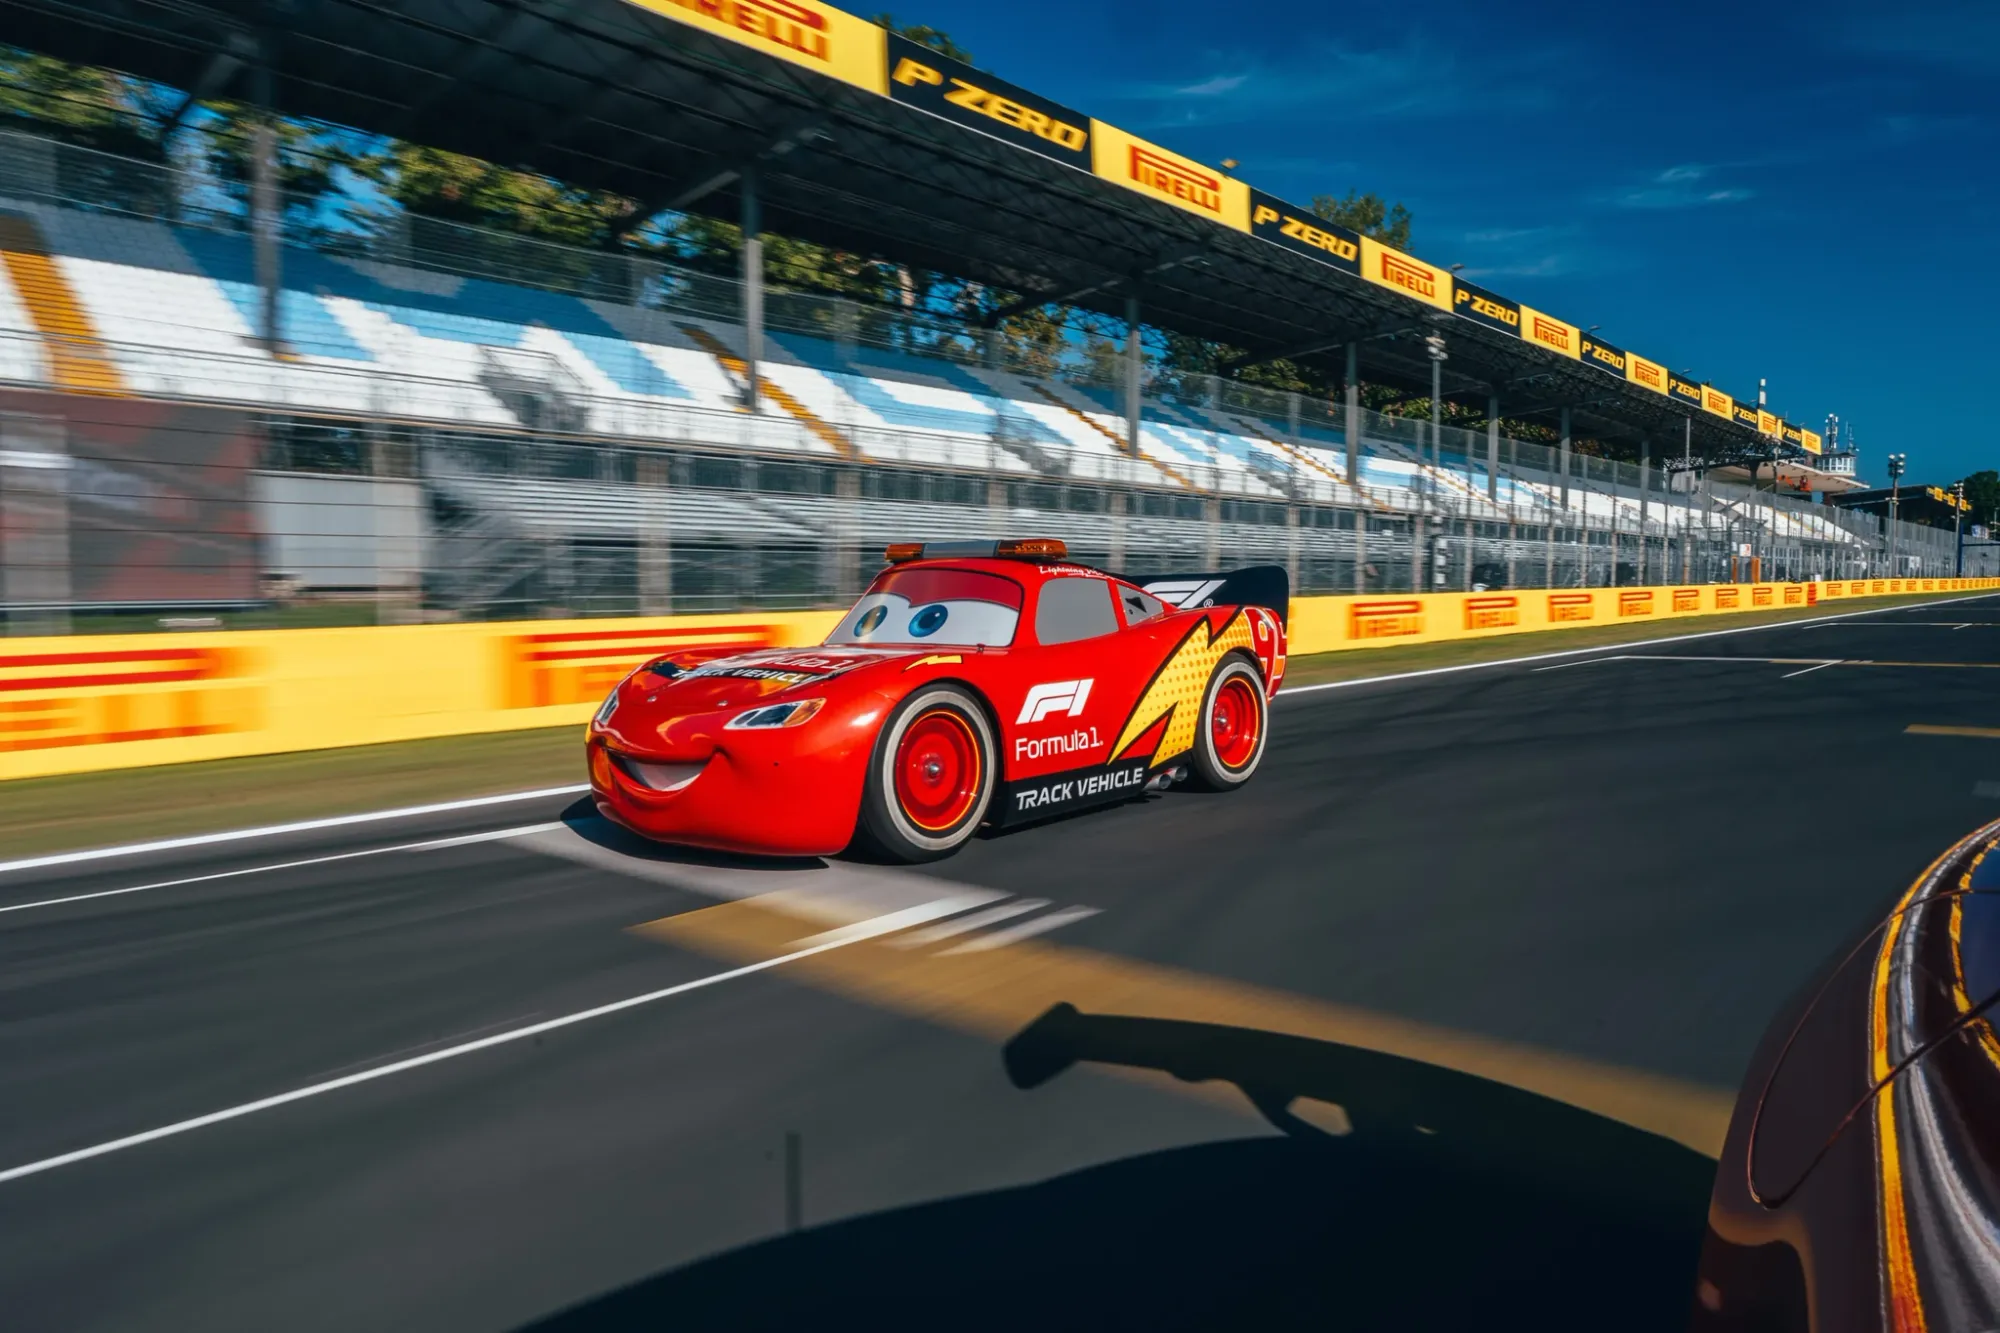
第一轮修改
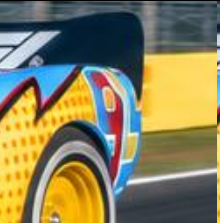
提示词:将闪电麦昆的红色车身改为baby blue浅蓝色,轮毂的红色改为和车身闪电一致的黄色;去除右下角的车身及对应的阴影。
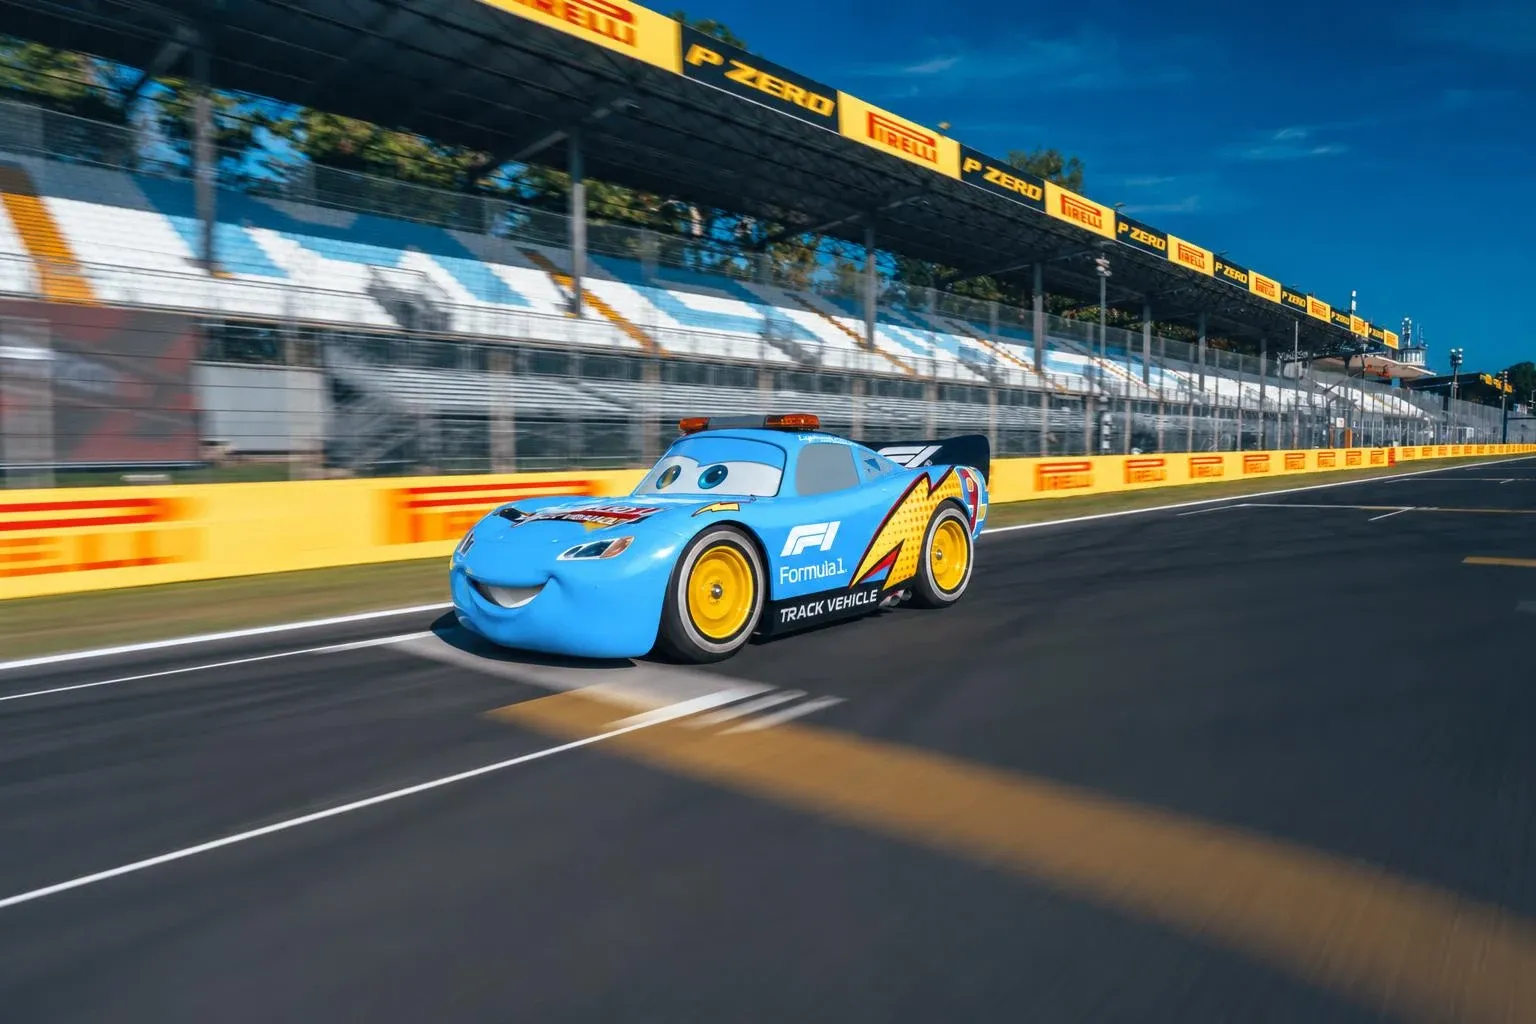
| 模型 | GPT-Image-2.5 Sunburst |
|---|---|
| 评分 | 4.5/5 |
简评:唯一的问题是车尾的 95 号号码没有处理干净,残留了部分原车的红色。
第二轮修改
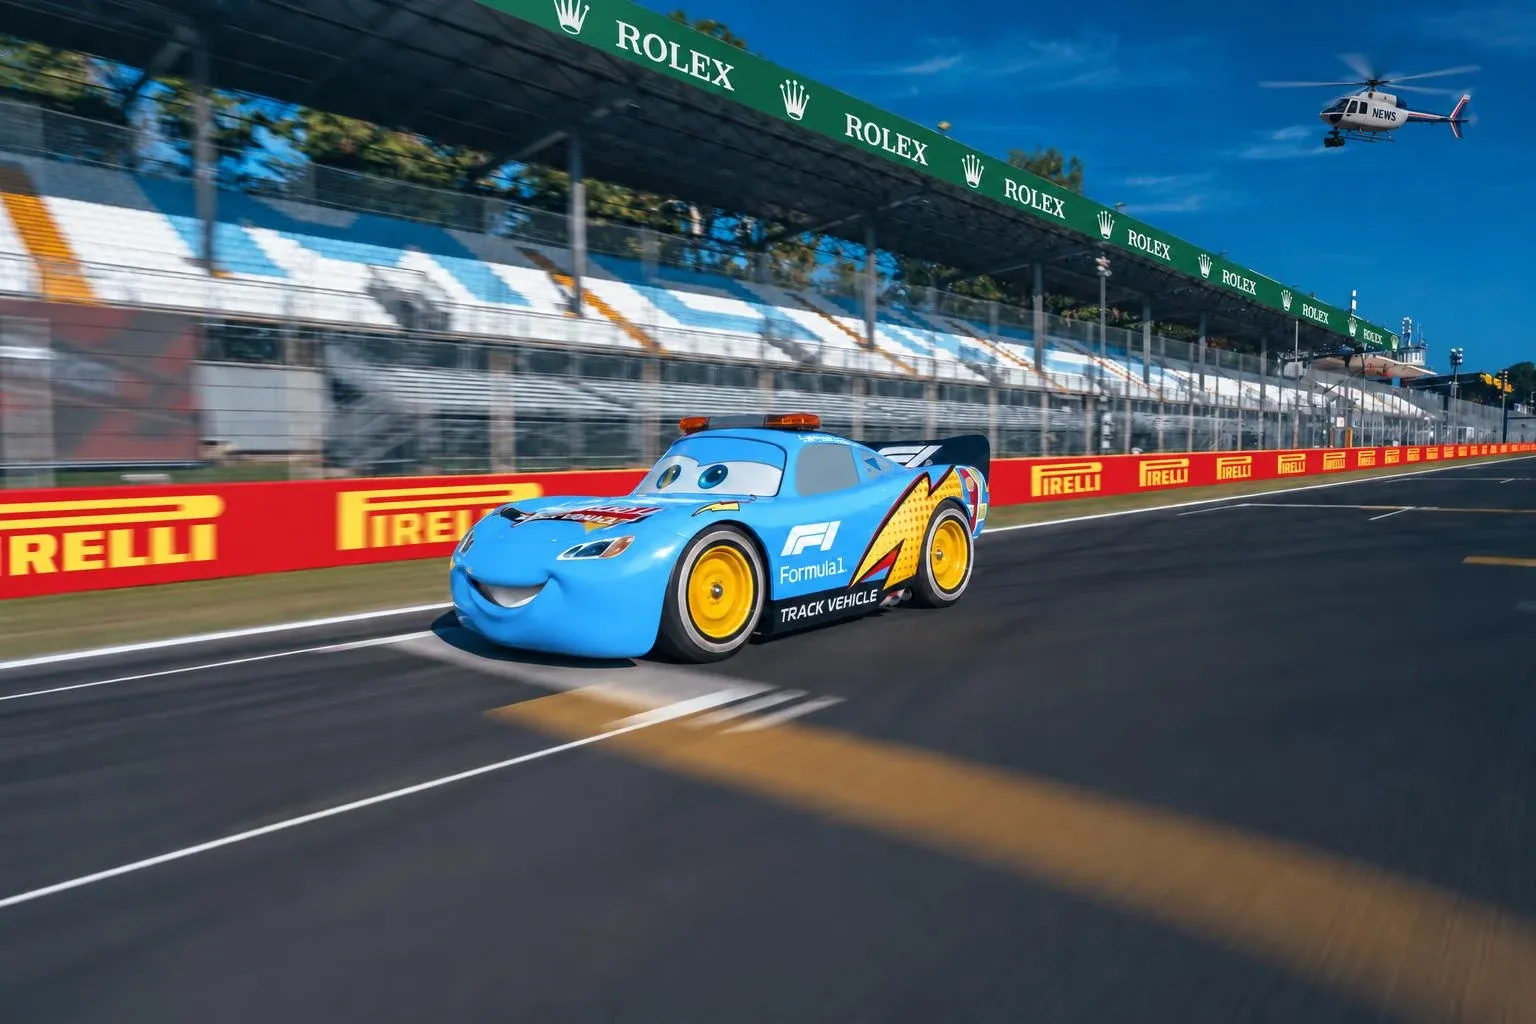
提示词:将黄色倍耐力的广告牌颜色反转(红色背景,黄色文字);黑色的P Zero广告牌改为绿色的Rolex广告牌;右上角的蓝色天空增加赛事转播的直升机。
| 模型 | GPT-Image-2.5 Sunburst |
|---|---|
| 评分 | 3/5 |
简评:三处改动都有问题。一是看台顶部的倍耐力广告消失,全部变成了劳力士;二是底部倍耐力广告文字的清晰度发生了变化,从原图的模糊变为清晰;三是加入的直升机过于清晰,焦点不合理。
第三轮修改
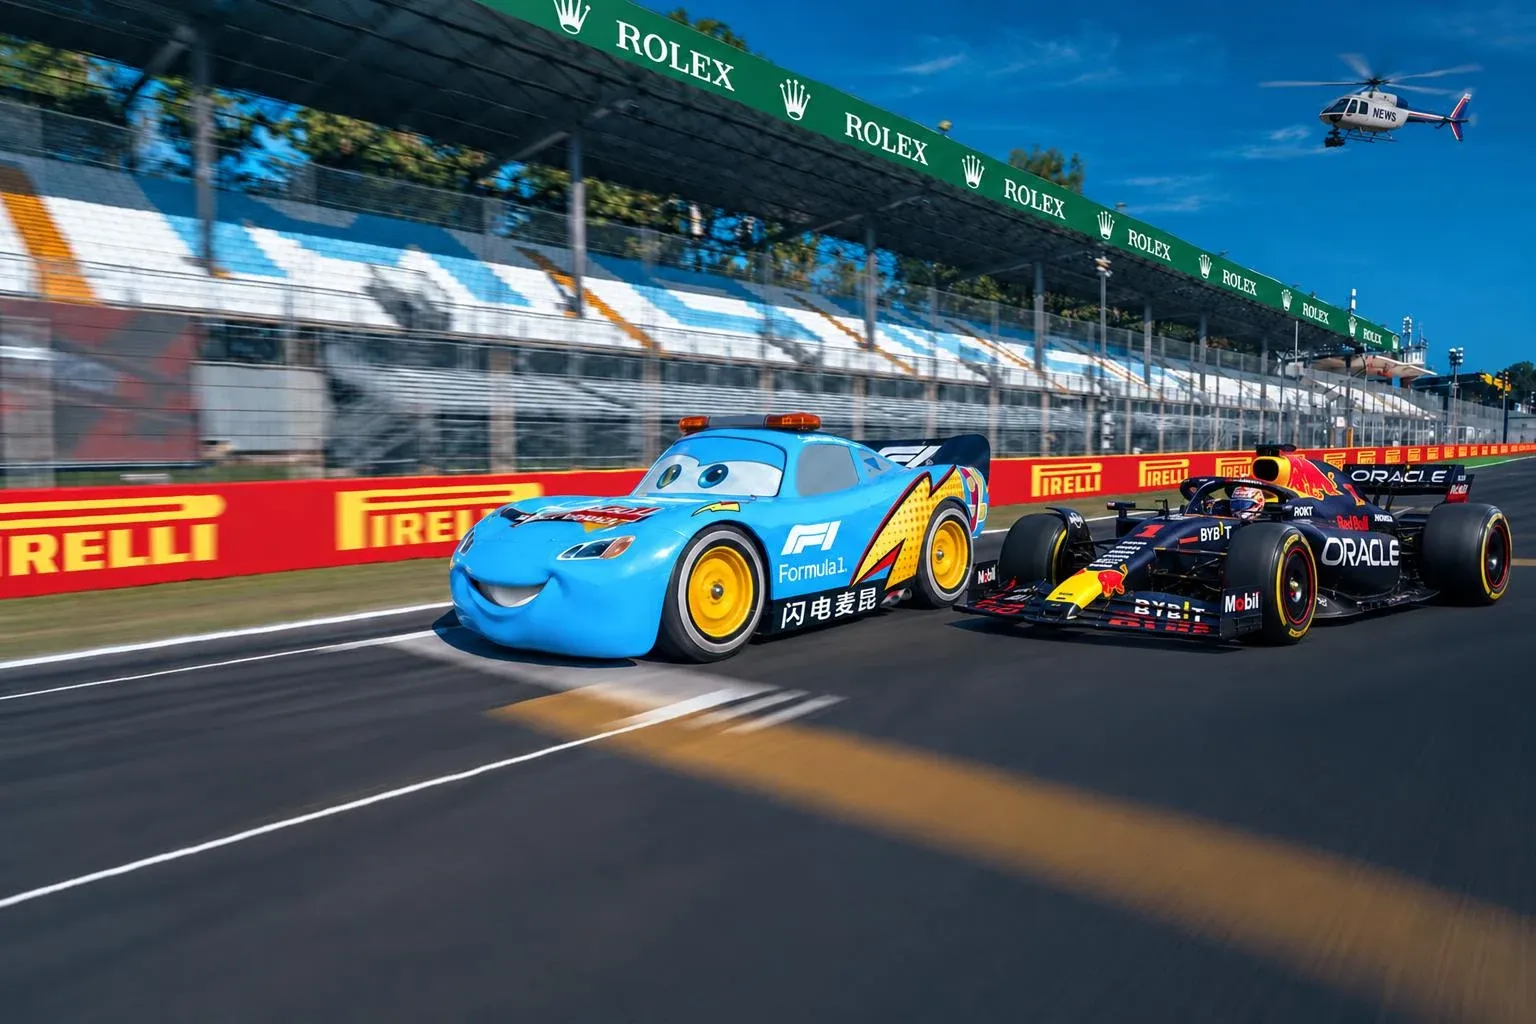
提示词:蓝色车身黑色侧裙上的文字“TRACK VEHICLE”改为中文“闪电麦昆”;在绿色框线位置加入维斯塔潘驾驶的红牛F1赛车。
| 模型 | GPT-Image-2.5 Sunburst |
|---|---|
| 评分 | 2.5/5 |
简评:这张图很假。F1 赛车与麦昆距离过近,行进方向偏右,像是要撞上麦昆,不符合现实;F1 赛车的轮胎缺乏动态表现,显得静止;车身过于清晰,仍然是对焦问题。
结论:画质见顶,“快”才是能感知的进步
有提升,但有限
8 组测试做完,最直接的感受是:有提升,但有限。毕竟 GPT-Image-2 本身已稳坐 SOTA 位置很久,各项能力都已是顶尖水平。
这次发布,OpenAI 自己也几乎没提画质。发布稿里与画质相关的只有一句“更自然的光影、更丰富的纹理”,没有亮眼的 benchmark,也没有创新突破的口号。
Artificial Analysis 图像竞技场的 Elo 分数如下:
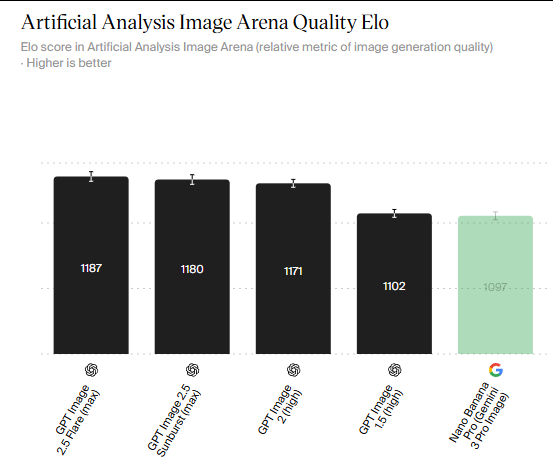
| 版本 | Elo 分数 | 涨幅 |
|---|---|---|
| GPT-Image-1.5 | 1102 | — |
| GPT-Image-2 | 1171 | +69 分(+6.3%) |
| GPT-Image-2.5 Flare | 1187 | +16 分(+1.4%) |
从 1.5 到 2.0,6.3% 的跃升足以让所有用户欢呼,因为画质和各项能力的提升实打实看得见;而这一次只有 1.4%——进步还在,但只剩零头。
这不是 OpenAI 不努力,而是画质与拟真这条赛道本身已经快跑到头了。看看如今的模型能做什么:输入几千字的提示词、准确清晰的文字渲染、指哪打哪的精准编辑、稳定的多轮一致性——这些一年前还不敢想的能力,现在已是各家头部模型的标配。
当模型要解决的已经是“字都对,但排版不够有杂志感”这一级别的问题,就意味着图像模型的下限已经确立,上限则在于更高维度的美学。在这个维度上,Midjourney 仍是绕不过去的名字。
这就是图像生成模型的边际效应时代:画质每进步 1%,用户感知到的惊喜越来越少;而榜单分数想再动 10 分,研发付出的成本可能是指数级的。Elo 曲线越来越平,不是厂商躺平,而是天花板就在头顶。
真正的升级:速度
既然画质难再拉开差距,OpenAI 给出的答案是速度。
现实中,没有人需要模型画出一张震惊全网的神图,创作者需要的是“想法→出图→不满意→修改→再修改”的循环。在这个循环里,画质从 90 分到 95 分的变化感知并不明显,但等待时间从 100 秒压到 30 秒却是直观可感的。
因此,这一代中实用性最强的是主打速度的 GPT-Image-2.5 Flare:
- 画质不掉队(仍高于 GPT-Image-2),延迟减半;
- Manus 的评价是:同等质量下,速度是上一代的 2–4 倍。
出图快带来的不只是体验优化,而是工作流的质变:时间成本骤降,单位时间内可以做更多尝试,创意密度直接翻倍。
推荐场景
- 电商与营销素材流水线:商品换背景、海报改文案、一图多版本投放测试。这正是 Flare 的主场:单张成本不变、速度翻倍,一个 campaign 出 10 个变体投入 A/B 测试,拼的就是效率。
- 社媒与日常设计改稿:运营和设计师都懂,甲方的第 5 轮反馈才是正餐。Images 2.5 的多轮编辑一致性是当下最强的选择。
- 信息图与图文卡片生产:中英双语排版、表格、多段精确文字都能胜任,做课件、公众号配图、数据卡片可以放心交付。
不推荐场景
- 追求艺术上限的创作:2.5 给不了上一代做不到的惊艳。如果想要更强的风格化和创意表现,尤其是在文生图模式下,不妨试试 Midjourney 等模型,也许更能带来惊喜。
- 预算敏感、以量取胜的任务:GPT-Image-2.5 再平价,也仍是 SOTA 档模型。单次出图虽不像顶级 LLM 那样迅速消耗额度,但量大时依然是一笔不小的开支。如果需求是“画质 60 分就能上线,但要 1 万张”——比如商品图批量清洗、素材库填充、内部测试数据——Qwen-Image、Flux 等开源模型仍是更务实的选择。
转自 302.AI