模型实测
模型上手实测与横向对比:真实表现、使用成本与短板。
模型上手实测与横向对比:真实表现、使用成本与短板。
第一张图像同一个人,换个场景就像换了演员;单张看起来都不错,放在同一组里却对不上。制作虚拟人物、产品模特图或故事分镜时,真正需要稳定的是整组图片中的角色身份。
这里的“角色一致性”指图像中的人物外观保持可辨认的连续性,不是聊天机器人的说话风格。你需要同时管理参考素材、生成条件和筛选标准,不能只依赖一句“保持同一个人”。
把角色要求写成一份简短的“角色卡”,将身份特征与当前镜头要求分开。
| 类型 | 示例 | 怎样管理 |
|---|---|---|
| 身份基准 | 面部轮廓、五官相对关系、显著识别特征 | 以选定的角色素材为准,不随每次提示改变 |
| 项目要求 | 发型、服装、配饰、画风 | 先确定哪些必须连续,哪些允许按镜头调整 |
| 镜头变量 | 场景、动作、构图、光线 | 每次清楚描述这次需要改变的部分 |
“同一个人”和“每个细节都不变”是不同要求。换装项目可以改变衣服,连续剧情却可能需要保持同一套服装。先确定验收边界,审核时才不会各凭感觉。
先选一张身份清晰、没有明显生成错误的基准图。根据计划生成的镜头,再补充其他角度或身体比例信息;不必把参考数量当成越多越好的指标。
准备素材时,可以检查:
背景尽量简洁,减少无关信息即可,不需要把纯白背景当成模型通用要求。参考图数量、尺寸和上传方式,以目标模型及接口的规则为准。
保留一份经过确认的基准素材。后续生成图可以成为候选参考,但应先与基准核对,再决定是否加入;否则,一次偏差可能在连续修改中被当成新的标准。
选模型时,先确认它能否接收参考图、执行图像编辑,以及是否支持你需要的多图输入或局部修改。纯文字生成与基于参考图的编辑,不应被当成同一种调用方式。
例如,Black Forest Labs 的 FLUX.1 Kontext 说明介绍了参考角色保持和定向编辑能力;Google 的图像提示指南也展示了跨场景保留角色的用法。这些是能力参考,不构成针对你当前素材的效果排名。
更实用的选择办法,是让候选模型完成同一组任务,再比较:角色是否仍可辨认、场景是否符合要求、需要修复多少次,以及最终可用图片的成本。
如果你使用支持相关组件的扩散模型工作流,还可以研究图像条件控制,例如 Diffusers 的 IP-Adapter 文档。这类方法需要相应管线支持,不能把一个参数直接加到任意商业 API 上就期待生效。
一种便于复用的写法是:先指明使用哪个角色素材,再说明当前镜头和需要保留的条件。
下面是本文编写的通用提示词示例,不是实测结果,也不是某个模型专属的参数语法:
使用已附参考图中的同一位角色,保持其面部身份。

本次画面:角色坐在书店窗边,正在翻阅一本打开的书。
构图:腰部以上的中景,镜头与眼睛接近同高。
本次允许改变:场景、坐姿,以及浅灰色针织外套。
需要保留:角色身份和既定发型。
画面风格:自然的纪实照片,窗边柔和日光,避免夸张修饰。
参考图已明确面容时,通常没有必要在每次请求中重新写一套细致的五官设定。若文字与图片矛盾,应先消除矛盾;若确实要改变发型、年龄表现或其他外观条件,则明确这是有意修改,并重新定义验收标准。
照片感也要符合任务。生活照可以要求自然取景和不过度修饰;电商素材则可能需要规范的布光。不要把“随手拍”或“棚拍”当成适用于所有项目的一条规则。
画幅也会改变构图、人物在画面中的大小与裁切。比较一致性时,先使用相同画幅;确认稳定后再测试其他比例。
可以用下面这组测试作起点。它是本文建议的检查方案,不是经过验证的行业基准。
| 镜头 | 主要检查什么 |
|---|---|
| 熟悉角度、简单背景 | 基本身份能否保持 |
| 改变角度或动作 | 侧脸、表情变化后是否明显漂移 |
| 更远的景别或新场景 | 人物变小、环境变复杂后是否仍符合角色要求 |
先测试一种变化,再逐步叠加。一次同时更换服装、年龄表现、画风、角度和光线,失败后很难知道是哪一项造成了问题。
如果要比较两个模型,可以各做三个镜头、每个镜头生成两次,共十二次请求。这个数量只是一个可控预算的起步方案,不能据此宣布某模型普遍更强。
每次保留模型及版本、参考图编号、完整提示词、画幅、质量档位和实际费用。接口提供 seed 时也可以记录,但不要把相同 seed 理解为跨提示词或跨模型的身份保证。
通过小样后,再扩展到整批;更换基准素材或模型版本时,先重跑关键镜头。
不要让漂亮的光影掩盖身份漂移。建议按固定顺序检查:
再给结果一个明确的后续状态:
评分标准最好附上一句原因,例如“侧脸轮廓变化明显”或“身份通过,手部需修复”。如果出现“看起来精致但不像本人”的结果,不要仅因为画质好就纳入角色素材库。
身份与主体构图都合格时,可以优先尝试支持的局部编辑,只修改有问题的手部、文字或背景细节。保留原图作为回退点,编辑后重新检查整张图。
如果人物身份本身已经明显漂移,先回到基准素材与原始请求条件排查,再决定重做。不要在偏离目标的结果上不断叠加修改。BFL 的官方说明也提到,过多轮编辑可能引入画面伪影。
批次管理可以从简单的文件夹和记录表开始:每张结果保存来源请求、审核状态和修改原因。审核通过后才进入最终交付目录,不需要依赖某个特定平台的按钮或图库结构。
可以同时观察两项指标:
可交付比例 = 已审核通过的图片数 ÷ 本批审核的图片数
每张可交付成本 = 本批实际总支出 ÷ 最终可交付图片数
总支出应包含生成、修复、放大等实际收费。假设同一批任务共花费 12 元,最终有 6 张通过,则每张可交付成本为 2 元。这只是计算示例,不是模型价格或效果数据;没有合格图片时,不应报告为零成本。
不同模型、角色与验收标准会得到不同结果。不要从别人的可用率推断自己的预算,也不要把放宽审核后的通过率与严格审核的结果混为一谈。
可以作为起点,尤其是角度和构图变化不大时。需要大角度或全身镜头时,再根据结果与模型能力补充素材;多图并不自动保证更稳定。
参考图已经明确时,重复的外观描述可能没有必要,矛盾的描述还会让目标变得不清楚。文字更适合明确身份依据、当前镜头和真正要改变的内容。
不能保证。质量档位、尺寸和身份保持是不同维度;仍要检查素材、编辑方式和提示是否匹配。具体档位只在模型确实提供时使用。
不能作这样的通用保证。seed 的作用与模型及实现有关,跨模型、跨提示词或更换其他参数时,仍需要重新检查结果。
这套流程不提供这样的保证。它的作用是帮助你更清楚地控制生成条件、发现漂移并筛出可交付结果。效果要通过自己的素材、任务与审核标准来验证。
准备批量调用前,可在 API 平台核对目标模型的图片输入、编辑方式、尺寸与费用规则,先跑小样再扩大任务量。需要程序化批处理时,也可参考 API 429 限流与重试排查指南。
这篇文章由参考图、提示词、审核与成本控制等问题重新组织,提示词和检查方案为本文编写,并非原文中的实测记录。流程思路参考了 角色批次一致性指南,能力说明见正文所引官方资料。
测试时 API 一切正常,上线后却频繁出现 429 Too Many Requests:这种情况不一定是用户突然变多了。长提示词可能耗尽 Token 限额,多个服务可能共享同一份容量,自动重试也可能把一次短暂拥堵变成持续报错。
遇到 429,先读取错误正文,确认限制来自哪里,再决定降低请求速率、减少 Token,还是处理配额问题。 本文解释 RPM、TPM 与并发的区别,梳理常见原因,并给出带指数退避、随机抖动和 Retry-After 处理的 Python 示例。
Retry-After,至少等待指定时间;没有时再采用有上限的指数退避与随机抖动。仍持续触发限制时,调整队列、用量或容量。HTTP 429 的含义和限制范围可以参考 MDN 的 429 说明。具体原因仍应结合当前服务返回的错误正文判断。
请求次数不能完整反映大模型任务的计算需求。
一次短文本分类可能只输入 200 个 Token,返回一个标签;一次代码库分析可能输入数千个 Token,再生成长篇回答。两者都算一次请求,但消耗的 Token、处理时间和计算资源差别很大。
不同限制分别应对不同的流量特征:
常见指标包括 RPM、TPM,以及按小时、按天统计的请求或 Token 限额。图片服务还可能使用 IPM、IPD,分别表示每分钟、每天的图像数量。只要其中一项适用限制达到上限,请求就可能被限制。 并非每个平台都会使用全部指标。
RPM 和 TPM 衡量的是不同维度。
| 指标 | 含义 | 常见瓶颈 |
|---|---|---|
| RPM | 每分钟请求数 | 高频小请求 |
| TPM | 每分钟 Token 数 | 长提示词、大上下文、长输出 |
| RPH | 每小时请求数 | 小时级使用上限 |
| RPD | 每天请求数 | 每日请求额度 |
| TPD | 每天 Token 数 | 每日 Token 消耗 |
RPM 限制的是一定范围内每分钟可发送的请求次数。这里的范围可能是账号、项目、模型或其他资源,取决于服务规则。
即使每次请求都很短,也可能触发 RPM 限制。自动补全、聊天程序、Agent 循环,以及把一次用户操作拆成多次模型调用的工作流,都容易遇到这种情况。
例如,一个 Agent 任务分别调用模型完成规划、工具选择、结果验证和最终回答。用户只提交了一次任务,后台却发出了四次或更多请求。
TPM 限制的是每分钟计入限流的 Token 数量。系统提示词、历史对话、检索文档、代码、推理内容和长输出,都可能增加消耗。
排查时记录实际返回的 prompt_tokens、completion_tokens、total_tokens,或当前协议中的对应字段。用于限流的计算口径不一定与最终账单完全相同:有些服务会参考预估输入量、输出上限等信息,具体以服务文档为准。
假设两个应用每分钟都发送 10 次请求:
两者都是 10 RPM,但应用 B 更容易先达到 TPM 上限。
接入前要确认限制的作用范围。部分服务按账号或项目共享容量,部分会按模型、模型组、Key 或其他维度进一步限制。
多创建几个 API Key,不等于一定获得更多容量。 如果这些 Key 共享同一账号、项目或上游限额,总容量可能完全不变。
同样,不要默认不同模型拥有独立额度,也不要默认套餐升级会同时增加所有指标。部署前核对目标模型、当前账号等级和实际限额。
429 通常提示请求触及适用的使用限制,但只看状态码,无法确定究竟是哪种限制。应继续查看错误代码、正文和响应头。
集中发送的短请求可能超过 RPM。Agent 一次用户操作触发多次调用,会让前台看到的任务数远低于实际请求数。
少量长请求也可能超过 TPM。常见原因包括重复发送系统提示词、携带完整历史记录、返回过多检索内容、输入长代码文件,以及设置不必要的输出上限。
多个应用、后端服务、Worker 或 Key 可能共享账号、项目、模型或上游容量。单独观察每个服务时流量不大,加总后却已经达到上限。
每小时或每天平均用量不高,不代表某一分钟内没有突发。定时任务同时启动、队列一次释放大量任务,都会造成短时峰值。
因此,排查 429 应同时查看队列积压、请求释放速率和分钟级用量,而不是只看全天总量。
立即重试会向已经受限的系统继续发送请求。多个 Worker 同时失败、同时重试,可能产生重试风暴,让问题持续更久。
部分模型或套餐还设置小时级、每日请求数或 Token 上限。RPM 和 TPM 没有达到上限,也不代表其他配额仍有剩余。
使用专属部署时,还要确认目标地址、部署名、模型 ID 和 Key 权限是否匹配。请求误入共享接口时,可能触发另一套限流规则。
专属容量是否免除某些共享限制、还受哪些网关或实例限制,取决于部署方案。不要将“专属”理解为无限吞吐。
如果错误明确指向余额、账单、权限或已耗尽的长期配额,应先处理这些条件,再重试。没有足够错误信息时,向服务方提供请求 ID、时间和脱敏错误详情。
不是所有临时 API 故障都属于限流。先区分状态码,再阅读具体错误详情。
| 状态码 | 常见含义 | 首先怎么处理 |
|---|---|---|
| 429 | 请求速率、Token 或其他使用限制;部分服务也用它报告配额问题 | 确认限制类型;临时限流降低速率并退避,配额问题先处理配额 |
| 503 | 服务暂时不可用,可能涉及负载或维护 | 检查服务状态,仅对适合重试的任务做有限重试或使用已验证的备用方案 |
| 504 | 网关未及时收到上游响应 | 检查任务状态、耗时和超时设置,避免重复提交已在执行的任务 |
| 400 | 请求格式或参数不符合要求 | 按错误正文修改请求;模型 ID 错误也可能返回其他状态码 |
| 401 | 身份认证失败或凭据缺失 | 检查 Key、认证头和目标服务是否匹配 |
| 403 | 没有相应权限 | 检查账号、项目和模型访问权限 |
| 404 | 接口路径、模型或目标资源不存在 | 检查 Base URL、路径拼接、接口协议和资源 ID |
长时间的非流式请求如果反复出现 504,原样重试未必有效。对于支持流式的场景,可评估流式返回、减少输出长度,或调整客户端与网关超时。
流式响应有助于持续传输数据,不能增加 RPM、TPM,也不能解决所有上游计算超时。对于异步任务,应先查询任务状态,再决定是否重新提交。
只对适合重试的临时故障进行重试,并限制次数、等待时间和整体业务耗时。先确认任务是否允许重复执行,再选择策略。
连续失败后逐步增加等待时间,例如约 1 秒、2 秒、4 秒、8 秒,同时设置等待上限和尝试次数上限。具体等待策略可参考 AWS 对指数退避和随机抖动的说明。
在退避时间上增加随机偏移,避免多个客户端在相同时间再次发起请求。否则,一起失败的请求可能再次一起到达。
队列可以吸收短时突发,再按可承受速率释放任务。交互请求可优先处理,后台任务等待可用容量。
令牌桶、漏桶等机制控制新请求何时发出;并发上限控制同时执行多少请求。两者解决的问题不同,通常需要配合使用。
某些场景可以从最多 3—5 次总尝试开始,再结合延迟要求和业务成本调整。“尝试 5 次”包含首次请求,不是首次之外再重试 5 次。
最后一次仍失败时,返回明确错误、保留任务等待后续处理,或进入经过验证的备用方案。交互任务还应设置整体截止时间,避免用户离开后仍持续执行。
Agent 可能调用付款系统、数据库、文件操作等外部工具。重试模型请求,不应自动重复已经成功的业务操作。
使用幂等键、操作 ID、任务状态和去重机制保护下游。网络超时也不等于服务端没有执行;重新发起生成可能造成额外费用。
SDK 和业务层如果都在重试,总尝试次数可能相乘。使用应用层策略时,应关闭 SDK 重试,或把两层行为一起纳入预算。相关原则可参考 OpenAI 官方限流处理文档。
Retry-After 可以表示等待秒数,也可以表示一个 HTTP 日期。服务端提供有效提示时,至少等待指定时间;如果超出当前任务能接受的等待预算,应停止并延后任务,不能擅自缩短等待后继续发送。字段格式见 MDN 的 Retry-After 说明。
下面的 Python 示例用于 OpenAI 兼容的 Chat Completions 接口。它关闭 SDK 重试,限制总尝试次数与累计重试等待,并对已识别的配额或计费错误直接退出。
运行前安装 openai,设置 API_KEY、API_BASE_URL 和 MODEL_ID。使用服务文档给出的完整 Base URL;按实际模型要求调整 max_tokens 等参数。示例使用 Python 3.10 或更高版本。
import math
import os
import random
import time
from datetime import datetime, timezone
from email.utils import parsedate_to_datetime

from openai import APIConnectionError, APIStatusError, OpenAI

client = OpenAI(
    api_key=os.environ["API_KEY"],
    base_url=os.environ["API_BASE_URL"],
    max_retries=0,
    timeout=30.0,
)

# Extend this set with the documented error codes of your API provider.
NON_RETRYABLE_CODES = {
    "insufficient_quota",
    "billing_hard_limit_reached",
    "billing_not_active",
}


def parse_retry_after(value: str | None) -> float | None:
    if not value:
        return None
    try:
        seconds = float(value)
        return max(0.0, seconds) if math.isfinite(seconds) else None
    except ValueError:
        pass
    try:
        retry_time = parsedate_to_datetime(value)
        if retry_time.tzinfo is None:
            retry_time = retry_time.replace(tzinfo=timezone.utc)
        seconds = (retry_time - datetime.now(timezone.utc)).total_seconds()
        return max(0.0, seconds)
    except (TypeError, ValueError, OverflowError):
        return None


def create_chat_completion(
    messages: list[dict[str, str]],
    max_attempts: int = 5,
    max_retry_wait: float = 60.0,
):
    if max_attempts < 1 or max_retry_wait < 0:
        raise ValueError("Invalid retry limits")

    waited = 0.0
    for attempt in range(max_attempts):
        try:
            return client.chat.completions.create(
                model=os.environ["MODEL_ID"],
                messages=messages,
                max_tokens=800,
            )
        except APIStatusError as error:
            if (
                error.status_code not in {429, 503, 504}
                or error.code in NON_RETRYABLE_CODES
                or attempt == max_attempts - 1
            ):
                raise
            backoff = min(30.0, 2.0 ** attempt)
            server_delay = parse_retry_after(
                error.response.headers.get("retry-after")
            )
            delay = server_delay if server_delay is not None else backoff
            delay += random.uniform(0.0, min(1.0, delay * 0.25))
            if waited + delay > max_retry_wait:
                raise
        except APIConnectionError:
            if attempt == max_attempts - 1:
                raise
            delay = min(30.0, 2.0 ** attempt) + random.uniform(0.0, 1.0)
            if waited + delay > max_retry_wait:
                raise

        time.sleep(delay)
        waited += delay

    raise RuntimeError("The request failed after all retry attempts.")
max_attempts=5 表示最多发起五次尝试;max_retry_wait=60 只限制累计休眠等待,不包含网络调用耗时。timeout=30.0 也不等于整个业务只能运行 30 秒;完整的截止时间与取消机制应由上层应用控制。
服务方的错误代码可能不同,应按照实际文档补充 NON_RETRYABLE_CODES。示例不适合直接重放已经输出部分内容的流,也不会替你判断异步任务或外部操作是否已经成功。
RPM、TPM 衡量吞吐量,并发衡量同时执行的请求数量,不能互相直接替代。
在限额以总 Token 为统计口径的假设下,可以用观测数据粗估起点:
RPM 允许的请求速率 = RPM ÷ 60
TPM 允许的请求速率 = TPM ÷ 每次请求的观测总 Token 数 ÷ 60
计划释放速率 = min(RPM 速率, TPM 速率) × 安全系数
并发规模参考值 = 计划释放速率 × 请求耗时
假设一个模型的限制和观测值为:
按 RPM 计算:
1,200 ÷ 60 = 20 次/秒
按 TPM 计算:
60,000 ÷ 1,200 ÷ 60 ≈ 0.83 次/秒
这里 TPM 是更紧的约束。应用安全系数后:
0.83 × 0.8 ≈ 0.67 次/秒
再用 P95 耗时估算并发规模:
0.67 × 4 ≈ 2.68 个同时执行的请求
可以从并发 2 或 3 开始观测,同时将请求释放速率控制在约 0.67 次/秒以内。这是一组演示数据,不代表任何平台的实际限额。
该公式只是容量规划的起点。平均 Token 不能覆盖长请求尾部风险;用 P95 耗时相乘是规划参考,也不是严格的并发保证。请求长度、延迟、服务端窗口及其他限制都会影响结果。
只设置并发上限,不能自动遵守 RPM 或 TPM。 快请求完成后立刻补入新请求,仍可能超出分钟限额。因此还需要请求节流,以及按服务端口径进行 Token 用量控制。
限流处理应进入日常流量设计,而不是等上线报错后再补一个重试循环。
一个界面动作可能包含规划、检索、工具调用和结果验证等多次模型请求。容量估算应以实际调用次数为基础。
记录输入、输出和总 Token 的中位数、P95 与最大值。平均值正常时,少量超长请求仍可能造成问题。
模型拥有独立额度时,可以按模型划分队列和并发限制;多个模型共享账号或上游额度时,还需要共同的总量限制。单一全局限制和完全独立的队列,都可能与真实规则不匹配。
去掉重复上下文,限制检索结果数量,总结较早的对话,并设置合理的输出上限。这些措施通常能同时降低 Token 压力和调用成本。
分类、抽取、推理、编程和多模态任务,可以根据质量、延迟、成本与可用容量选择合适的模型。
备用模型必须验证任务效果与接口兼容性。切换模型不应被当成绕过平台限制的方法,也不能保证另一个模型拥有独立容量。
评测、文档处理、分类和大规模抽取不一定需要实时结果。如果服务提供批处理 API,可评估其支持的模型、接口、处理时限、费用和独立限额。
如果没有批处理 API,也可以使用自有任务队列按允许速率执行;普通循环请求不会因此自动获得批处理折扣或额外容量。
提示词优化、队列和有限重试可以缓解短时峰值,但不能解决长期需求超过容量的问题。
当正常业务持续接近限额时,按服务方的流程申请更高 RPM、TPM 或其他容量。准备预计请求量、输入输出分布、峰值、任务类型和延迟要求,帮助判断需要增加的是哪一项资源。申请本身不等于一定获批。
持续高吞吐或需要更可预测容量的应用,可以评估服务方提供的专属部署方案。比较实际吞吐、延迟、排队时间、成本,以及仍然适用的网关和实例限制,不要默认专属部署没有上限。
TPM 是每分钟 Token 数,用于限制单位时间的 Token 使用。长提示词、对话历史、检索文档、推理内容和长输出,都可能让应用先达到 TPM,而不是 RPM。
少量长请求可能消耗大量 Token;突发流量、共享容量、重试叠加、小时或每日限制,也可能触发 429。先阅读错误正文,不要只看前台用户数。
不应该。适合重试的临时限流、部分 503、504 或连接错误,可以采用有限退避。参数错误、认证失败、权限不足、路径错误,以及需要处理账单或长期配额的问题,应先修正原因。超时后的任务还需要判断是否已经执行。
不一定。它们是不同的约束,可能随模型、账号、项目或部署方案变化。申请扩容时应分别确认。
控制请求释放速率,管理并发与 Token 用量,使用队列和带随机抖动的有限重试;缩短不必要的上下文,将适合的离线任务移出实时调用。当持续需求超过容量时,再申请扩容或评估其他部署方案。
准备继续接入时,可从 API 平台进入,按当前接入文档核对 Base URL、模型 ID 和凭据,再用一条最小请求验证配置。排障求助时附上请求时间、请求 ID 和脱敏错误正文,更容易定位问题。
延伸阅读:模型选型专题。
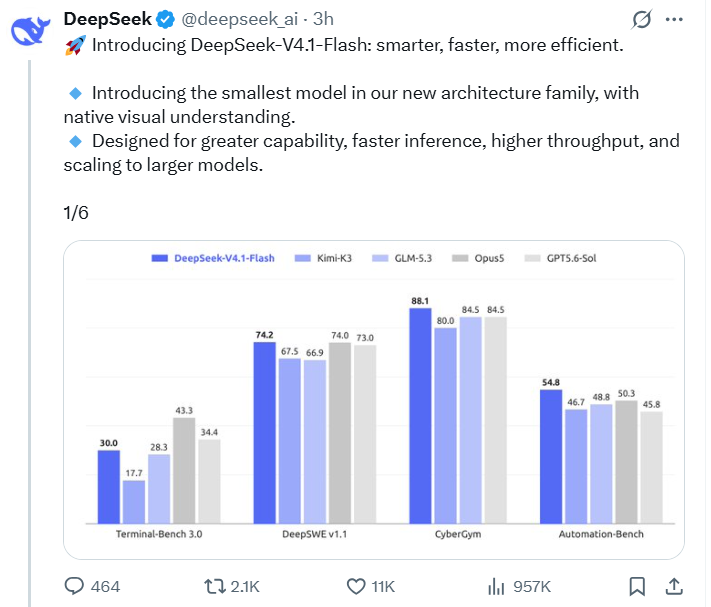
9 月 10 日,DeepSeek 正式发布 DeepSeek V4.1 Flash。按官方说法,新版本在性能、速度、成本和任务总用时上都超过了 V4 Pro;9 月 14 日之后,V4 Pro 的 API 请求将全部转向 V4.1 Flash。
这不是一次常规的小版本更新。V4.1 Flash 换用了全新的 Causal-Encoder-Decoder 架构,总参数 552B,输入侧只激活 8B、输出侧激活 16B;同时原生加入视觉理解,KV Cache 继续大幅压缩,API 价格再次下调。DeepSeek 的意图很清楚:让一个 Flash 模型承担越来越多原本属于 Pro 的工作,同时把推理成本继续往下压。
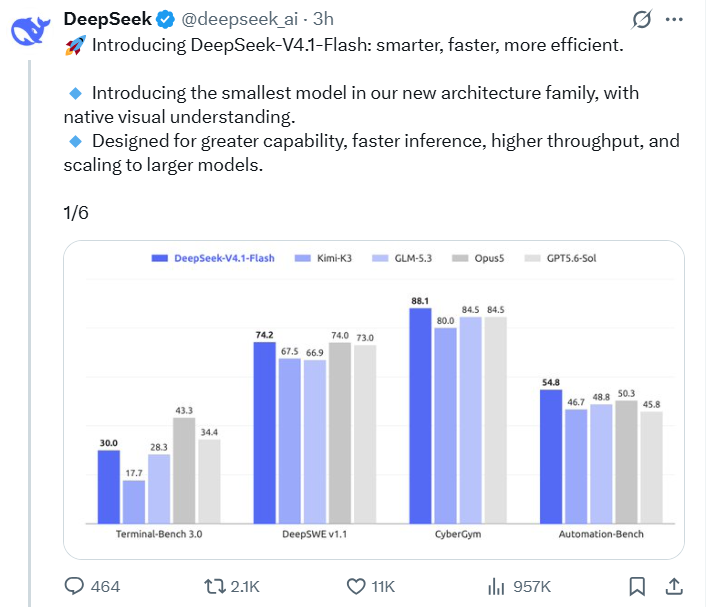
V4.1 Flash 是 DeepSeek 新架构系列中最小的一款,总参数 552B,采用 MoE 结构,这让它很适合 Agent 场景。Coding Agent 往往要反复读取代码仓库、工具说明和历史上下文,最后只输出少量代码或工具指令;输入、输出采用不同的计算规模,可以减少读取信息环节的计算开销。
官方公布的 benchmark 显示,V4.1 Flash 在 GPQA Diamond、Codeforces、MathArena Apex、Terminal-Bench、CyberGym 等测试中表现突出,部分项目超过 V4 Pro;但在 Terminal-Bench 3.0/4.0、ProgramBench 等项目上,它与顶级闭源模型仍有差距。总体看,这次升级的重点仍是在能力、速度和成本之间求平衡。
此前 DeepSeek 的视觉能力主要通过 V4-Flash-Vision-Exp 这类实验版本提供。这一次,V4.1 Flash 直接把视觉理解并入主力模型,图片、截图、图表、PDF 等内容都能进入同一套模型流程。
这对 Agent 场景尤其重要。现实任务很少只有纯文本:网页里有截图,产品文档里有流程图,代码任务里有报错界面,办公文件里还有表格和 PDF。模型能把这些信息直接放进同一个任务上下文处理,用起来会顺手得多。
新一代模型大幅缩小了 KV Cache:与上一代相比,HBM 需求降到 1/4,SSD 需求降到 1/8;与初代模型相比,KV Cache 已缩小 437 倍。如果缓存占用和缓存命中价格持续下降,Agent 连续跑几十轮、上百轮任务的成本也会随之下降。V4.1 Flash 把缓存、架构和价格放在一起优化,目的就是让模型更适合持续工作。
V4.1 Flash 的 API 继续采用峰谷定价,闲时价格为高峰期的一半,新价格于 9 月 10 日 12:00 生效。官方同时宣布,9 月 14 日 12 点后逐步下线 V4 Pro,原本指向 V4 Pro 的请求直接转到 V4.1 Flash。这一动作说明了新模型的定位:Flash 开始坐上主力模型的位置。
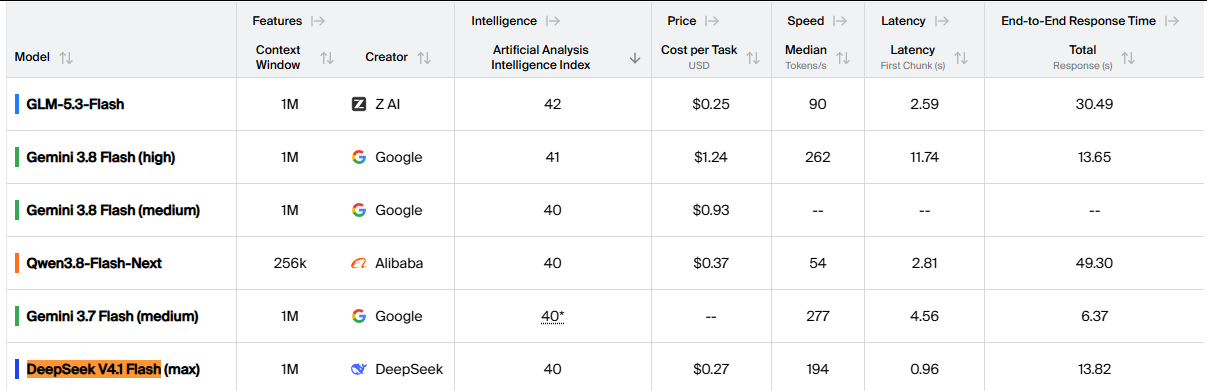
在目前的 Artificial Analysis 榜单中,V4.1 Flash 总排名第 37 位,在 Flash 模型中排名第 6。
规格、benchmark 和价格之外,Coding、Agent、多模态和长上下文这些场景的差异,要实际跑起来才能看出。以下是一组同题实测,检验 V4.1 Flash 在真实任务中能否坐实“Pro 级能力、Flash 级价格”。
deepseek-v4.1-flash,上下文窗口 1M(1,000,000 token)。
本次评测侧重逻辑、数学、编程、多模态和人类直觉类问题,并非专业前沿领域的权威测试,目的是观察模型的进化趋势,为选型提供参考。
编程案例按以下等级评定:
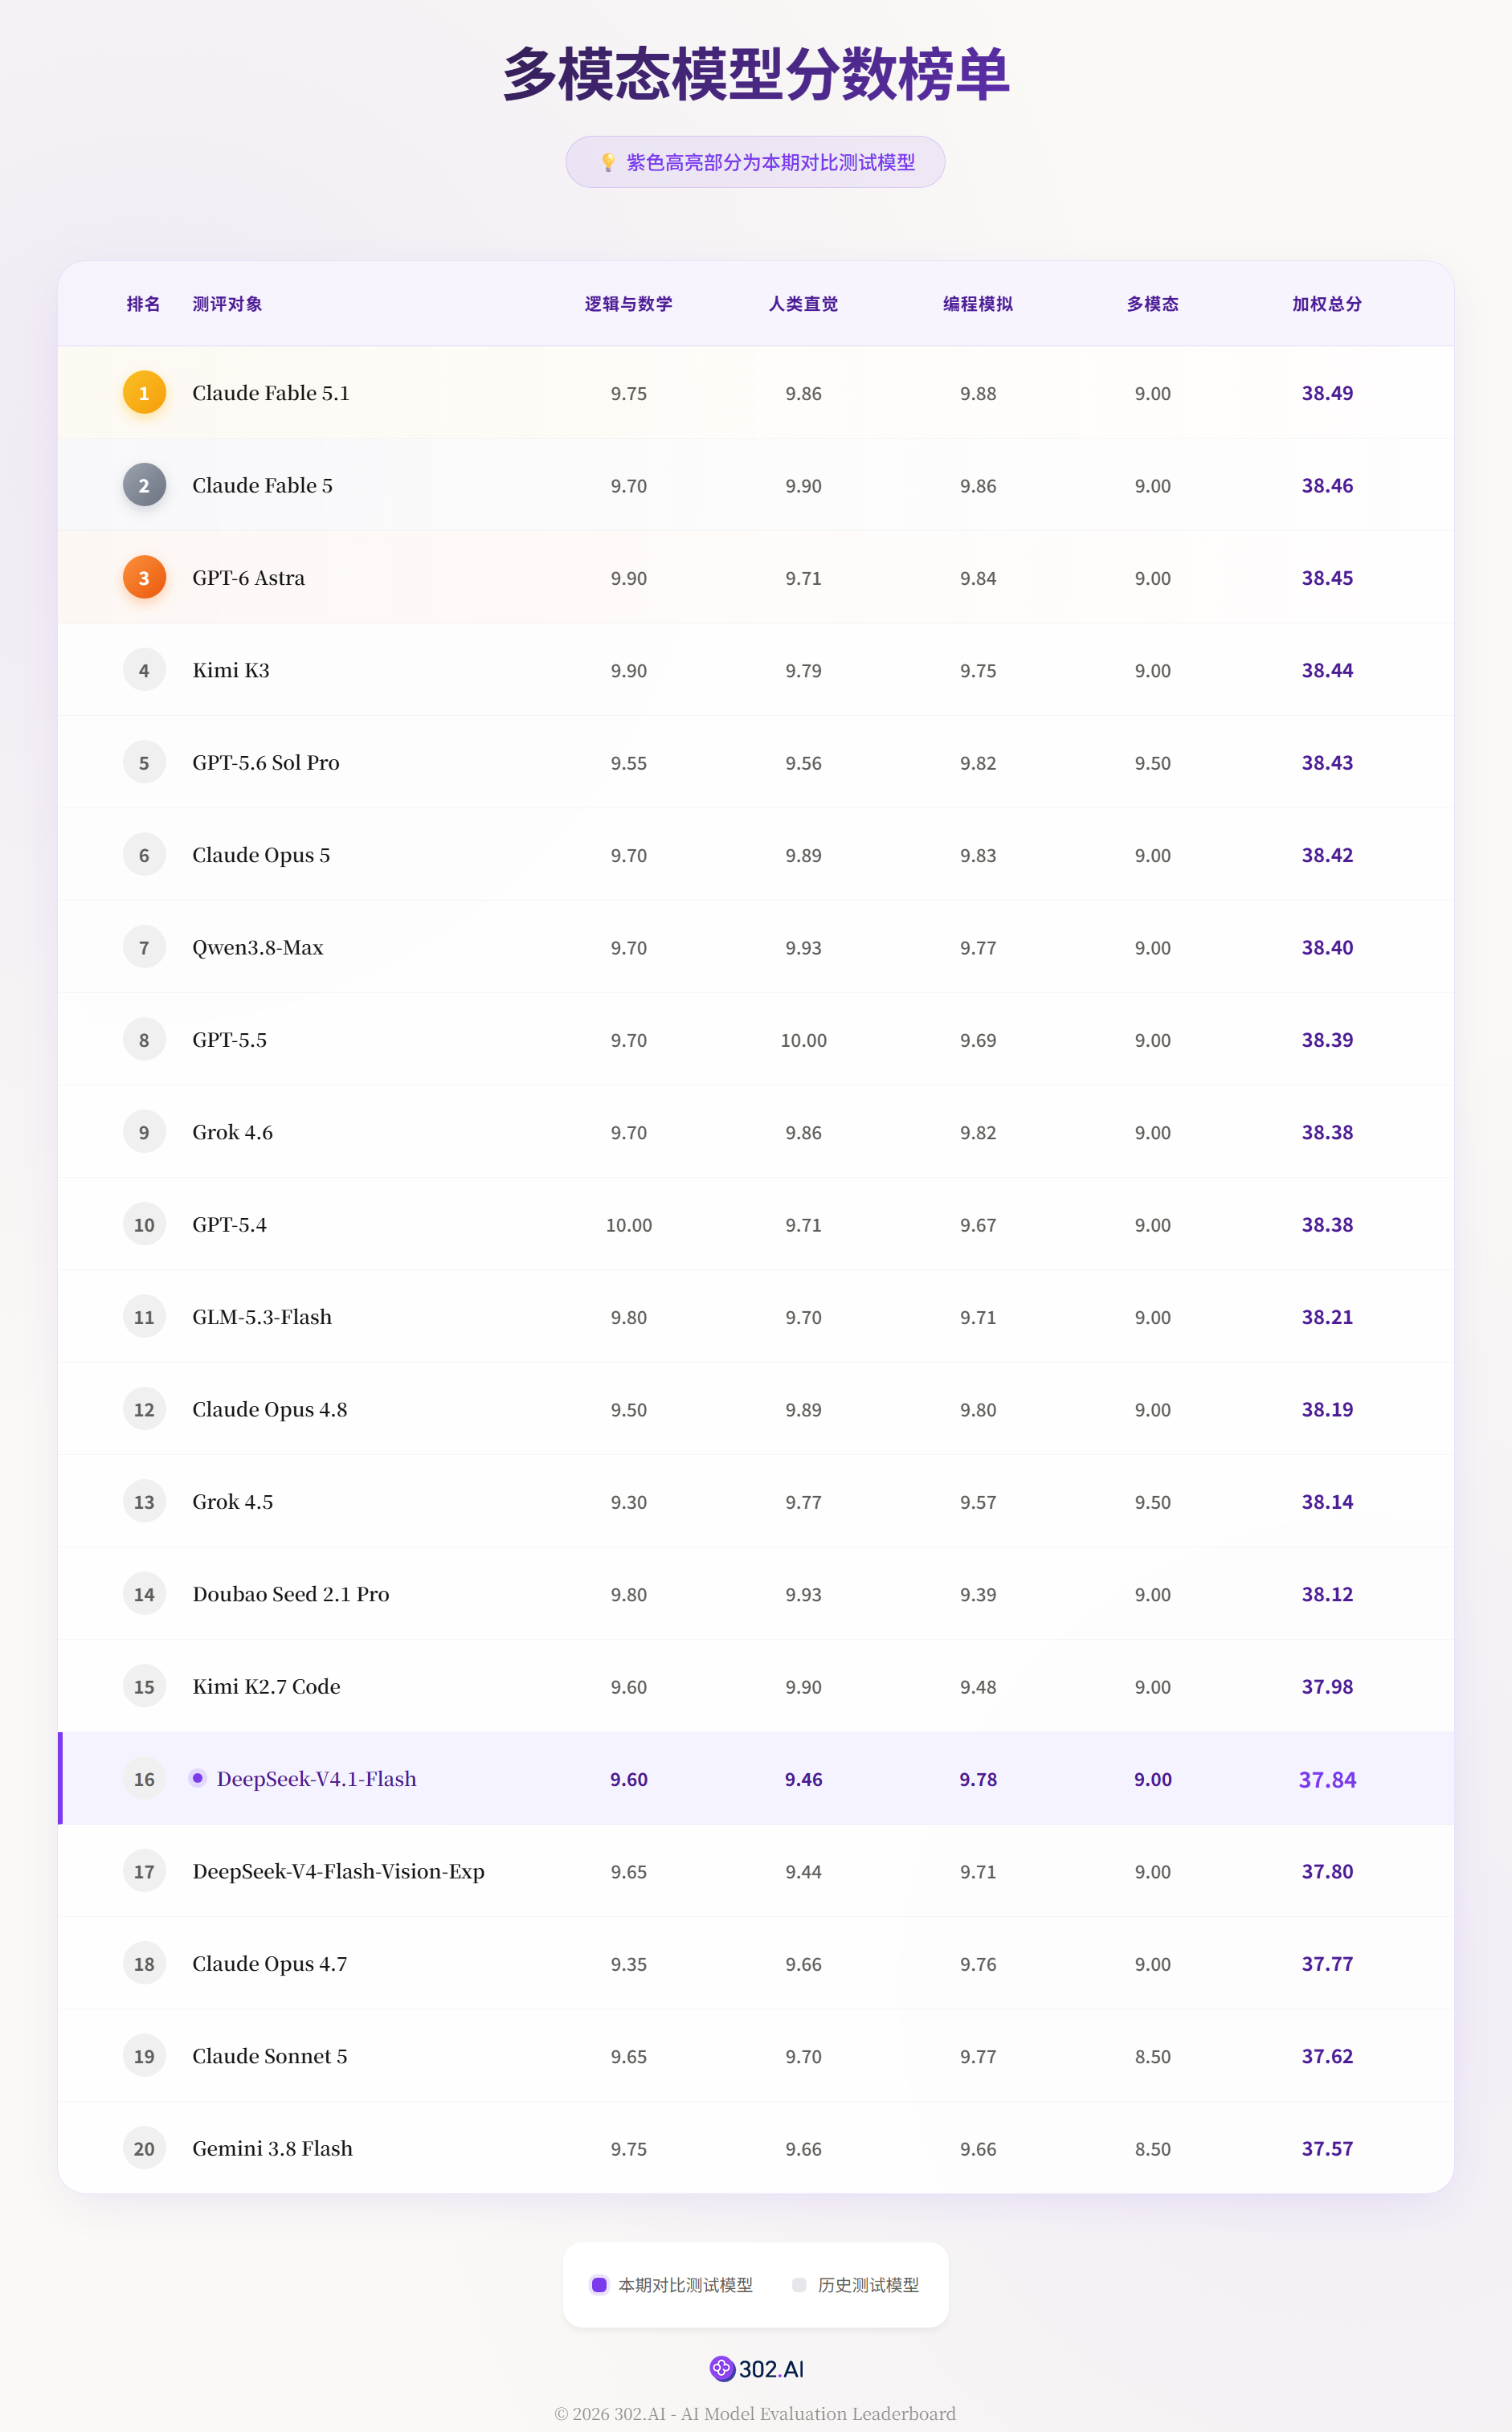
DeepSeek-V4.1-Flash 加权总分 37.84,在榜单中排第 16;分项为逻辑与数学 9.60、人类直觉 9.46、编程模拟 9.78、多模态 9.00。
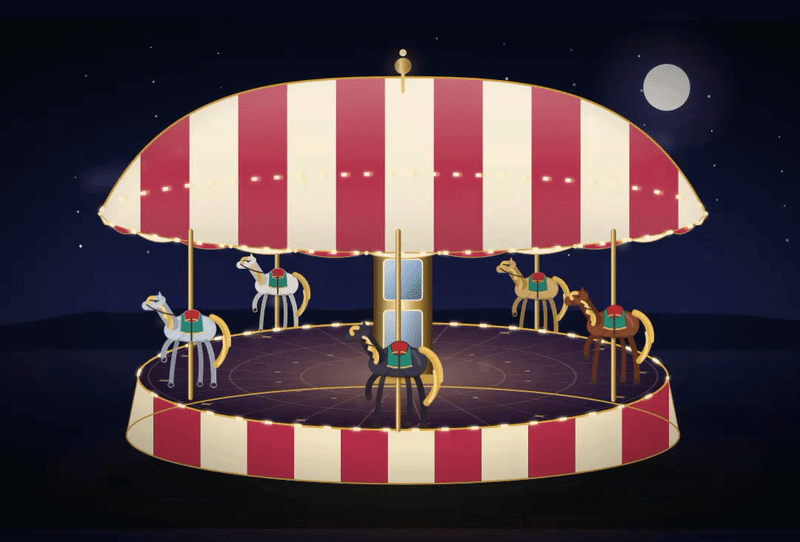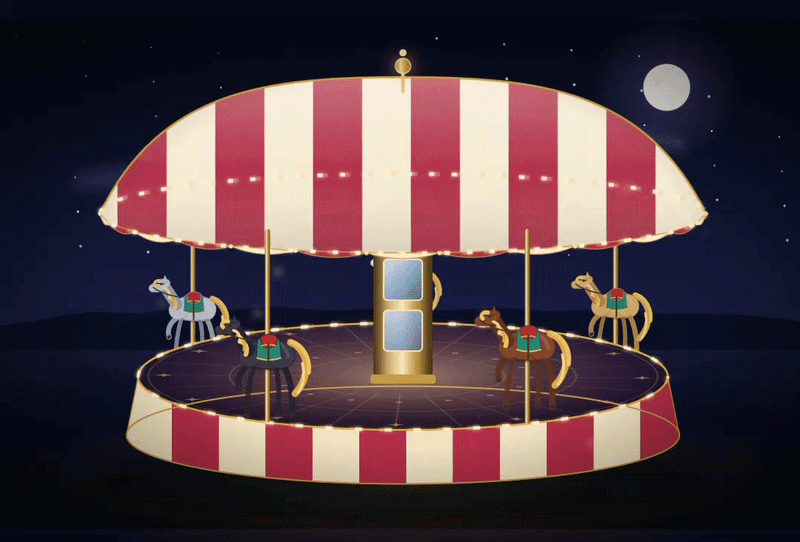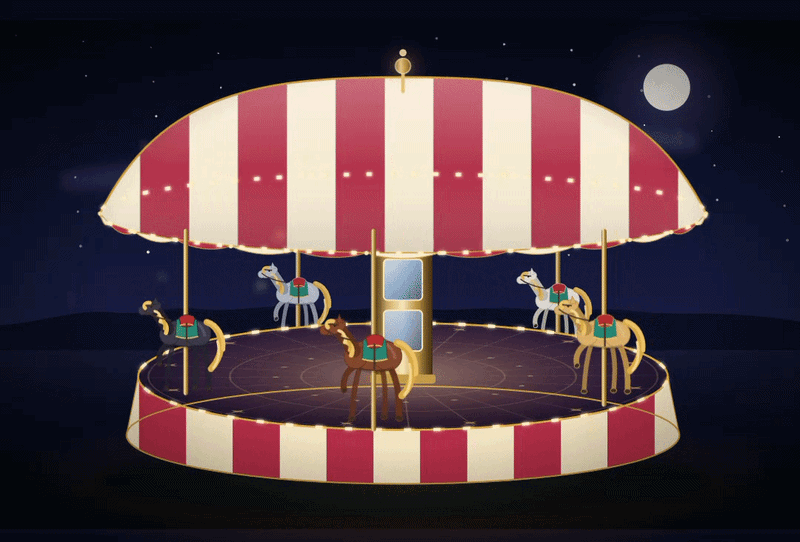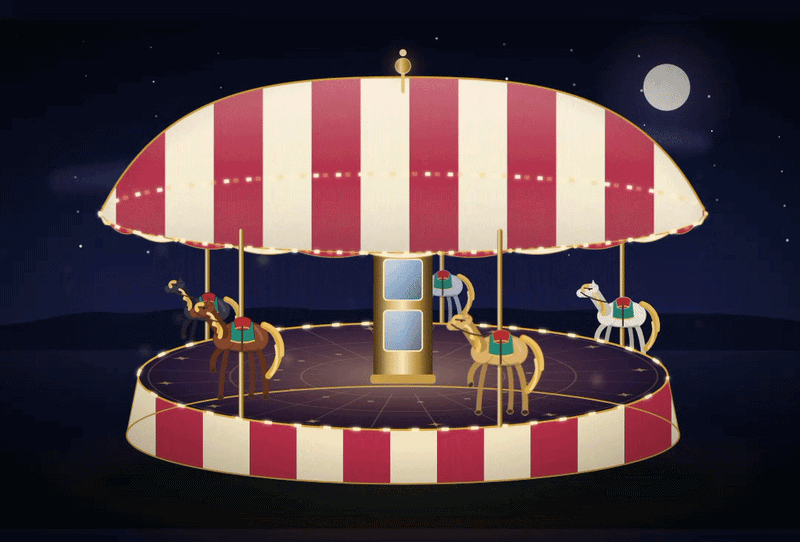
提示词一:绘制一幅旋转木马正在运作的动态 SVG 图。
提示词二:绘制一幅滑板少年腾空完成 Ollie 的动态 SVG 图。
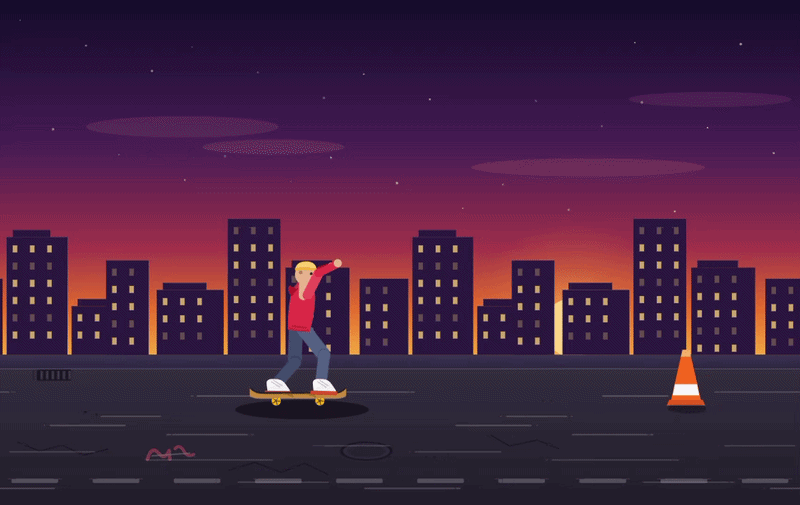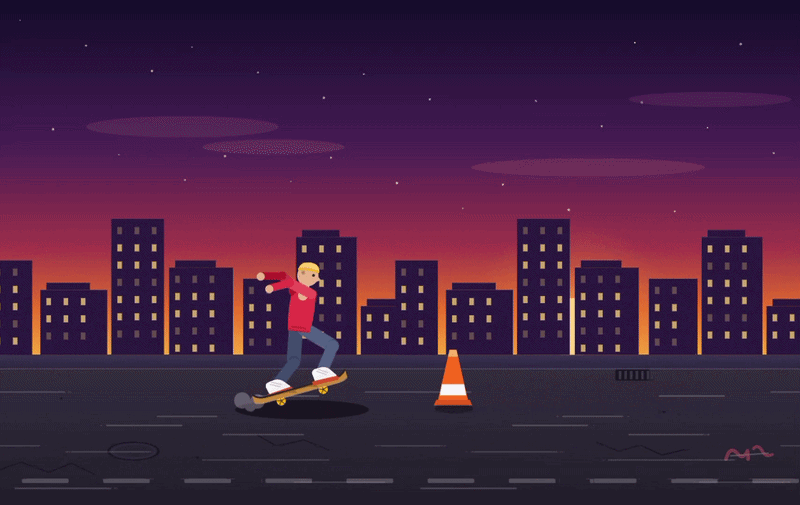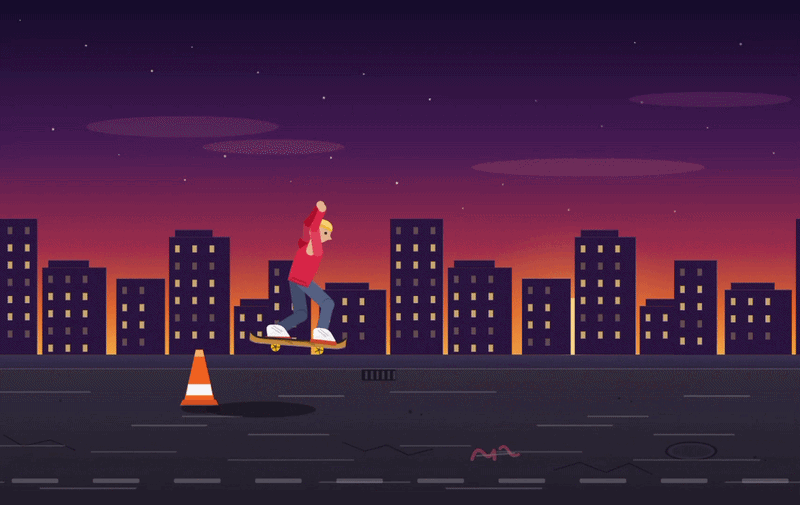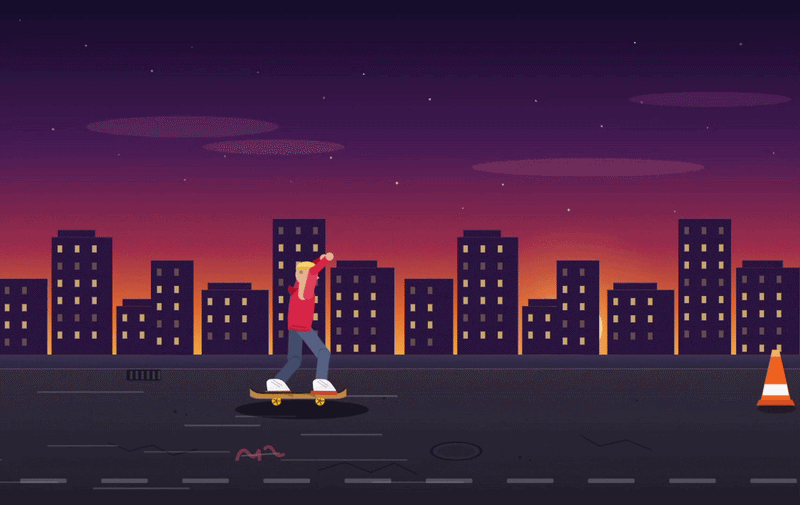
简评:V4.1 Flash 输出的图形构成复杂度和场景氛围都比较到位,只在动态表现上有较明显的瑕疵。例如滑板少年的腿部关节在起跳、悬空和落地时都有变化,但手部动作不合理。
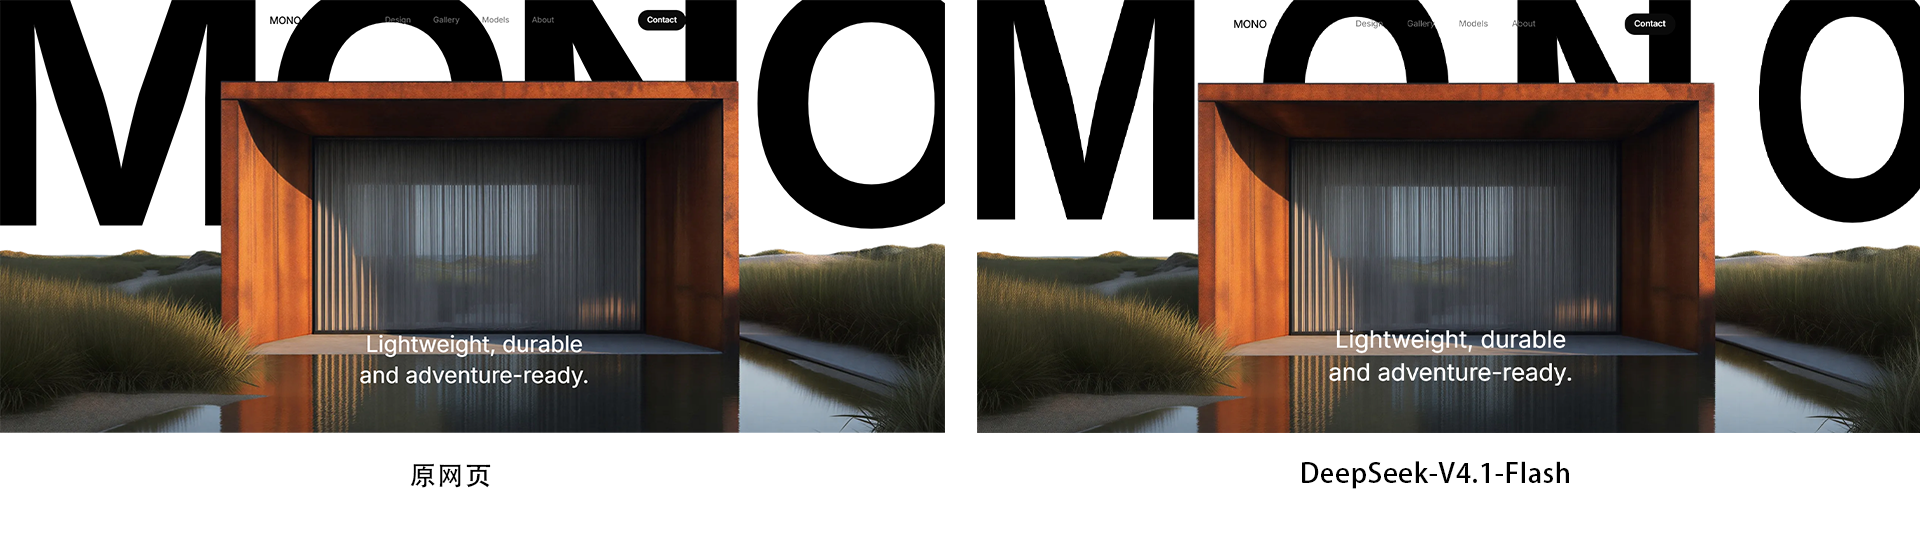
给定网址 v0.app 上的 Mono 电商模板,要求模型像素级复刻网页。
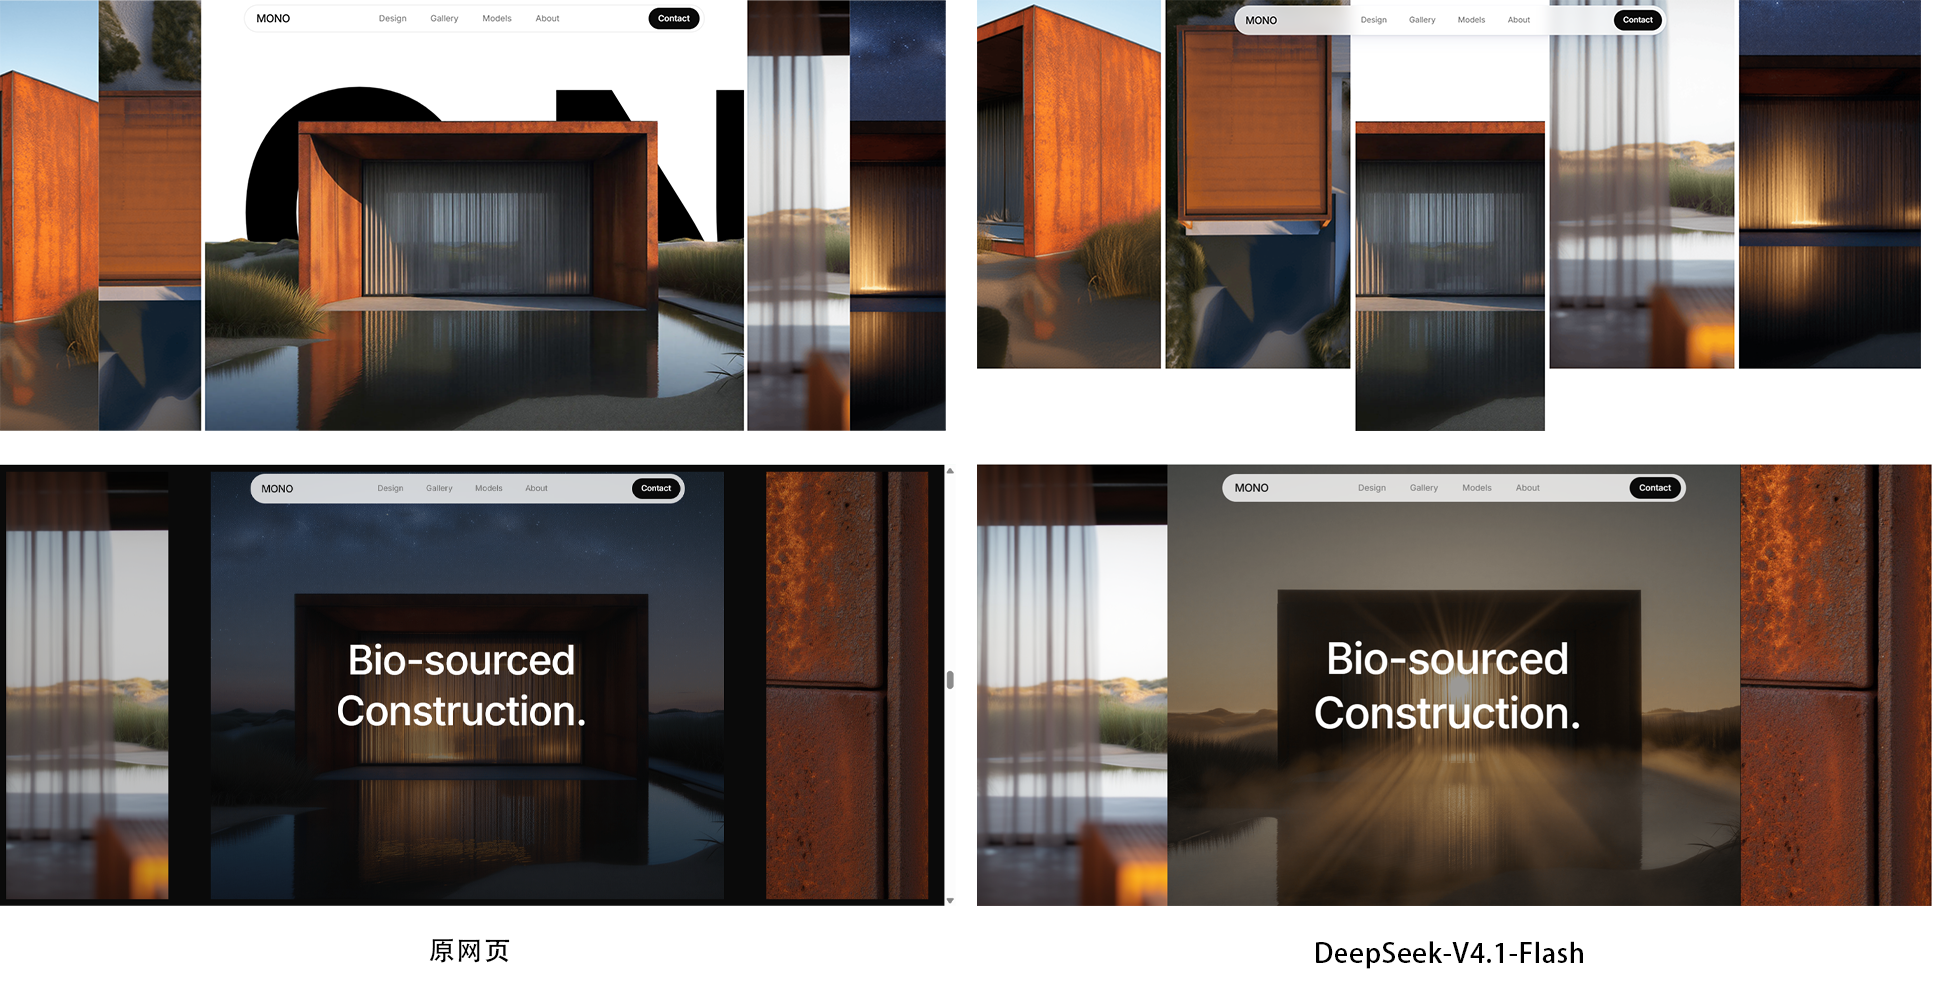
简评:整体还原度较高,网页基本结构得到完整复刻,动效实现也与原网页基本一致,只在以下细节上存在区别。
字体差异:
排版差异:
提示词(英文原文):
Create a single-page HTML 3D animation using Three.js.

Build a clean product-style scene with a transparent rectangular box containing about 30 colorful balls.

Animation:
1. The box slowly tilts to one side, causing the balls to fall out naturally.
2. The balls roll, bounce, and collide with each other and the ground.
3. After a short pause, the balls gradually roll back toward the box.
4. The balls enter the box and settle back inside.
5. The animation then loops.

Requirements:
- Use Three.js and JavaScript.
- Simulate basic gravity, velocity, collision, bouncing, and friction.
- Avoid balls passing through each other, the box, or the ground.
- The balls should have natural physical movement rather than simply following predefined paths.
- Add soft lighting, shadows, and a clean light-colored background.
- Add Play / Replay controls.
- Allow mouse drag to rotate the camera and scroll to zoom.
- Make the layout responsive.

Focus on realistic physics and smooth transitions. Avoid clipping, floating, teleportation, or obviously scripted-looking movement.本题以 DeepSeek-V4-Pro 的同题输出作为对照。
简评:DeepSeek-V4.1-Flash 输出的小球倾倒模拟器,在建模质感、比例关系和控制面板上的完成度都明显优于 V4 Pro;最关键的动态表现同样完成得出色,小球运动没有出现明显违背物理逻辑的情况。
提示词(英文原文):
Create a polished, cinematic 3D railway simulator entirely in Three.js. Build a continuous countryside railway where a passenger train travels from a small station through a village, dense forest, mountain valley, dramatic bridge, and dark tunnel before emerging beside a beautiful lake.
Procedurally generate the train, tracks, terrain, trees, buildings, bridges, tunnels, signals, and other environmental details without Blender or external 3D assets. Give the train realistic motion with rotating wheels, subtle suspension, headlights, and smoke, while adding moving cars, birds, animated water, and swaying vegetation to make the world feel alive.
Use cinematic camera movements that follow the train, reveal wide landscapes, and showcase key moments along the journey. Make the environment gradually shift from warm countryside to mysterious forest, dramatic mountains, and a bright lakeside finale. Prioritize visual richness, smooth animation, atmospheric lighting, and a strong sense of scale while keeping everything performant in the browser.优势:
不足:
虽然 V4.1 以 Flash 为后缀命名,但它展现出了接近甚至超越 V4 Pro 的能力。在本次涉及的编程、3D 场景构建、物理模拟和多模态任务中,它都有较高的完成度与稳定性,部分案例的实际表现比 V4 Pro 更出彩。
最直观的进步在编程。SVG 动态图、网页复刻、Three.js 铁路模拟器和小球物理模拟几项任务,都能看出 V4.1 Flash 拆解和实现复杂需求的能力有所提升。3D 小球倾倒案例尤其典型:模型要同时处理场景建模、重力、碰撞、反弹、摩擦、箱体倾斜和交互控制,最终在建模质感、比例关系、控制面板和动态表现上都完成得比较完整,小球运动也没有明显违背物理逻辑。与 V4 Pro 相比,这类综合型 Coding 任务的完成度提升更加直观。在复杂的 Three.js 案例里,模型同样能搭建出规模较大的场景,处理灯光、动画和环境细节,并在单文件 4000 行代码的长程任务中持续输出、思考,反复验证交付效果。
原生多模态进一步改善了实际使用体验。图片、截图、图表、PDF 可以直接放进同一套工作流处理,对需要结合视觉信息完成任务的 Agent 更方便,输出内容的视觉审美和整体风格也能保持得较好。再加上更低的 API 价格和更小的 KV Cache,V4.1 Flash 在长上下文、多轮调用和持续执行任务的场景中也有一定优势。
V4.1 Flash 在部分具体任务中超过了 V4 Pro,但上限与真正的主流旗舰模型仍有距离。它在复杂 Coding、3D 场景和 Agent 类任务上已大幅优化,可一旦继续提高任务难度,稳定性仍会波动,例如铁路模拟器中出现的车厢脱轨、植物悬浮和大规模穿模。小球模拟整体完成度不错,但这更多说明它已具备处理复杂任务的能力;要像旗舰模型那样长期保持高质量、独特审美和低错误率,还有一段距离。
从实际使用成本看,V4.1 Flash 也没有形成压倒性的性价比优势。API 价格确实够低,缓存命中后的输入成本尤其有吸引力;但把能力、稳定性和价格放在一起比较,GLM 5.3 Flash 这类同级模型竞争力更强。不同类型任务的成本控制,也很难只用 API 单价一概而论。
转自 302.AI
2026 年 9 月 9 日,距 GPT-6 Astra 发布仅 5 天,OpenAI 又推出了 ChatGPT Images 2.5 的两款图像模型。
OpenAI 在发布稿开头给出了一个数字:每周,人们在 ChatGPT 和 GPT-Image API 中生成的图片超过 30 亿张,折算下来约每秒 5000 张。
如果 AI 绘图还只是小众玩具,迭代的重点自然是画质天花板——画质再突破 10%,圈内就能热闹好几天。但一周 30 亿张已成常态,说明它已经是许多人的生产力工具,属于基础设施;而基础设施的一大痛点,正是生产效率。
因此,这次更新清单里最重要的一条是:生成延迟最高降低 50%,API 单价不变。
这次升级有一个结构性变化,需要先把版本理清。
此前是 GPT-Image-2 一个模型包揽所有任务,无论需求复杂与否都交给它。现在,Images 2.5 在 ChatGPT 中仍是一个模型,在 API 中则拆成了两个:
两款模型的 token 单价完全相同(图像输出每百万 token $30)。据第三方估算,在同等高质量档位下,2.5 的单张实际成本约为上一代的四分之一——效率提高了,每张图消耗的 token 也就少了。
一句话概括这次的产品升级:不再逼用户在“快”和“好”之间二选一,而是把两个答案分别装进两个接口。
官方这次更新了四个方向:参考图保真、精准编辑、多轮一致性、智能与风格。前两项最容易让人惊叹,但真正的分水岭是第三项。
参考图保真。给一张真人照片,生成的图里仍是同一个人,五官、神态和辨识度在风格变换之后依然得以保留。第三方实测中有一个出圈案例:一张用鼠标画的粗糙猫咪涂鸦被转成写实照片,再追加一句指令只改瞳孔颜色,其余部分纹丝不动。
精准编辑。“只改指定的部分”从碰运气变成了可以兑现的承诺。替换海报里的一个产品、改掉派对合照里的一件衣服,构图、光线和周围细节都原样保留。对电商和营销团队来说,改图不再等于从头再来。
多轮编辑一致性。用过 AI 绘图的人大多经历过这样的场景:第 1 轮生成,很满意;第 2 轮改个背景,脸有点歪了;第 3 轮想把脸改回来,衣服款式又没了……每一轮编辑都像重新摇号,改上十轮,画面早已面目全非。
Images 2.5 的做法是:在多轮对话中记住早期的修改,每次编辑都在已有成果上累加,而不是推倒重来。
这之所以是分水岭,是因为真实的创作从来不是一锤子买卖,而是“生成→不满意→修改→再修改”的循环。多轮编辑不崩,意味着 AI 绘图第一次能够支撑工作流,而不只是支撑灵感。灵感是一次性的,工作流才是生产力。
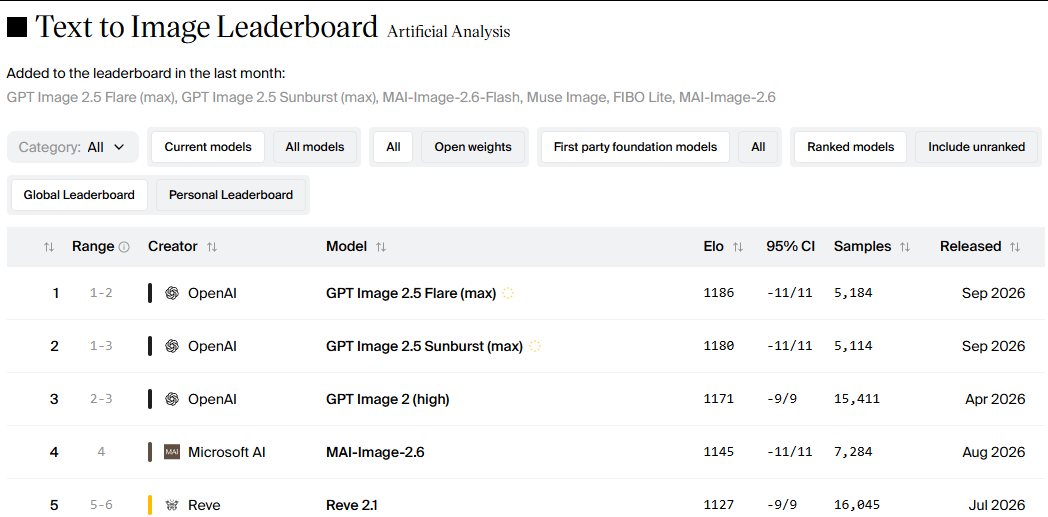
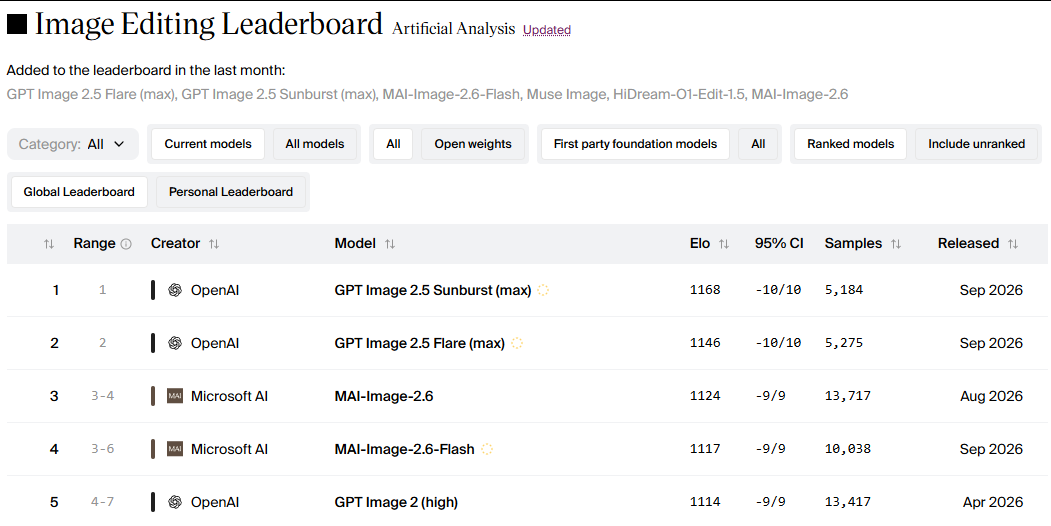
在 Artificial Analysis 的文生图和图像编辑两个榜单中,GPT-Image-2.5 的两款模型分别占据第 1、2 名。
本次实测选用 GPT-Image-2.5 Sunburst,对比长期占据 SOTA 位置的上一代模型 GPT-Image-2,看这次的能力提升能否一眼感知。
提示词:
时尚特写大片:
20岁出头亚洲女性,湿发造型黑长发凌乱贴面,晒伤妆(鼻梁脸颊大面积红腮红),光泽唇,真实皮肤质感带雀斑毛孔。
侧身回眸直视镜头,眼神平静微迷离,唇微启。裸肩,怀中紧抱云朵般的巨大白色褶皱织物,下巴轻靠。
周围环绕巨大超现实花卉,前景背景共同框住头部。背景蓝天深绿树叶。
正午硬光,皮肤与花瓣强烈高光,阴影锐利,盛夏午后氛围。
高饱和时尚超现实主义,粉橙蓝绿强对比,35mm胶片颗粒,皮肤细节真实无磨皮。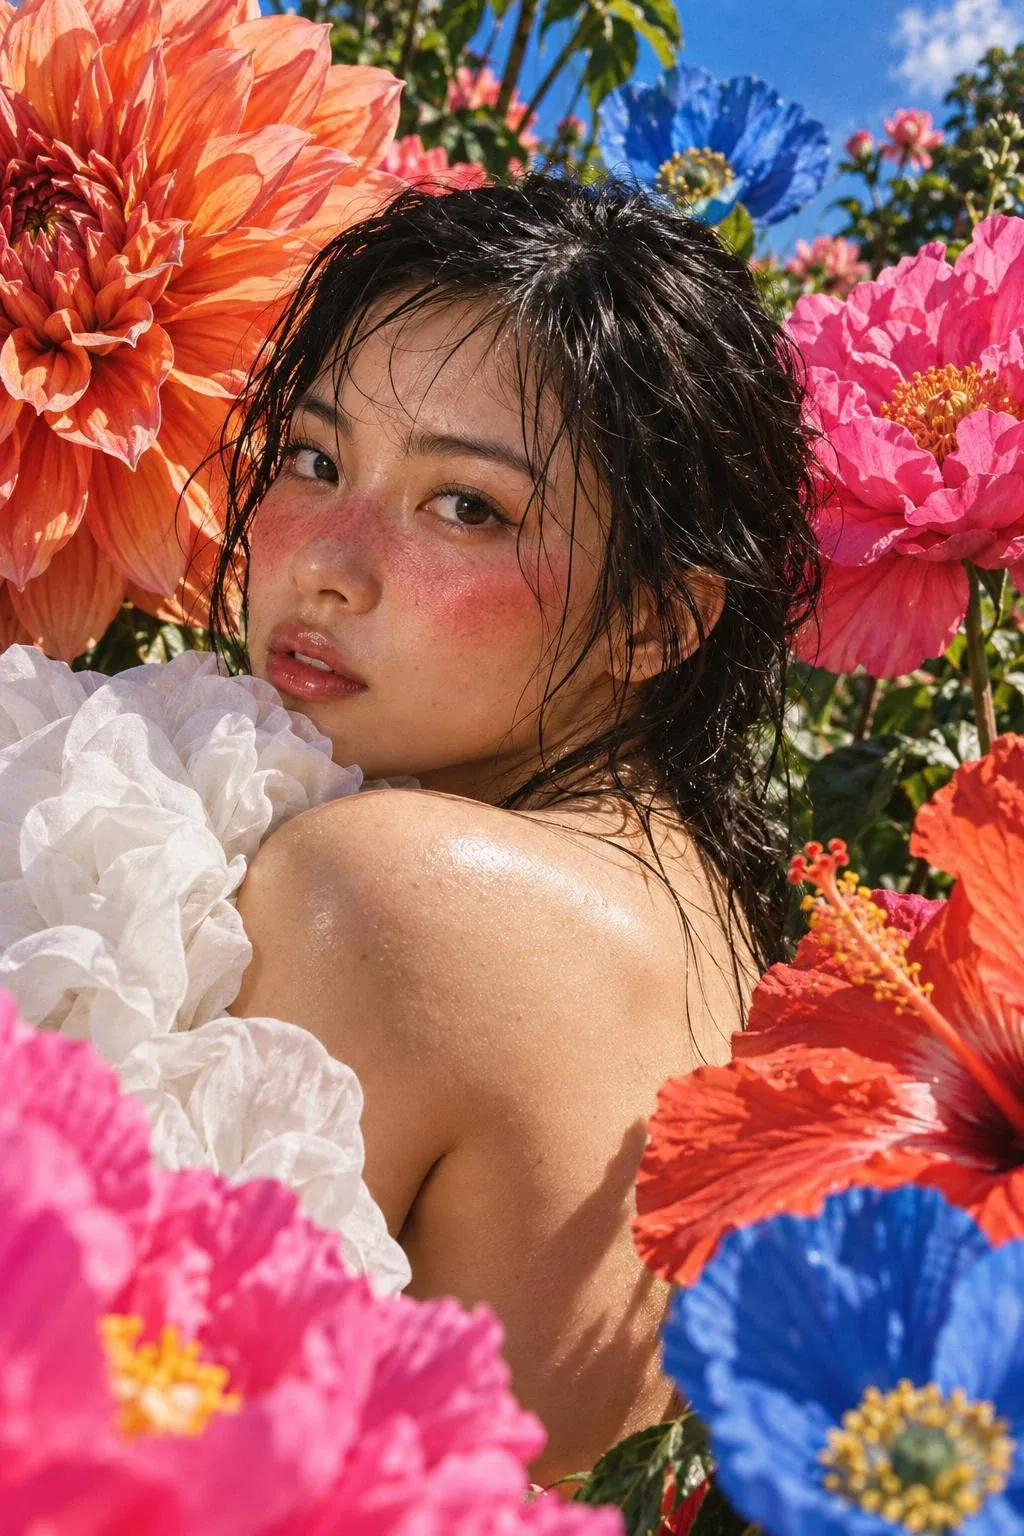
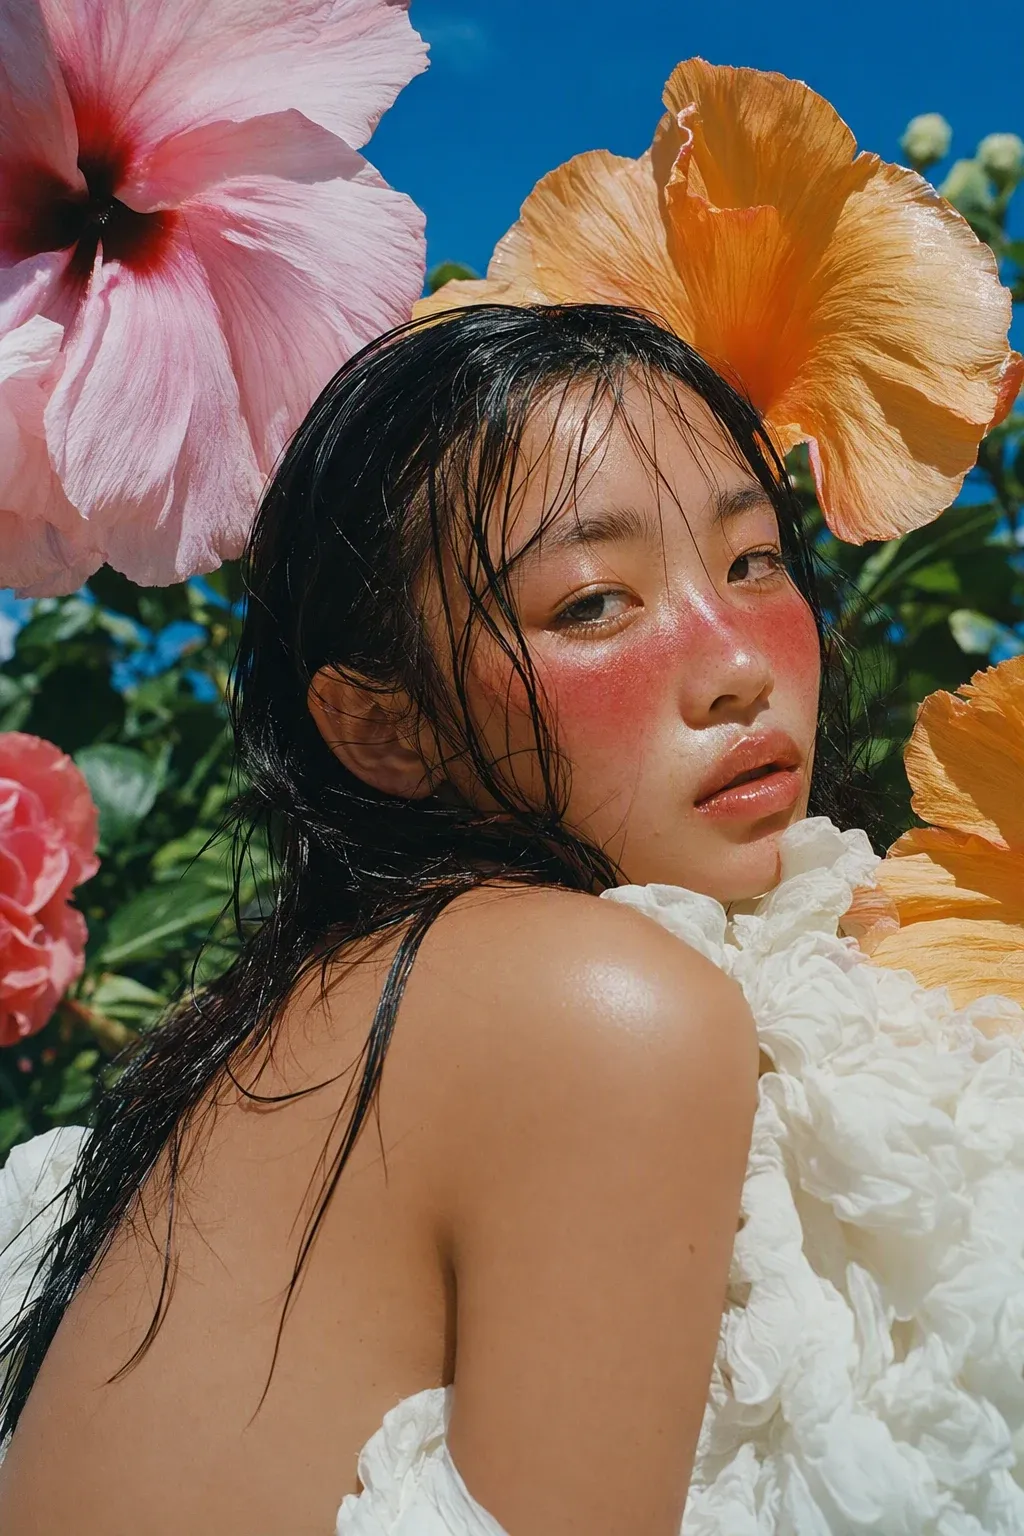
| 模型 | GPT-Image-2.5 Sunburst | GPT-Image-2 |
|---|---|---|
| 评分 | 5/5 | 4.5/5 |
简评:两者都准确遵循了提示词,画面真实、美感在线,主观上喜欢哪张都说得过去。从摄影角度看,2.5 的花卉形态细节更丰富,包含花蕊和前景,景深层次更饱满;光线打在模特背上,也增强了画面的立体感。
提示词:
一幅色彩缤纷、抽象风格的花卉摄影作品,带有强烈的运动模糊效果。画面中充满了由各种花朵和茎叶交融晕染而成的粉色、黄色、蓝色与绿色色块。画面正中以白色衬线字体书写着小写文字 “more art merch coming soon”。整体氛围轻盈而富于奇思妙趣。右下角有一个小巧的圆形白色标志。
| 模型 | GPT-Image-2.5 Sunburst | GPT-Image-2 |
|---|---|---|
| 评分 | 5/5 | 3/5 |
简评:2.5 胜在两点。一是失焦和慢门效果控制在合理范围,能轻松看出拍摄对象是花卉(GPT-Image-2 的画面显然过于抽象);二是文字和 logo 尺寸克制、不抢戏,排版合理。
提示词:
一幅超现实的照片,拍摄于现代办公室内的一名男子,画面呈倒置构图,仿佛重力已经消失。
他身穿一套深蓝色正装西服。他的头部靠近地面,双腿向上延伸至天花板方向。他的双手抬至躯干附近,掌心朝上,身体呈现出自然的紧绷感,仿佛悬停于半空。
办公室环境完全正常且真实——房间内的一切都没有被改变,看起来就是一间典型的日常办公室。室内有一张木质办公桌,墙面漆成非常浅的淡绿色。然而,唯有这名男子及其周围的物体漂浮在半空中,营造出强烈的失重感与一种受控的混乱。
一部带螺旋线的白色台式电话正处于分裂的动态瞬间——听筒朝一个方向飘散,而话机底座则独立漂浮。一只咖啡杯悬停在附近。其他办公用品也在漂浮:一台笨重的老式电脑显示器、配套的老式键盘、一只鼠标,以及一把办公椅——它们以不同的姿态漂移,轻微旋转并倾斜。一盆红色天竺葵花盆栽同样悬浮在空中,增添了一抹鲜明的色彩对比。
窗户敞开着,正午明媚的阳光倾泻入室。窗外,德黑兰自由广场的景色清晰可见。一只鸽子飞入室内,同样悬停于半空,双翅微张,仿佛动作被定格。光线明亮、高调而干净,呈现极简美学风格。色彩基调柔和、略微降低饱和度,富有电影感。整体氛围强调超现实主义、失重感,被定格的瞬间。
| 模型 | GPT-Image-2.5 Sunburst | GPT-Image-2 |
|---|---|---|
| 评分 | 4.5/5 | 4/5 |
简评:一眼就能看出两张图出自同一模型系列,色调、空间布局和构图高度相似。2.5 的瑕疵在于:左上角的办公椅有扭曲变形,电话线不连贯,有断开感。
提示词:
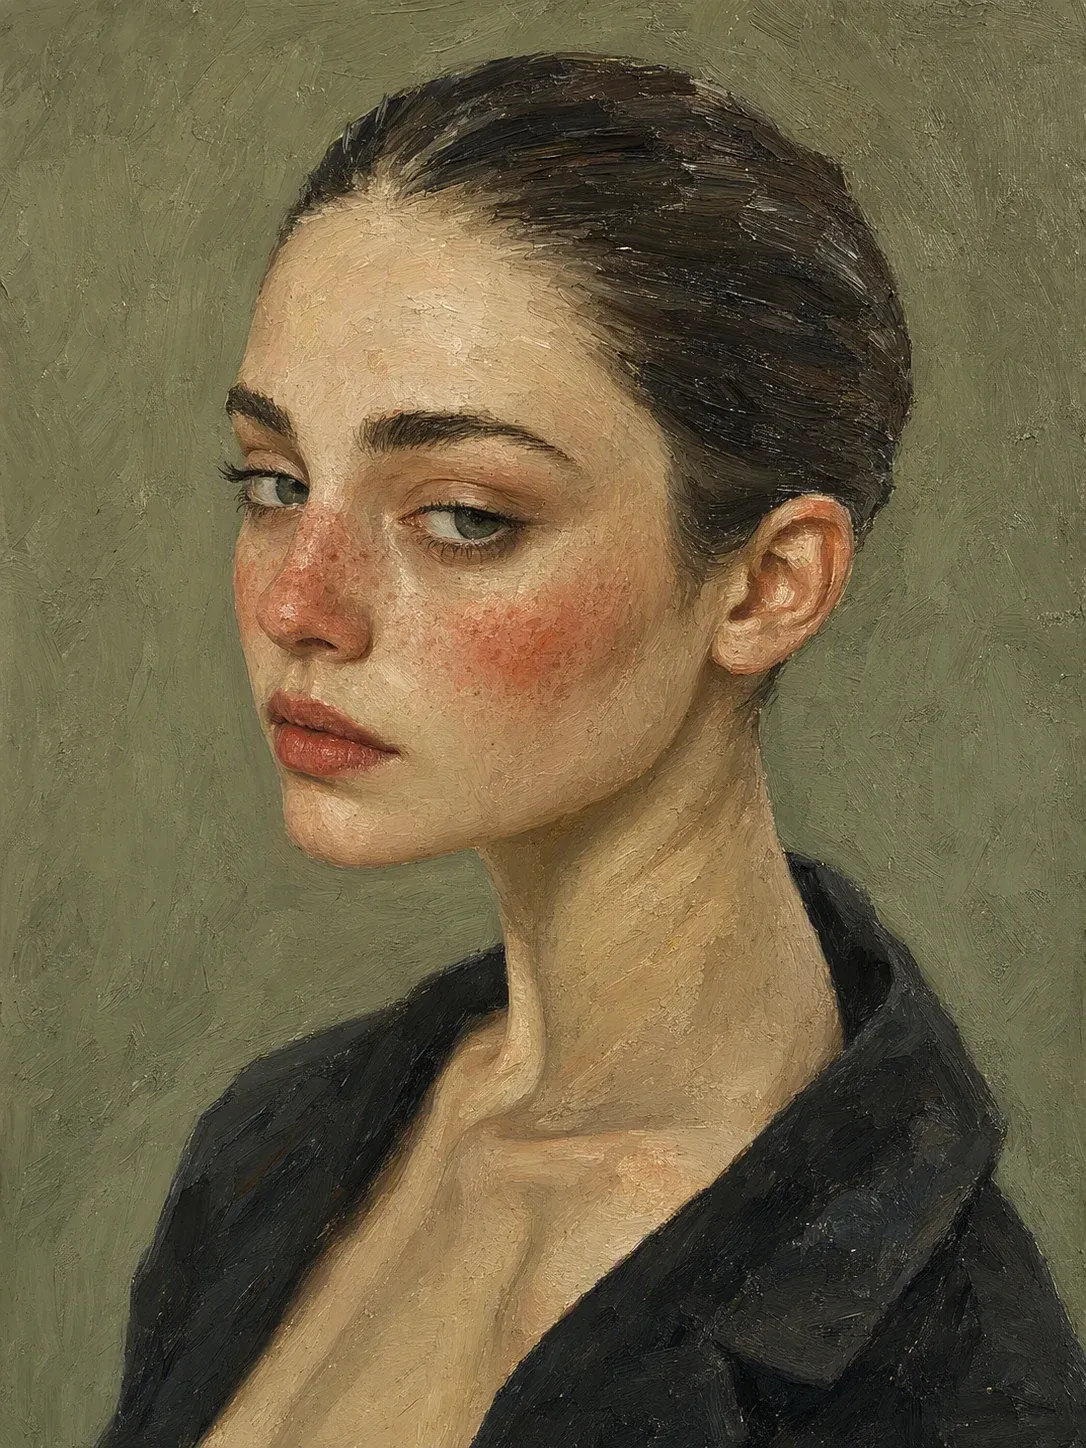
一幅富有表现力的油画肖像:一位年轻女子越过裸露的肩头直视观者,特写构图。肤色白皙、肌理分明,可见雀斑,脸颊与鼻尖呈现自然的红晕,灰绿色的眼睛,浓密的天然眉形。她的神情——目光低垂,端庄含蓄,睫毛投下柔和的阴影。她的头发整体向后梳得油光服帖,露出整张脸庞。她身穿一件炭灰色西装外套,锁骨裸露。
背景:鼠尾草绿/橄榄绿背景布,可见绘画性的笔触肌理,无任何景物。柔和的漫射自然光从左前方照入,在面部形成轻柔的造型过渡,没有生硬的阴影。
风格:当代表现主义油画,厚涂笔触清晰可见,头发与织物处是粗犷的有方向性的笔触,手绘帆布质感,柔和的莫兰迪式大地色系(白、黑、鼠尾草绿、带红橙点缀的暖肤色),博物馆级肖像画,杰作。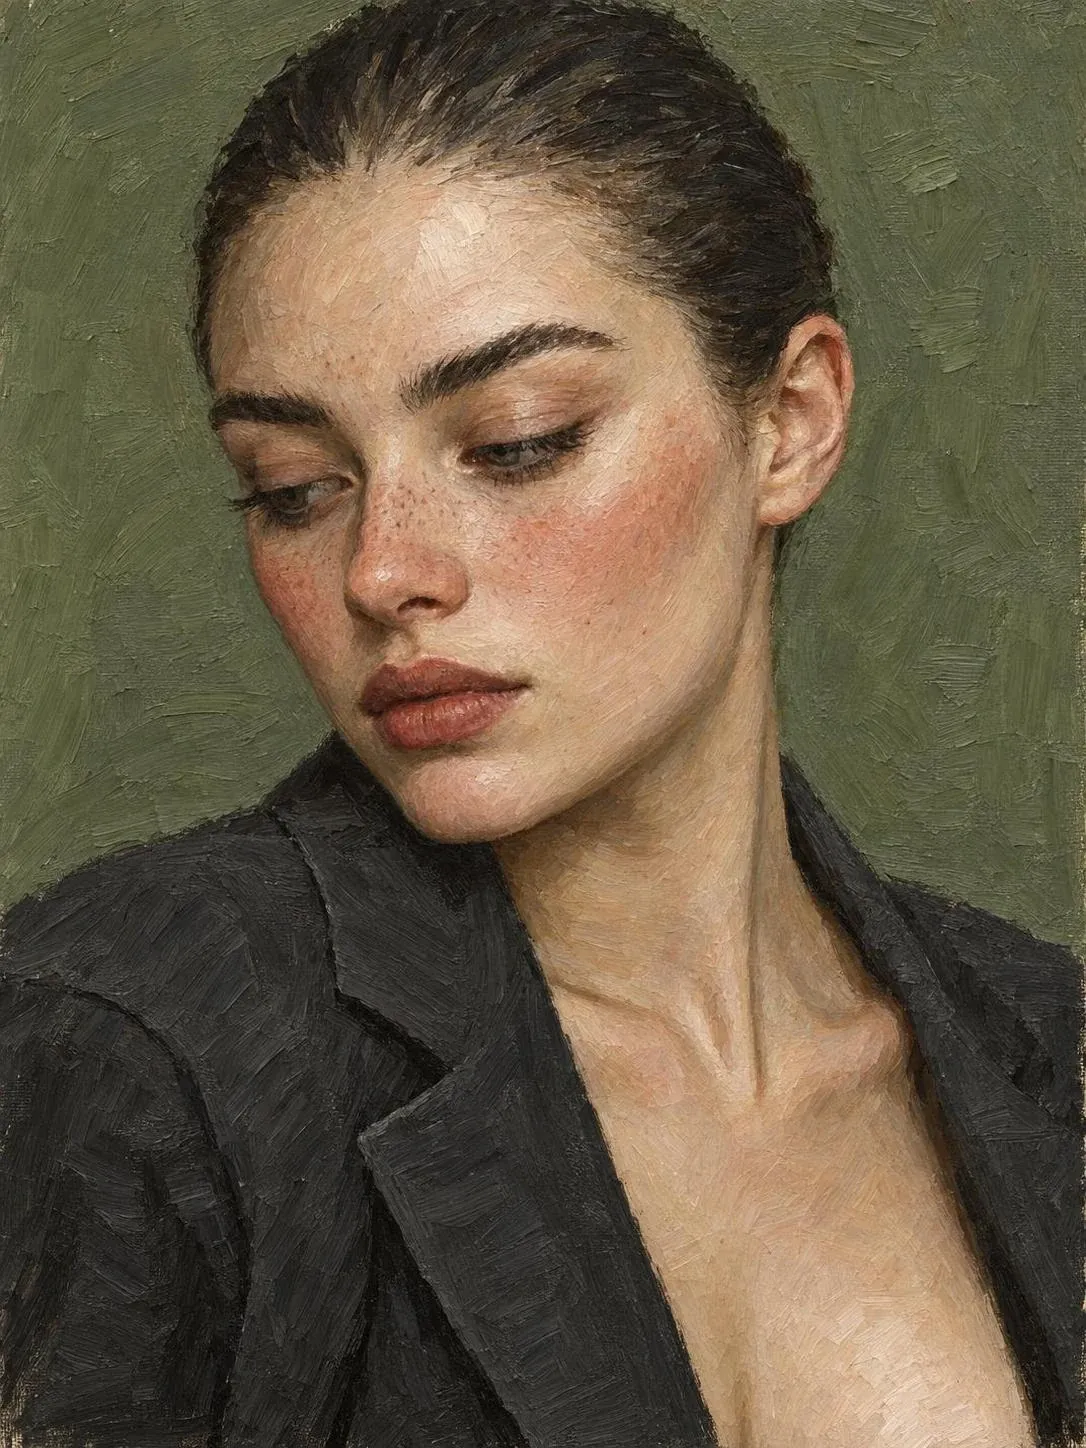
| 模型 | GPT-Image-2.5 Sunburst | GPT-Image-2 |
|---|---|---|
| 评分 | 4/5 | 5/5 |
简评:两幅画最明显的区别在于女子的视线朝向。提示词原文是“一位年轻女子越过裸露的肩头直视观者”,显然 GPT-Image-2 的还原更准确。此外,在女子的形象、神态以及整体笔触与色调美感上,两款模型都没有明显问题。
提示词(原文):
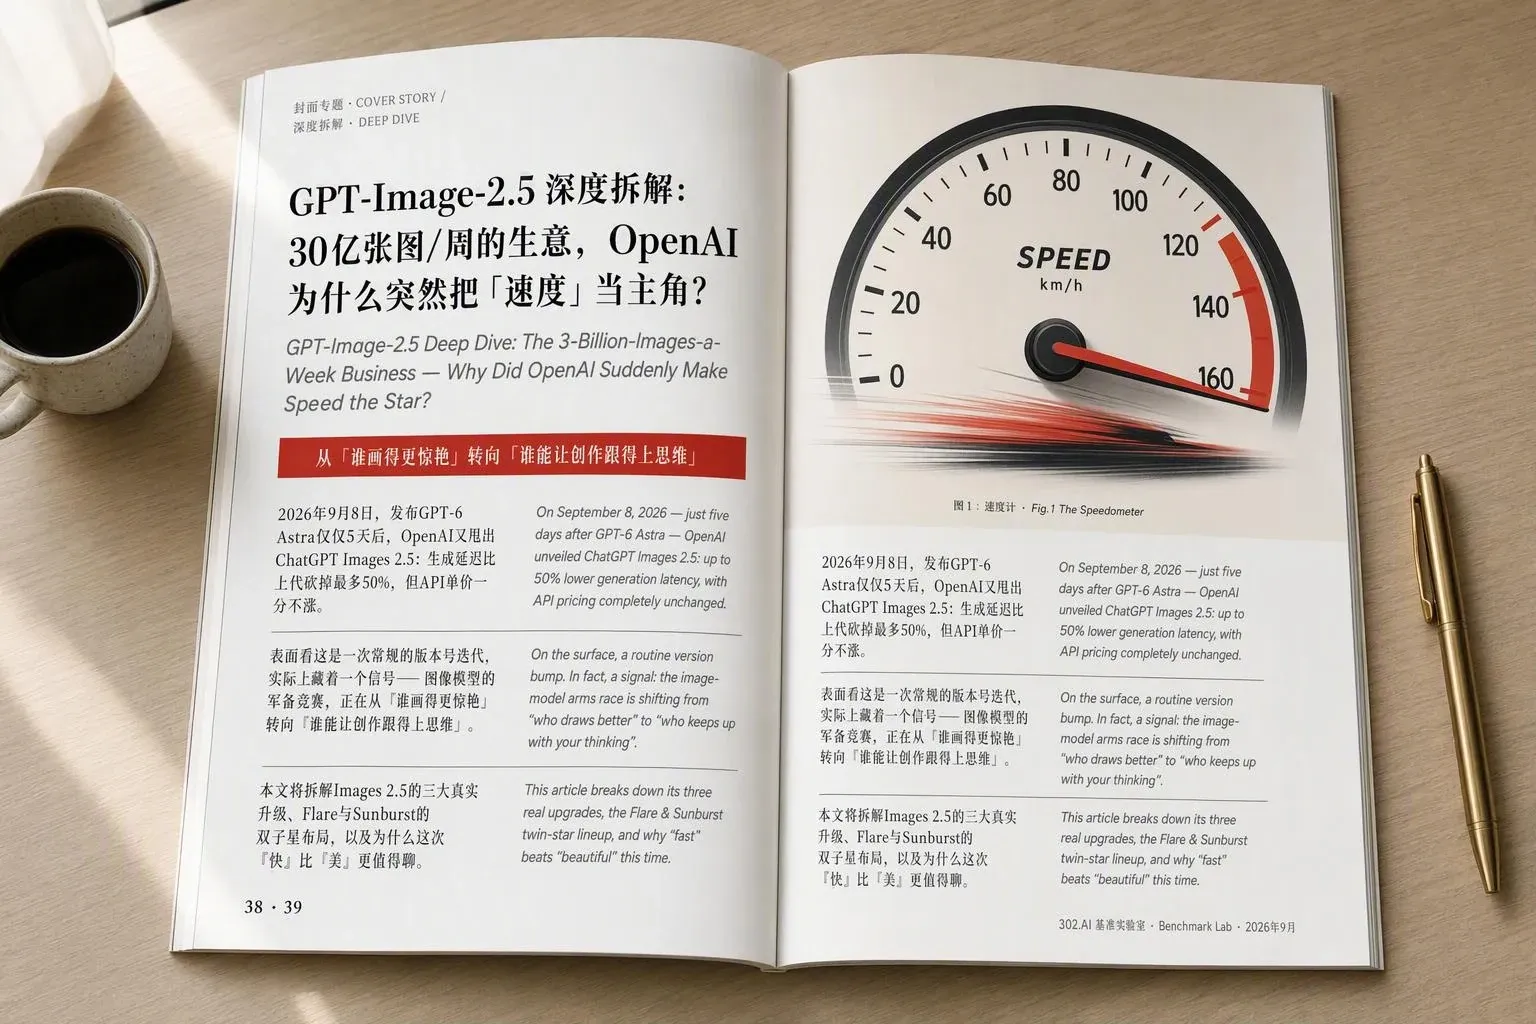
A photorealistic overhead shot of an open premium design magazine lying flat on a minimalist light-oak desk, soft natural window light from the left, a matte ceramic coffee cup and a brass pen resting nearby, shallow depth of field, editorial photography.
The magazine’s two-page spread displays a full article, typeset in a clean modern editorial layout (large display title, pull-quote, body columns, page numbers “38 · 39”). ALL TEXT MUST BE RENDERED EXACTLY AS WRITTEN BELOW, correctly spelled, no gibberish, no missing or fused strokes:
LEFT PAGE — header label in small caps gray: “封面专题 · COVER STORY /
深度拆解 · DEEP DIVE” Title block, bold serif Chinese, two lines: 「GPT-Image-2.5 深度拆解: 30亿张图/周的生意,OpenAI 为什么突然把「速度」当主角?」
Directly beneath, English title in lighter italic sans-serif:
“GPT-Image-2.5 Deep Dive: The 3-Billion-Images-a-Week Business — Why Did OpenAI Suddenly Make Speed the Star?”
A red pull-quote strip: 「从『谁画得更惊艳』转向『谁能让创作跟得上思维』」
BODY TEXT in three bilingual column pairs (Chinese paragraph followed by its English translation in smaller gray type):
Paragraph 1: “2026年9月8日,发布GPT-6 Astra仅仅5天后,OpenAI又甩出 ChatGPT Images 2.5:生成延迟比上代砍掉最多50%,但API单价一分不涨。”
Translation 1: “On September 8, 2026 — just five days after GPT-6 Astra — OpenAI unveiled ChatGPT Images 2.5: up to 50% lower generation latency, with API pricing completely unchanged.”
Paragraph 2: “表面看这是一次常规的版本号迭代,实际上藏着一个信号—— 图像模型的军备竞赛,正在从『谁画得更惊艳』转向『谁能让创作跟得上思维』。”
Translation 2: “On the surface, a routine version bump. In fact, a signal: the image-model arms race is shifting from ‘who draws better’ to ‘who keeps up with your thinking’.”
Paragraph 3: “本文将拆解Images 2.5的三大真实升级、Flare与Sunburst的 双子星布局,以及为什么这次『快』比『美』更值得聊。”
Translation 3: “This article breaks down its three real upgrades, the Flare & Sunburst twin-star lineup, and why ‘fast’ beats ‘beautiful’ this time.”
RIGHT PAGE — a large editorial illustration occupies the top half:
a stylized speedometer whose needle points past the red zone, rendered in flat magazine illustration style with the same red accent color as the pull-quote; caption beneath it in tiny type: “图1:速度计 · Fig.1 The Speedometer”. The bottom half continues the body columns. Footer:
“302.AI 基准实验室 · Benchmark Lab · 2026年9月”.
Typography: Chinese in a Song-style serif (思源宋体 feel), English in Inter; crisp, print-quality glyph rendering at legible small sizes; Paper has a subtle matte sheen where the window light crosses it.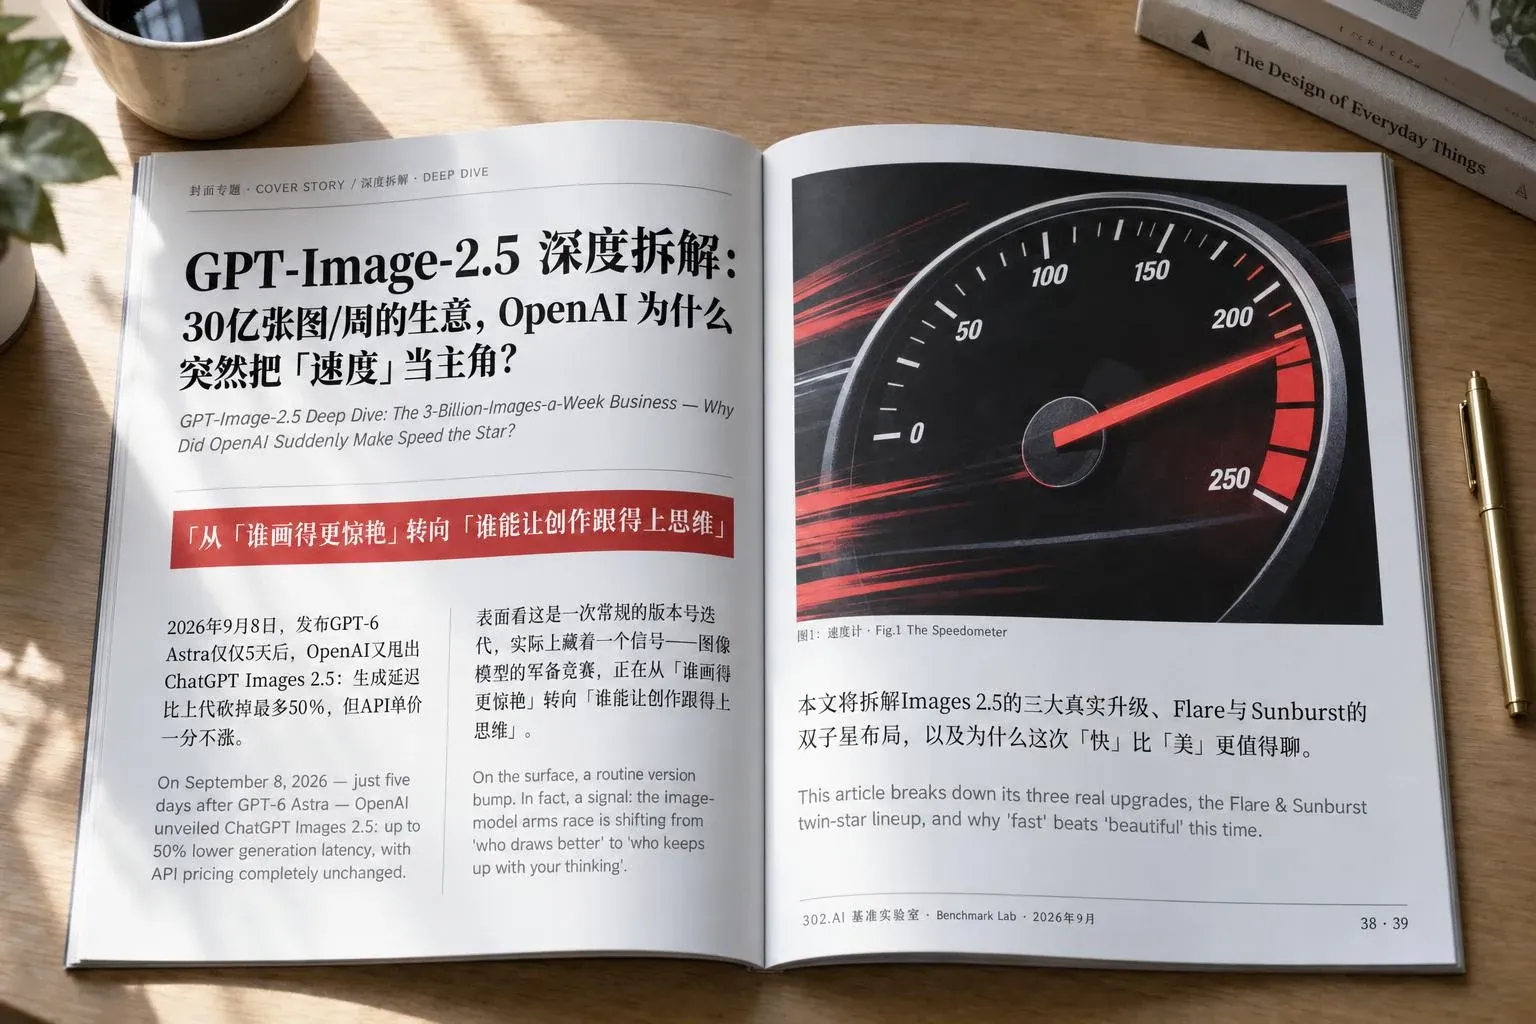
| 模型 | GPT-Image-2.5 Sunburst | GPT-Image-2 |
|---|---|---|
| 评分 | 5/5 | 3.5/5 |
简评:2.5 胜出。文字方面,两组结果均未出现乱码或模糊。2.5 胜在整体画面真实度更高,光影和质感更接近实拍效果;杂志图文排版合理,页眉页脚布局得当。GPT-Image-2 生成的杂志左右两页文字内容重复,部分排版不符合阅读逻辑。
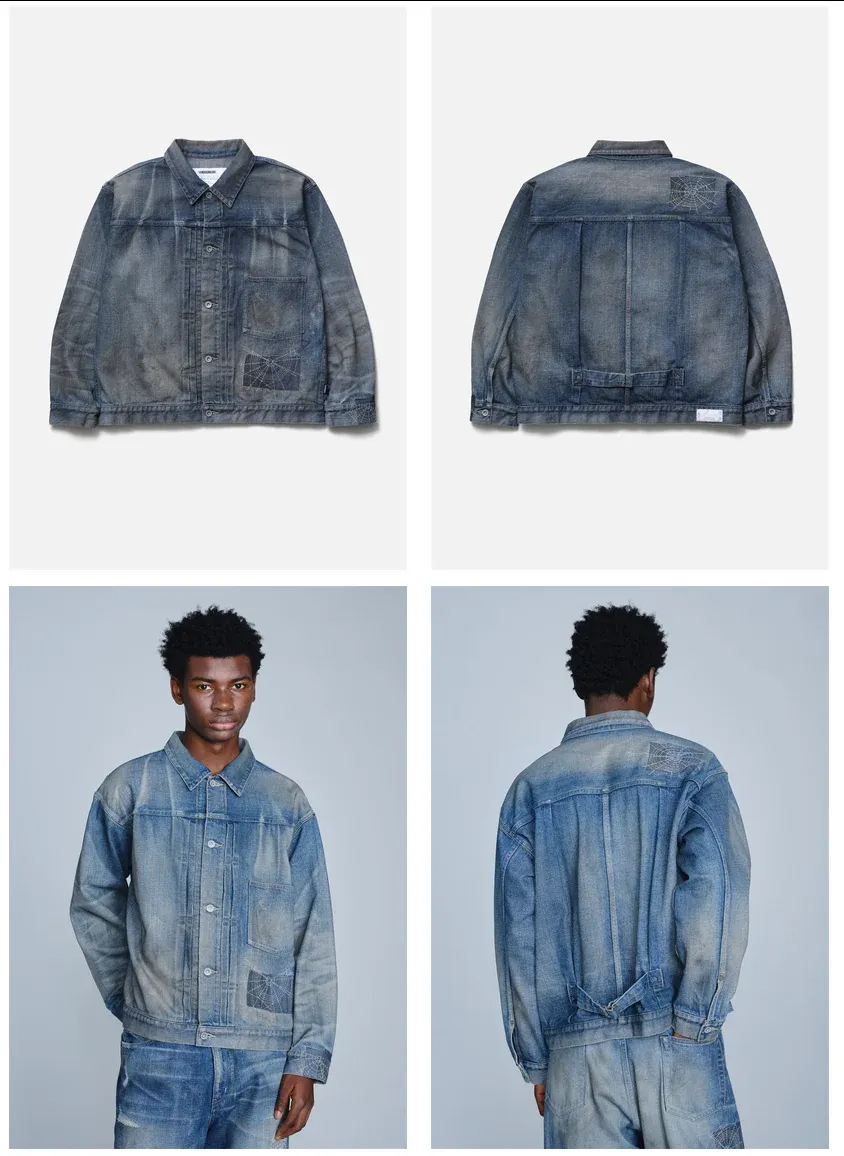
提示词:
单页电商产品详情页设计,美式复古工装(workwear heritage)美学风格,基于4张参考图。牛仔夹克的款式设计必须与参考照片保持100%一致——同样的水洗靛蓝丹宁、同样的蜘蛛网刺绣贴片、同样的后背束带下摆、同样的银色纽扣——并沿用参考图中的同一位模特。不得改动夹克的设计或模特的身份特征。
版式布局(竖版电商页面,3:4比例):
顶部主视觉区:奶油色/米白色纸质纹理背景。大号复古标题使用粗体西部板状衬线字体:”SAVAGE DENIM”,其上方有一条较小的拱形横幅,写着 “TYPE-1 JACKET”,另有一枚做旧橡胶印章风格的徽章:砖红色圆形内的 “$699″。副标语使用窄体无衬线字体:”Heavyweight washed indigo denim. Built to outlive you.”
中部:展示夹克的正面与背面——正面视图较大,置于左侧;背面视图略小,置于右侧;两者均抠图呈现,在奶油色背景上带有柔和的投影。
下半部分:两张模特照并排放置在复古相框内,纸边略微撕裂——正面姿势与背面姿势——并施加微妙的暖调胶片颗粒处理。
底栏:深靛蓝色横条配白色字体:”14oz Selvedge Denim — Spiderweb Embroidery — Cinch Back — Limited Run”,以及一个砖红色小按钮:”ADD TO CART”。
色彩基调:奶油色 #F2EBDC、丹宁靛蓝 #2E4A66、砖红色 #B3402A、墨黑色 #1A1A1A、褪色烟草棕作为点缀色。
字体风格:美式复古招牌风格——标题用粗体板状衬线/西部展示字体,正文用窄体无衬线字体,标签用带字距的小型大写字母,所有字体带有轻微的油墨洇渗和凸版印刷质感。做旧印章与工会标签风格徽章作为装饰元素。
质量要求:专业电商版式设计,网格对齐干净利落,印刷海报级品质,复古美式工装氛围(1950–70年代海报的感觉),无水印,无多余产品,所有英文文字拼写正确且清晰可读。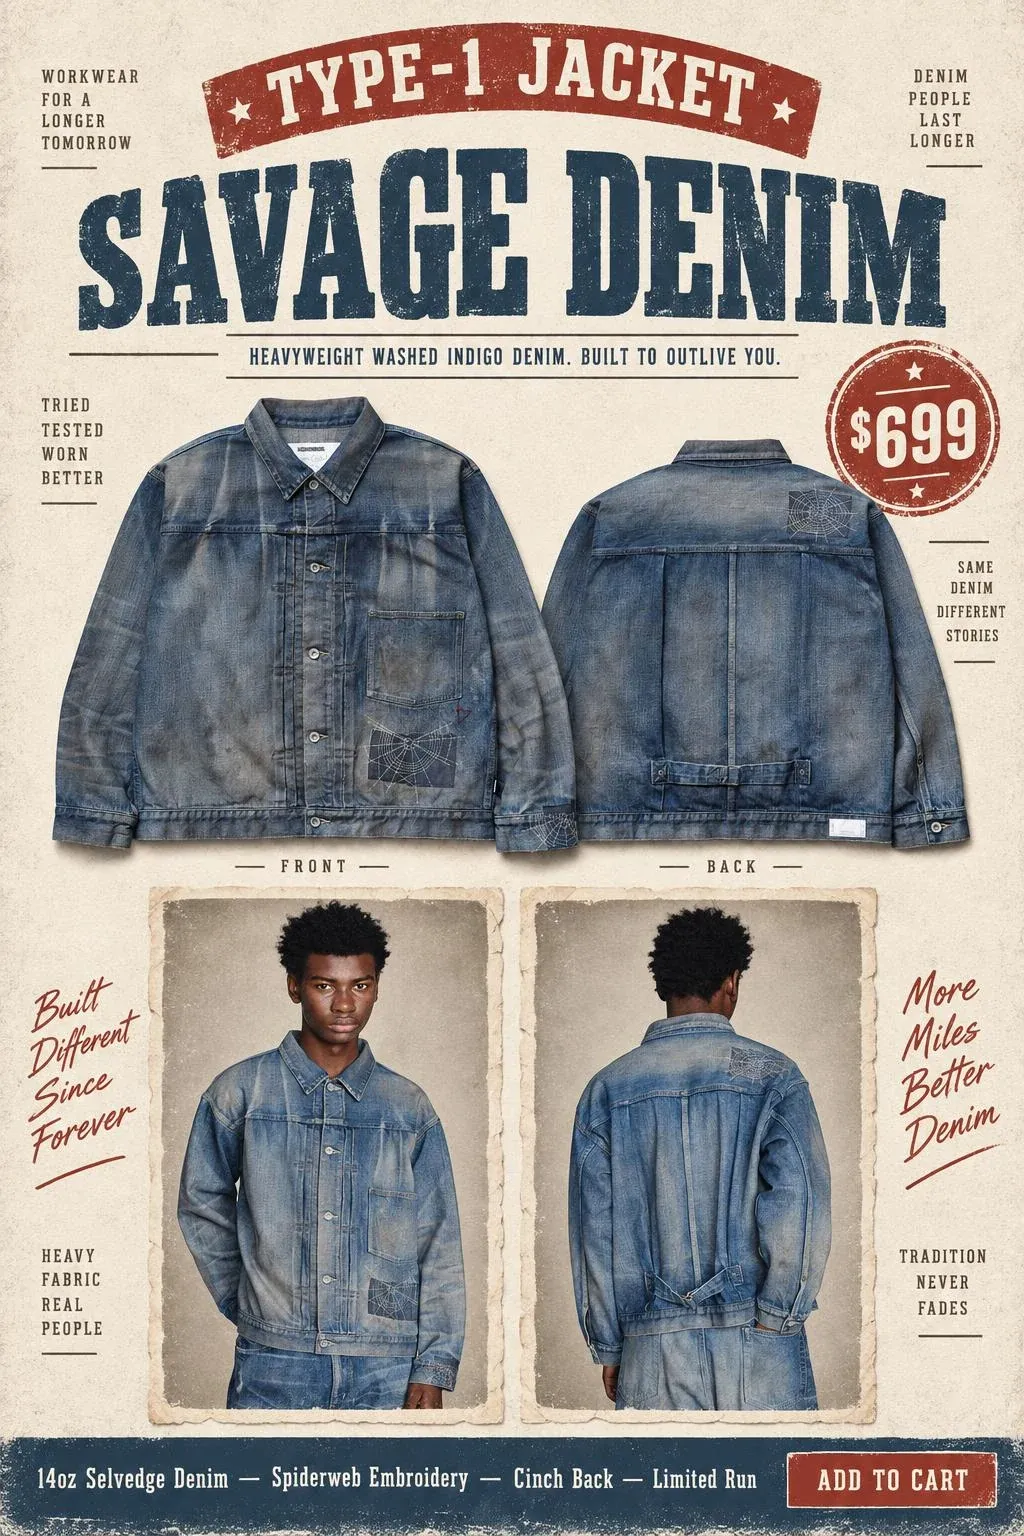
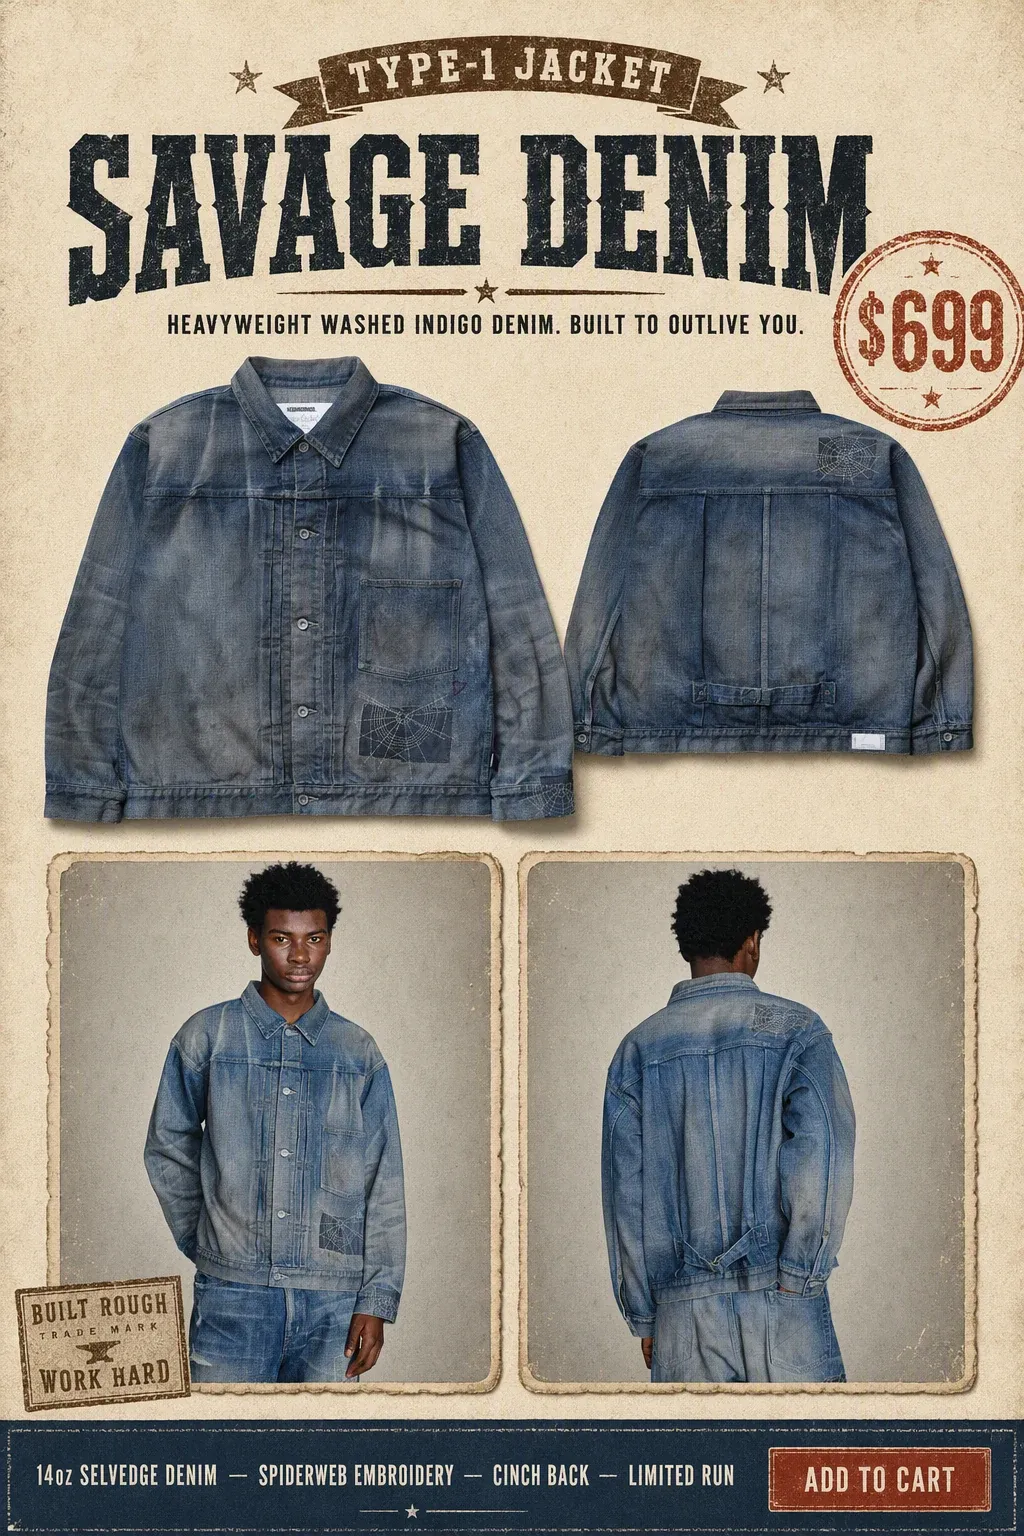
| 模型 | GPT-Image-2.5 Sunburst | GPT-Image-2 |
|---|---|---|
| 评分 | 5/5 | 4/5 |
简评:两者抠图都准确干净,排版布局相近。GPT-Image-2 的排版有明显的失衡问题:标题 SAVAGE DENIM 不居中,左右边距不一致;服装正、背面两张图大小差距过大。2.5 海报的色彩搭配、做旧细节和丰富的装饰性文字,都达到了可以直接交付使用的水平。
提示词:
单一画布上的 2×2 网格,每个格子大小相同,格子之间由细白色间距分隔。四个格子中的主体完全一致。 角色锁定:同一位阿森纳球员——红白主场球衣(红色衣身、白色袖子、”Emirates FLY BETTER” 赞助商字样、阿迪达斯标志、俱乐部徽章、袖口欧冠星球章)、白色短裤、红色球袜,深色长发向后梳拢并微微飘动,左臂有纹身,体格健硕、肤色偏白。场景锁定:夜场足球比赛,泛光灯照亮的绿色草坪,看台上虚化的暗色人群,橙白色 LED 广告板,官方欧冠星球用球(白色球体配黑色星形图案)。照片级写实的职业体育摄影,高速快门凝固动作,浅景深,轻微低机位仰拍,色彩饱和。
将参考图作为图1。
图2:基于参考图:同一位阿森纳球员刚刚完成停球——皮球从他大腿处落下,现已静止在他支撑脚正前方的草地上。他保持直立、姿态平衡的运动站姿,双脚踩在草坪上,抬头观察前方场上局势,目光聚焦远处,双臂微张保持平衡。同样的角色、同样的球衣、同样的泛光灯夜场球场、同样的浅景深。照片级写实体育摄影,全景,动感而克制的瞬间。
图3:同一位阿森纳球员正全力加速向前冲刺,带球推进——足球位于他右脚鞋前半步,深色长发因速度向后飞扬,身体前倾呈驱进式奔跑。他身后,一名身穿宝蓝色配白色点缀球衣的切尔西防守球员正全力伸体追赶,手臂抓向他的肩膀,略微失焦。同样的泛光灯夜场球场与虚化人群,背景带运动模糊,焦点清晰锁定阿森纳球员。照片级写实体育摄影,跟拍镜头质感,低机位。
图4:同一位阿森纳球员已摆脱防守球员并正在射门——经典射门姿态:左腿支撑踩在球侧,右腿摆动完成击球,双臂张开保持平衡,视线锁定目标。欧冠星球球刚刚离开他的鞋面,带有轻微运动模糊。蓝衣切尔西防守球员落后一步,重心不稳,铲抢为时已晚,部分虚化。照片级写实体育摄影,富有戏剧张力的低机位仰拍,高速快门凝固瞬间,皮球与摆动腿上带有细腻的运动模糊。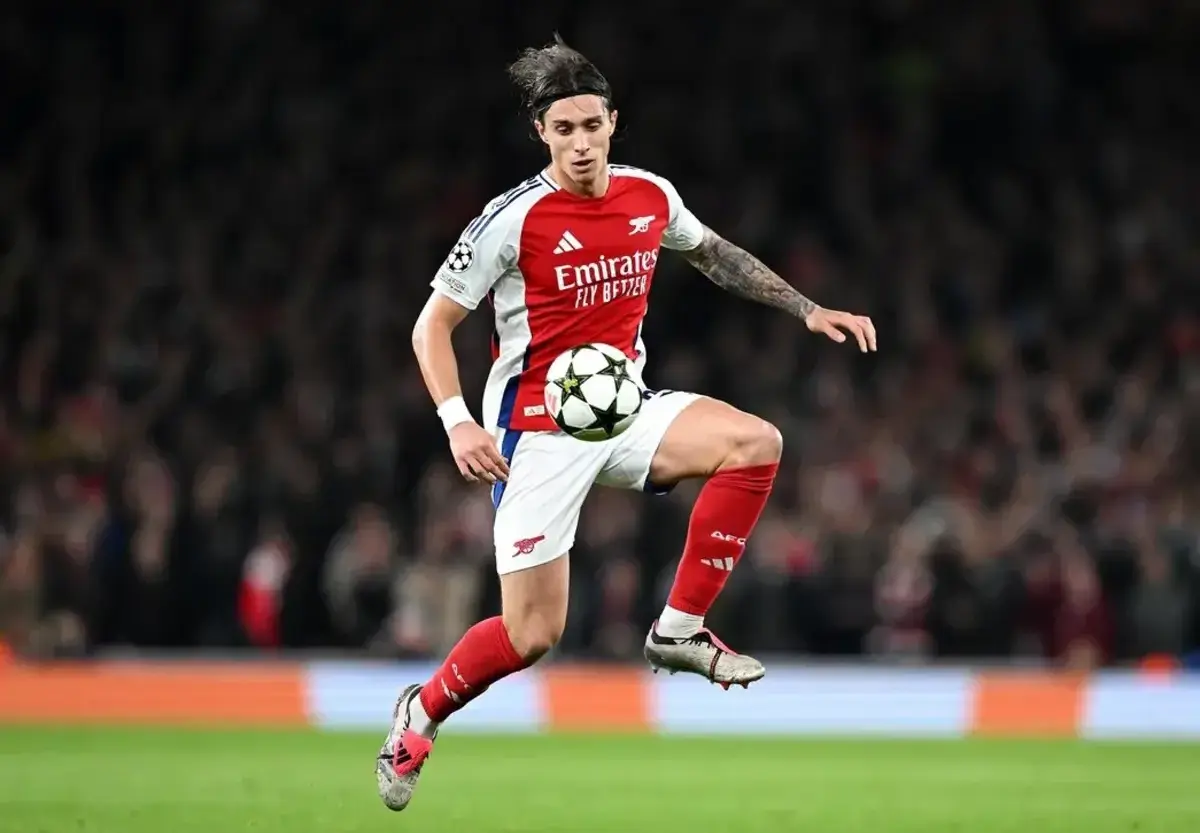
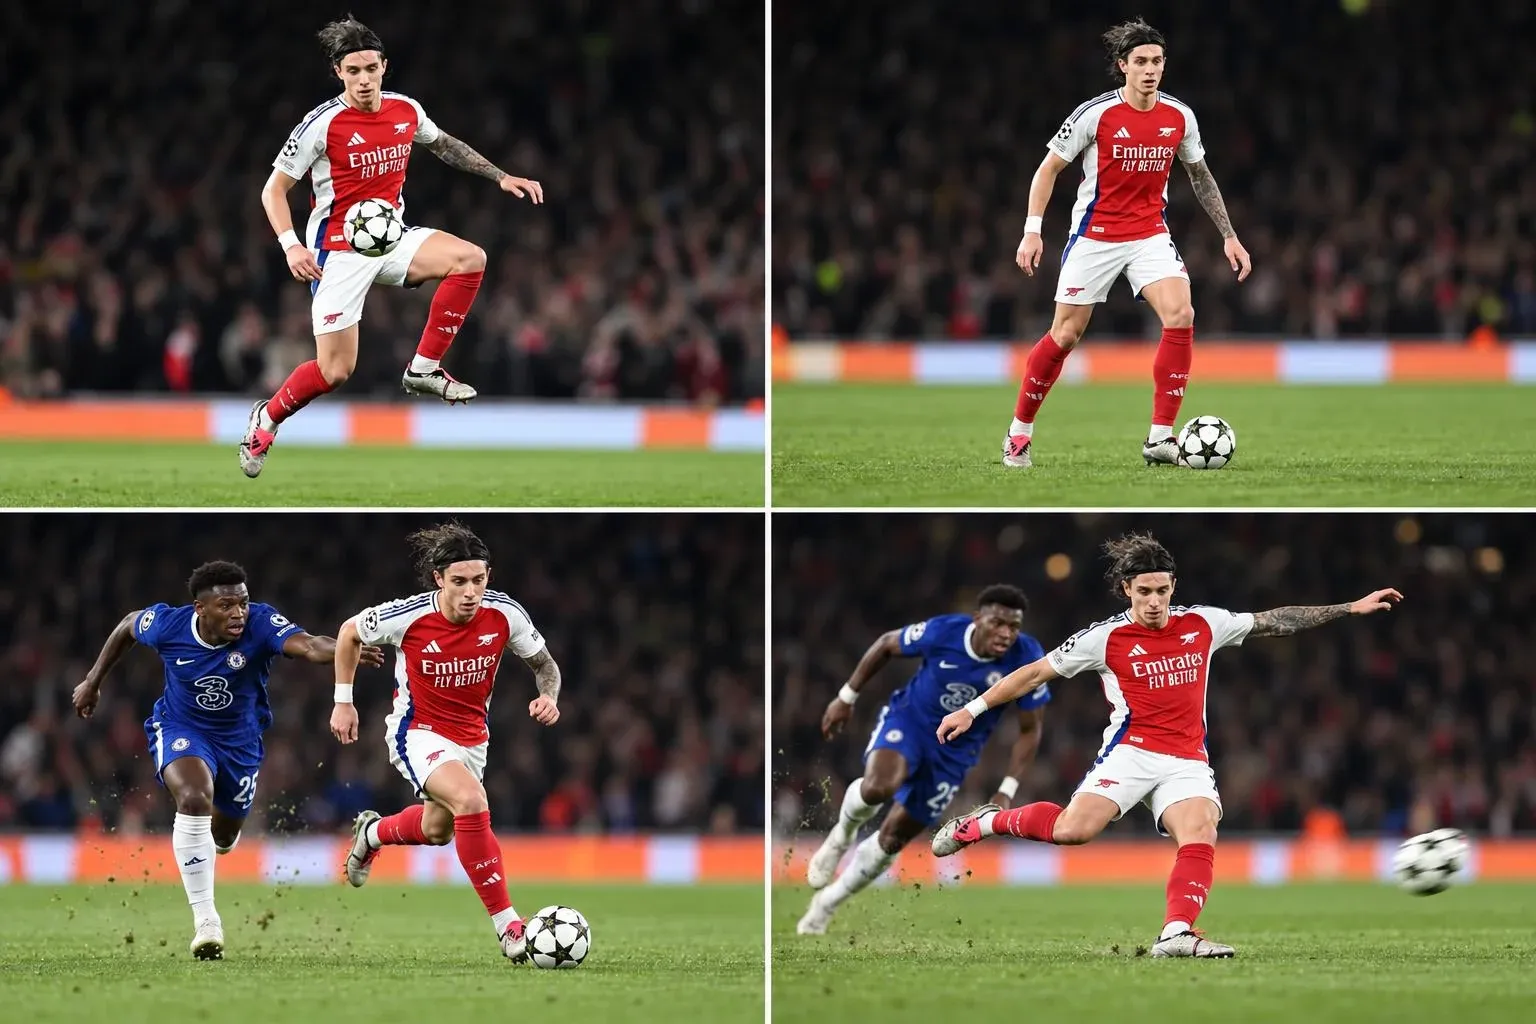
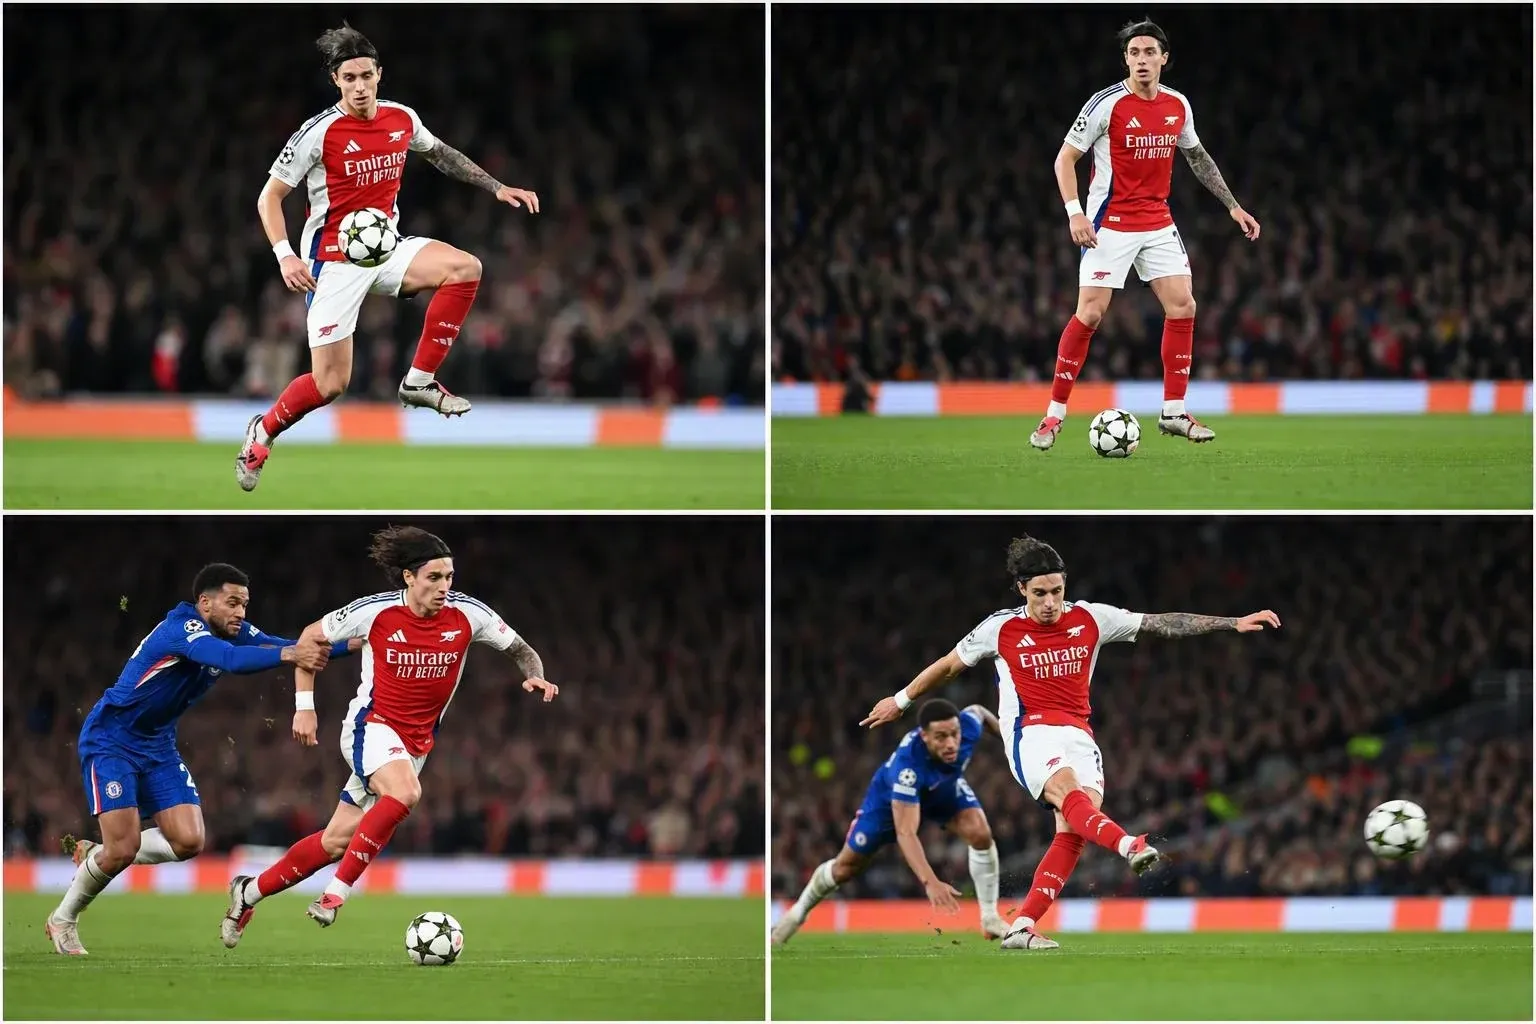
| 模型 | GPT-Image-2.5 Sunburst | GPT-Image-2 |
|---|---|---|
| 评分 | 4.5/5 | 4/5 |
简评:直接说两组的破绽。2.5 的问题出在下方两张图,都出现了明显的草皮飞起,但无论是带球突破还是射门,这都不合理(只有下铲才会铲起草皮);图 4 的射门动作也不合理,球员目光应直视传球/射门方向,而不是盯着脚下,足球还出现了不合理的残影。GPT-Image-2 的问题在右上图,球员双脚离地、悬浮在空中;图 4 同样有球员视线方向的问题。除此之外,两款模型在人物一致性和动作逻辑合理性上都堪称完美。
原图:
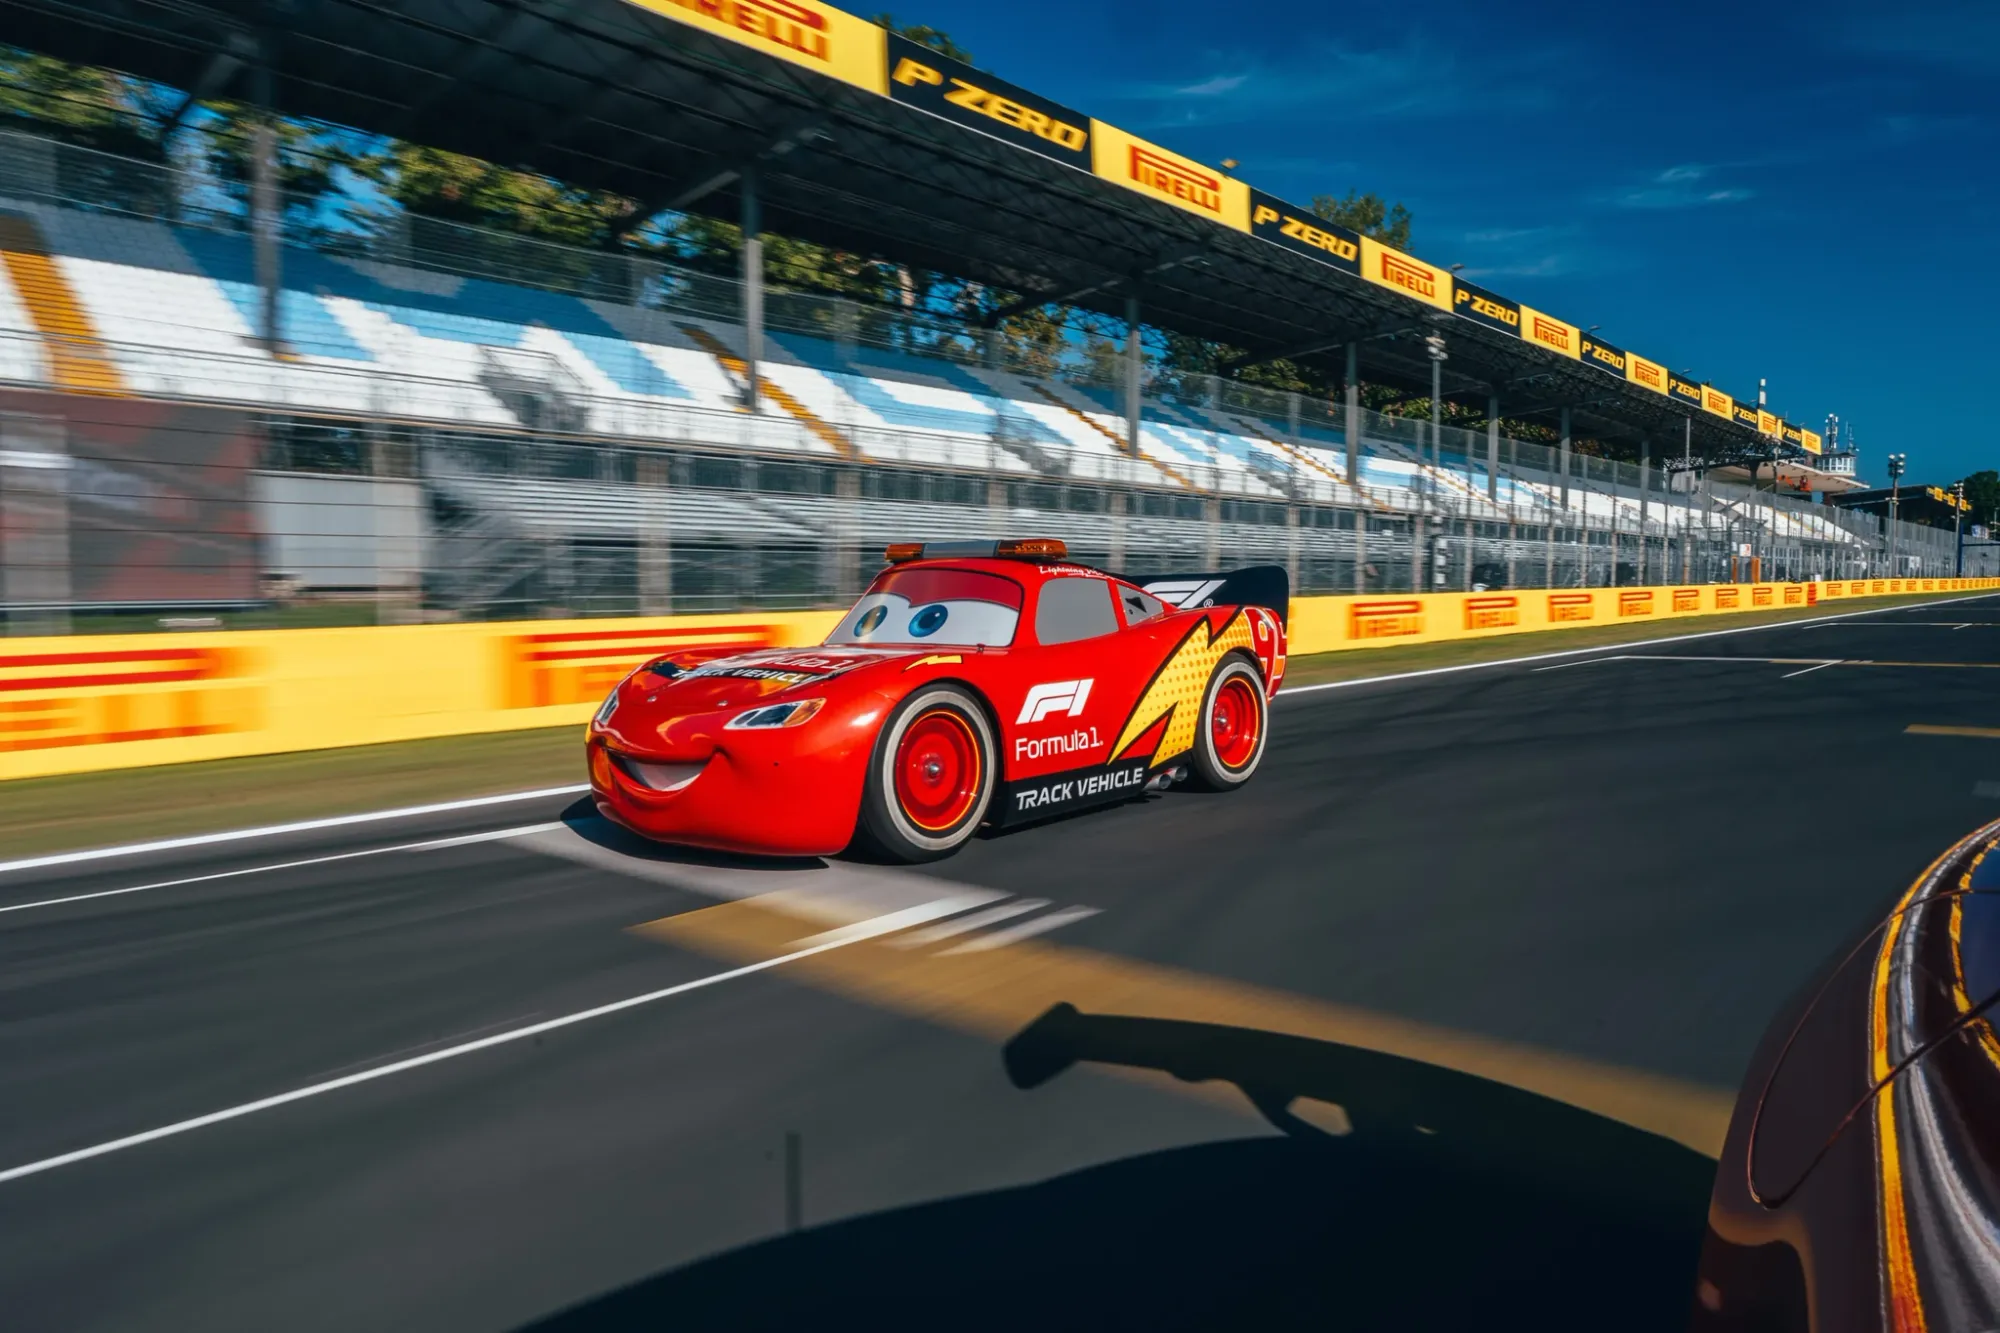
提示词:将闪电麦昆的红色车身改为baby blue浅蓝色,轮毂的红色改为和车身闪电一致的黄色;去除右下角的车身及对应的阴影。
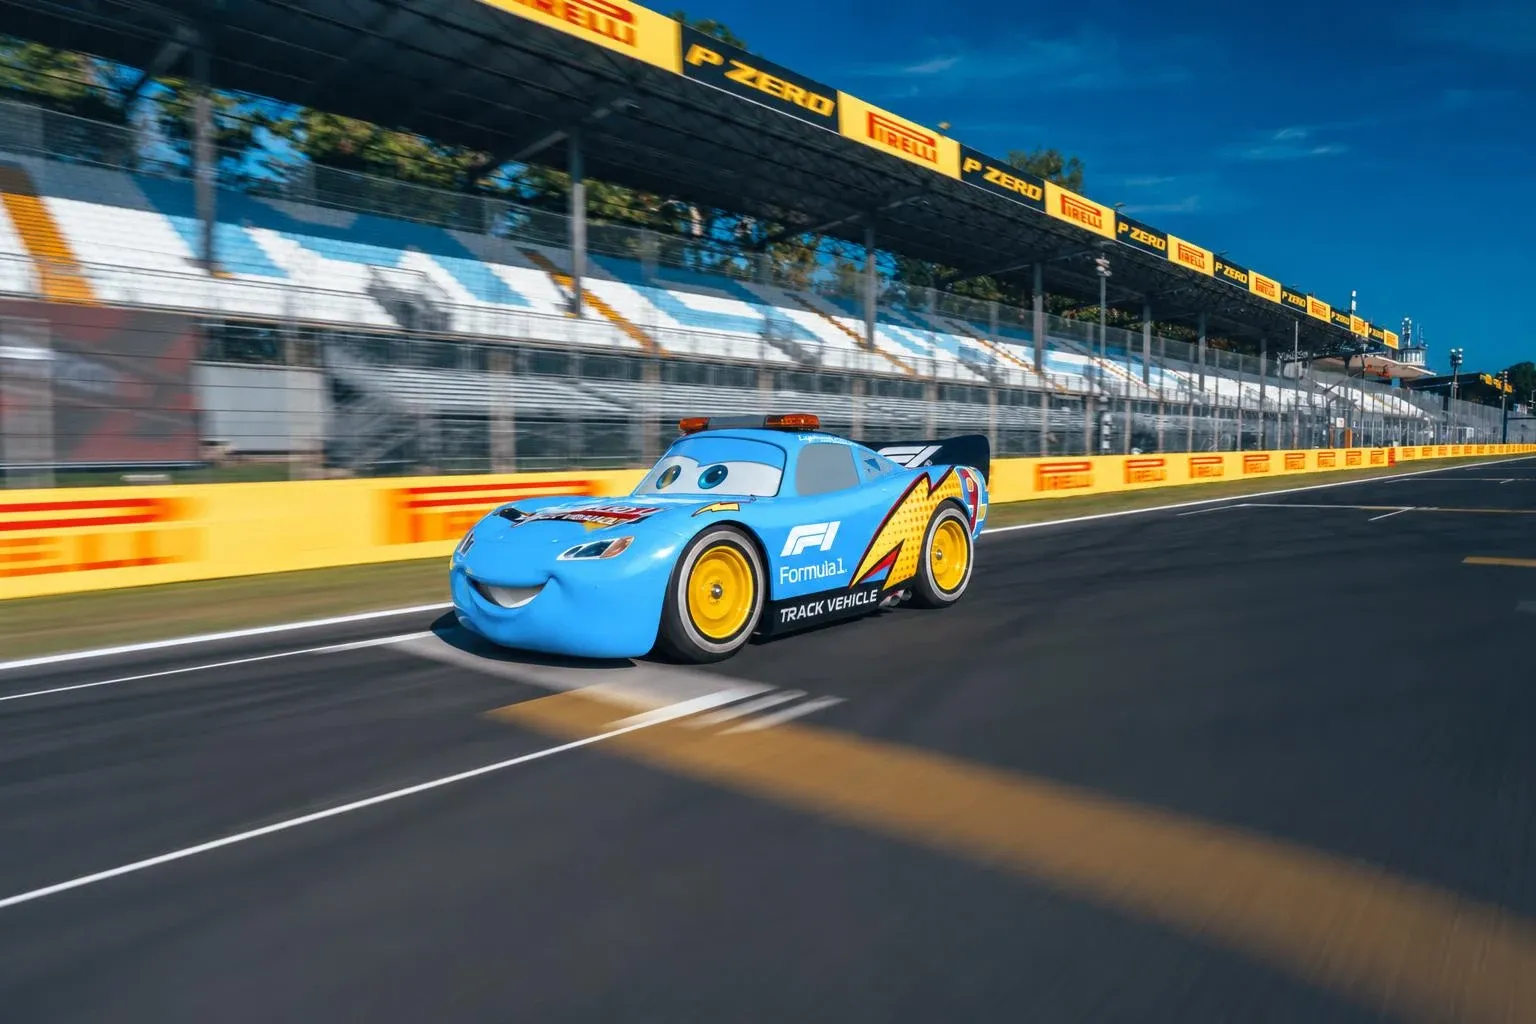
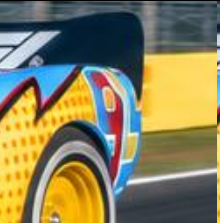
| 模型 | GPT-Image-2.5 Sunburst |
|---|---|
| 评分 | 4.5/5 |
简评:唯一的问题是车尾的 95 号号码没有处理干净,残留了部分原车的红色。
提示词:将黄色倍耐力的广告牌颜色反转(红色背景,黄色文字);黑色的P Zero广告牌改为绿色的Rolex广告牌;右上角的蓝色天空增加赛事转播的直升机。
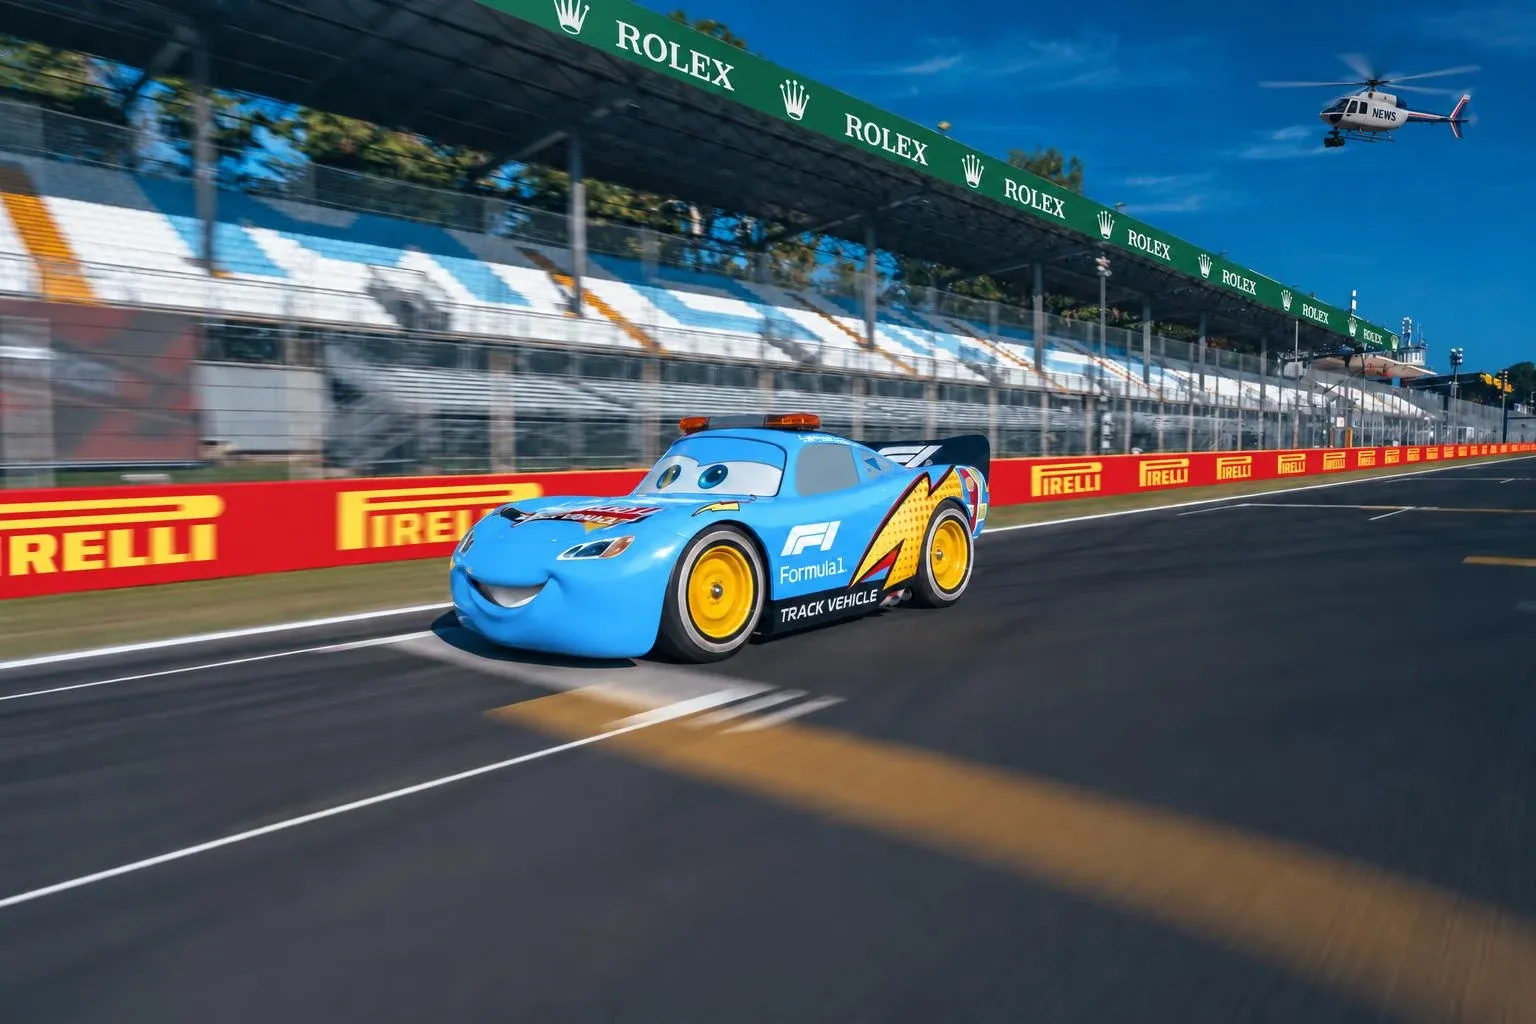
| 模型 | GPT-Image-2.5 Sunburst |
|---|---|
| 评分 | 3/5 |
简评:三处改动都有问题。一是看台顶部的倍耐力广告消失,全部变成了劳力士;二是底部倍耐力广告文字的清晰度发生了变化,从原图的模糊变为清晰;三是加入的直升机过于清晰,焦点不合理。
提示词:蓝色车身黑色侧裙上的文字“TRACK VEHICLE”改为中文“闪电麦昆”;在绿色框线位置加入维斯塔潘驾驶的红牛F1赛车。
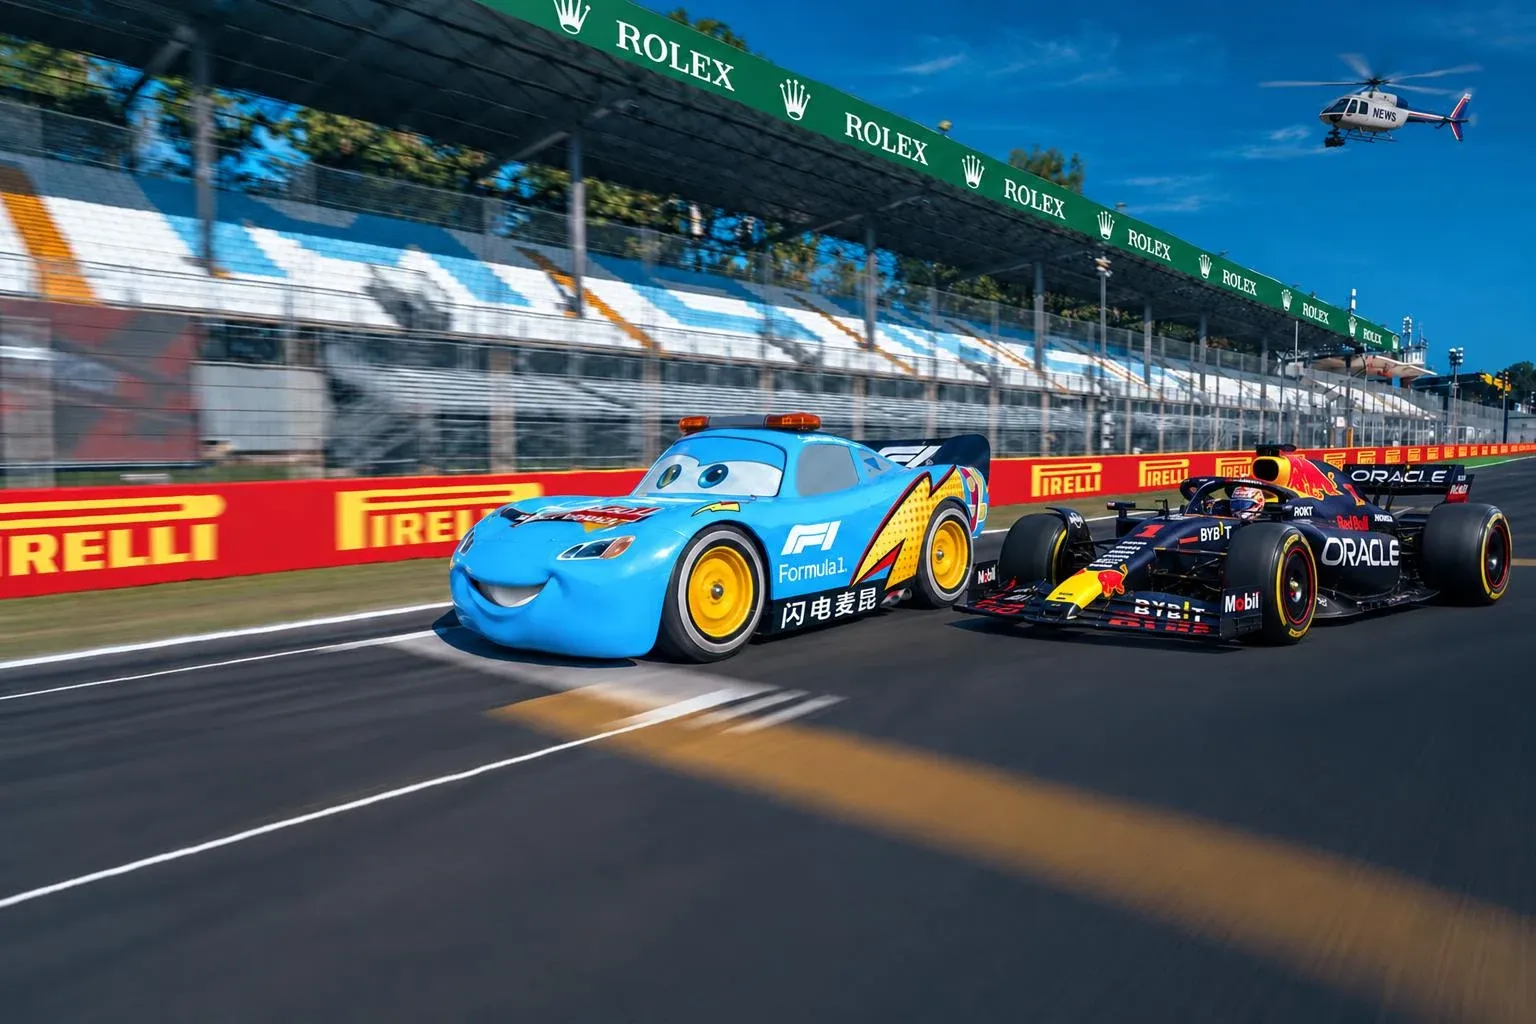
| 模型 | GPT-Image-2.5 Sunburst |
|---|---|
| 评分 | 2.5/5 |
简评:这张图很假。F1 赛车与麦昆距离过近,行进方向偏右,像是要撞上麦昆,不符合现实;F1 赛车的轮胎缺乏动态表现,显得静止;车身过于清晰,仍然是对焦问题。
8 组测试做完,最直接的感受是:有提升,但有限。毕竟 GPT-Image-2 本身已稳坐 SOTA 位置很久,各项能力都已是顶尖水平。
这次发布,OpenAI 自己也几乎没提画质。发布稿里与画质相关的只有一句“更自然的光影、更丰富的纹理”,没有亮眼的 benchmark,也没有创新突破的口号。
Artificial Analysis 图像竞技场的 Elo 分数如下:
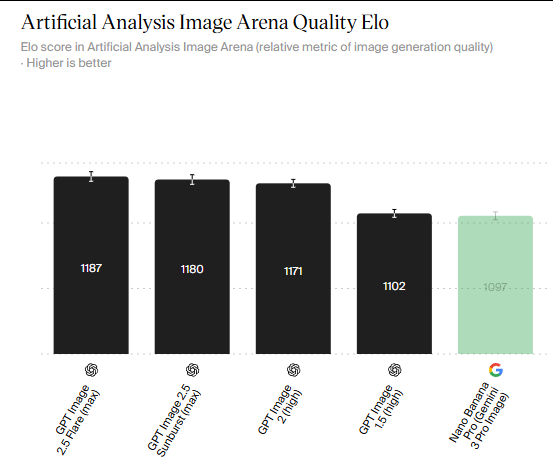
| 版本 | Elo 分数 | 涨幅 |
|---|---|---|
| GPT-Image-1.5 | 1102 | — |
| GPT-Image-2 | 1171 | +69 分(+6.3%) |
| GPT-Image-2.5 Flare | 1187 | +16 分(+1.4%) |
从 1.5 到 2.0,6.3% 的跃升足以让所有用户欢呼,因为画质和各项能力的提升实打实看得见;而这一次只有 1.4%——进步还在,但只剩零头。
这不是 OpenAI 不努力,而是画质与拟真这条赛道本身已经快跑到头了。看看如今的模型能做什么:输入几千字的提示词、准确清晰的文字渲染、指哪打哪的精准编辑、稳定的多轮一致性——这些一年前还不敢想的能力,现在已是各家头部模型的标配。
当模型要解决的已经是“字都对,但排版不够有杂志感”这一级别的问题,就意味着图像模型的下限已经确立,上限则在于更高维度的美学。在这个维度上,Midjourney 仍是绕不过去的名字。
这就是图像生成模型的边际效应时代:画质每进步 1%,用户感知到的惊喜越来越少;而榜单分数想再动 10 分,研发付出的成本可能是指数级的。Elo 曲线越来越平,不是厂商躺平,而是天花板就在头顶。
既然画质难再拉开差距,OpenAI 给出的答案是速度。
现实中,没有人需要模型画出一张震惊全网的神图,创作者需要的是“想法→出图→不满意→修改→再修改”的循环。在这个循环里,画质从 90 分到 95 分的变化感知并不明显,但等待时间从 100 秒压到 30 秒却是直观可感的。
因此,这一代中实用性最强的是主打速度的 GPT-Image-2.5 Flare:
出图快带来的不只是体验优化,而是工作流的质变:时间成本骤降,单位时间内可以做更多尝试,创意密度直接翻倍。
转自 302.AI
9 月 22 日,Anthropic 发布 Claude Opus 5.5,主打智能追平自家旗舰 Fable 5.1、成本比 Opus 5 低 40%,$4/$20 的定价在当下的旗舰模型里颇具吸引力。
OpenAI 没打算让对手独占头条,同一天上线了 GPT-6 Sol 与 GPT-6 Luna,并直接在价格上出手:
Anthropic 刚强调“比之前便宜 40%”,OpenAI 当天就用更低的价签回应,两家同日发布,针锋相对。
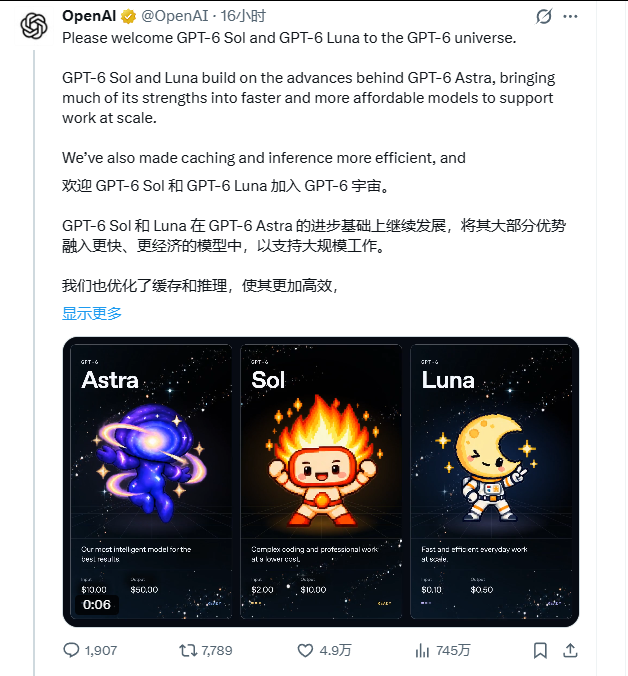
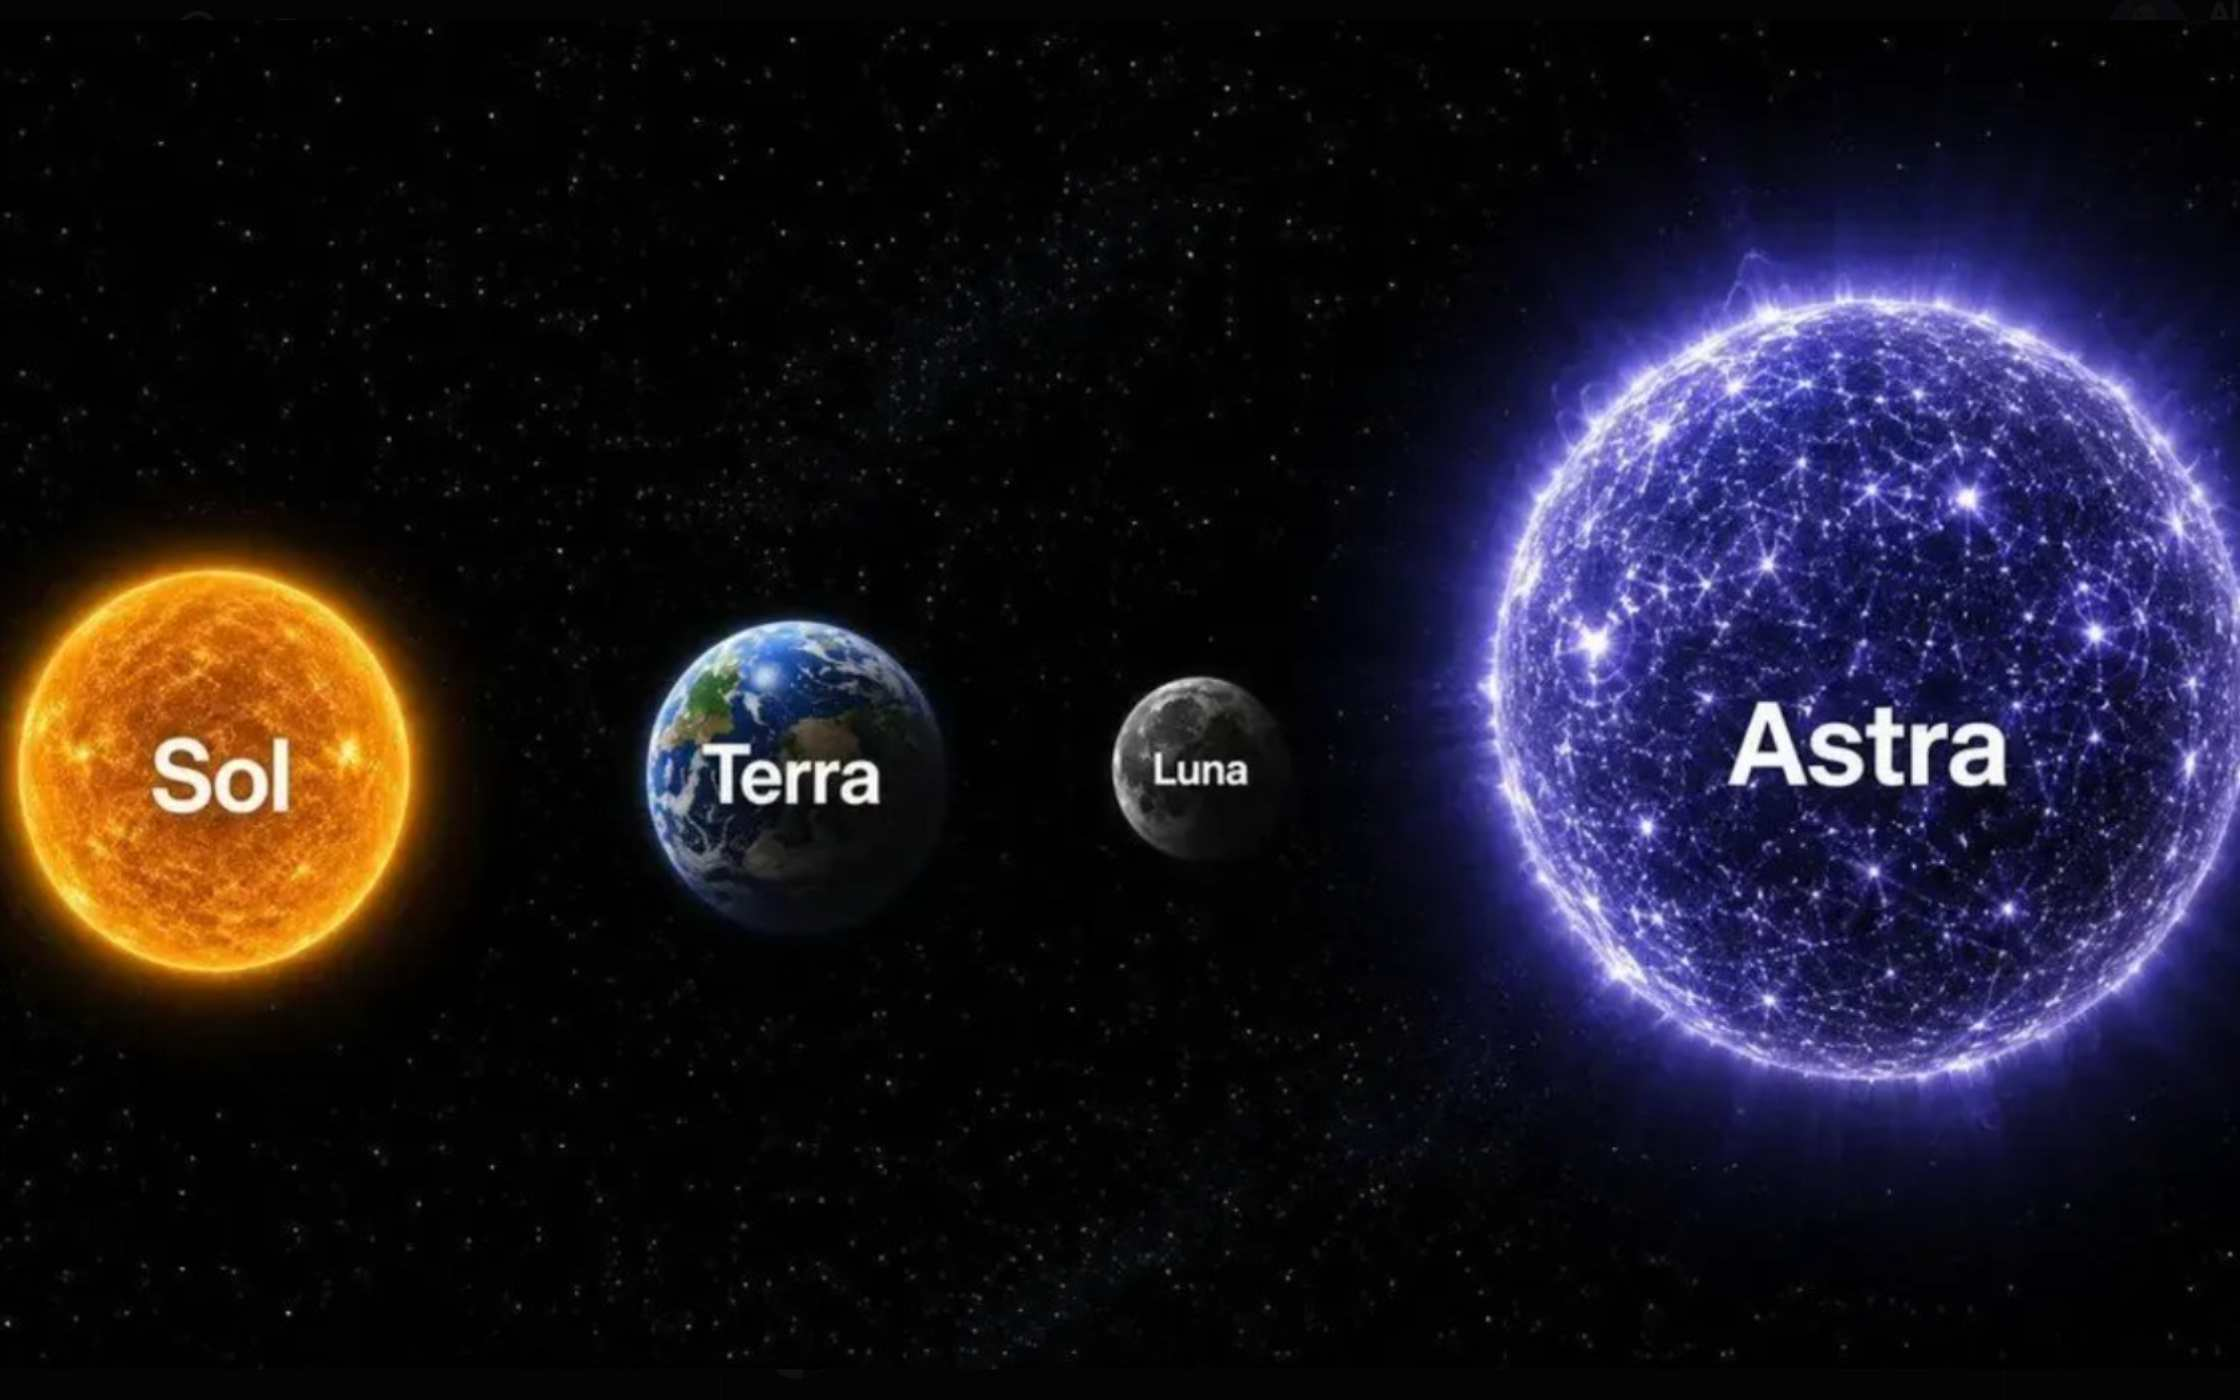
到了 GPT-6 这一代,OpenAI 不再在数字后面层层加后缀,而是改用一套天文命名:
| 型号 | 定位 | API 价格(每百万 token,输入/输出) |
|---|---|---|
| GPT-6 Astra | 旗舰,9 月 3 日发布 | $10 / $50 |
| GPT-6 Sol | 主力模型,本次发布 | $2 / $10(上代 $4/$20,降 50%) |
| GPT-5.6 Terra | 中档(GPT-6 版暂未发布) | $2 / $12 |
| GPT-6 Luna | 轻量走量,本次发布 | $0.10 / $0.50(上代 $0.20/$1.20,降 50%) |
有两个细节值得注意:
OpenAI 这次的发布口径相当克制:不谈 AGI,也不谈革命。第三方评测机构 Artificial Analysis 的标题更是直言“价格砍半,性能几乎没动”(barely move the needle)。
只看智力分数,Sol 和 Luna 确实没有刷新纪录;但如果把“每美元能买到多少智能”当作指标,它们的表现相当亮眼。
官方的说法是:GPT-6 Luna 在高强度设置下,性能追平 GPT-5.6 Sol,成本却只有后者的百分之一。
在 Zapier 的 AutomationBench(覆盖销售、营销、财务、HR 等真实业务流程)上:
注:百分比为端到端任务完成率,33.2% 约等于 100 个任务中有 33 个从头到尾全部做对。
在基于真实用户纠错数据的内部评测中,Sol 的错误率减半,可靠性接近 Astra。一个主力模型在幻觉率上追上旗舰,对日常应用而言,这比任何编码基准都更重要。
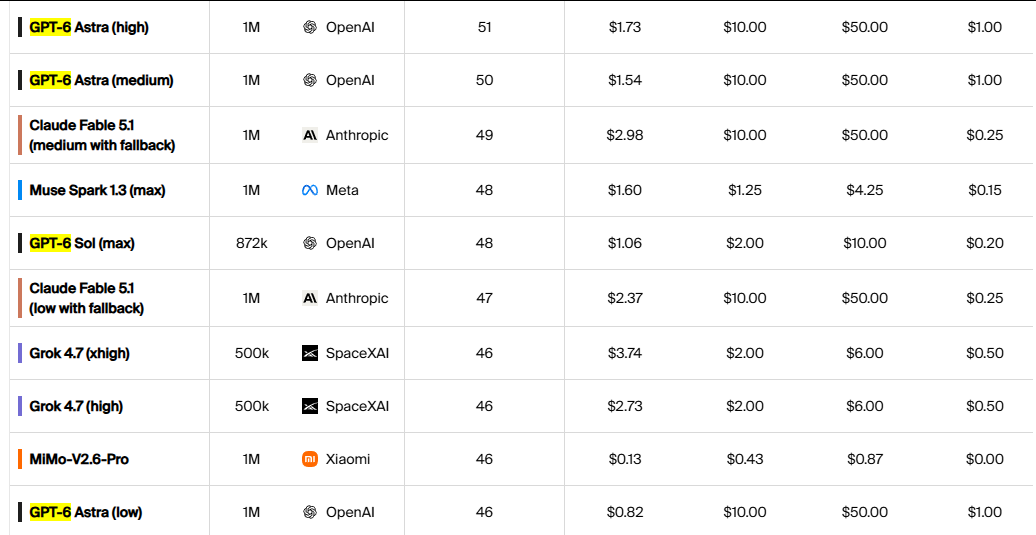
在 Artificial Analysis 榜单中,GPT-6 Sol 与 GPT-6 Luna 分别排在第 14 位和第 41 位。
以下同题实测把 GPT-6 Sol 与 5.6 时代的中端主力 GPT-5.6 Terra 放在一起,看看这一代的提升是否显著。
| 模型 | 上下文窗口 | 官方价格(每百万 token,输入/输出) |
|---|---|---|
| gpt-6-sol | 1M | $2 / $10 |
| gpt-5.6-terra | 1M | $2 / $12 |
本次评测侧重逻辑、数学、编程、多模态和人类直觉类问题,并非专业前沿领域的权威测试,目的是观察模型的进化趋势,为选型提供参考。
编程案例按以下等级评定:
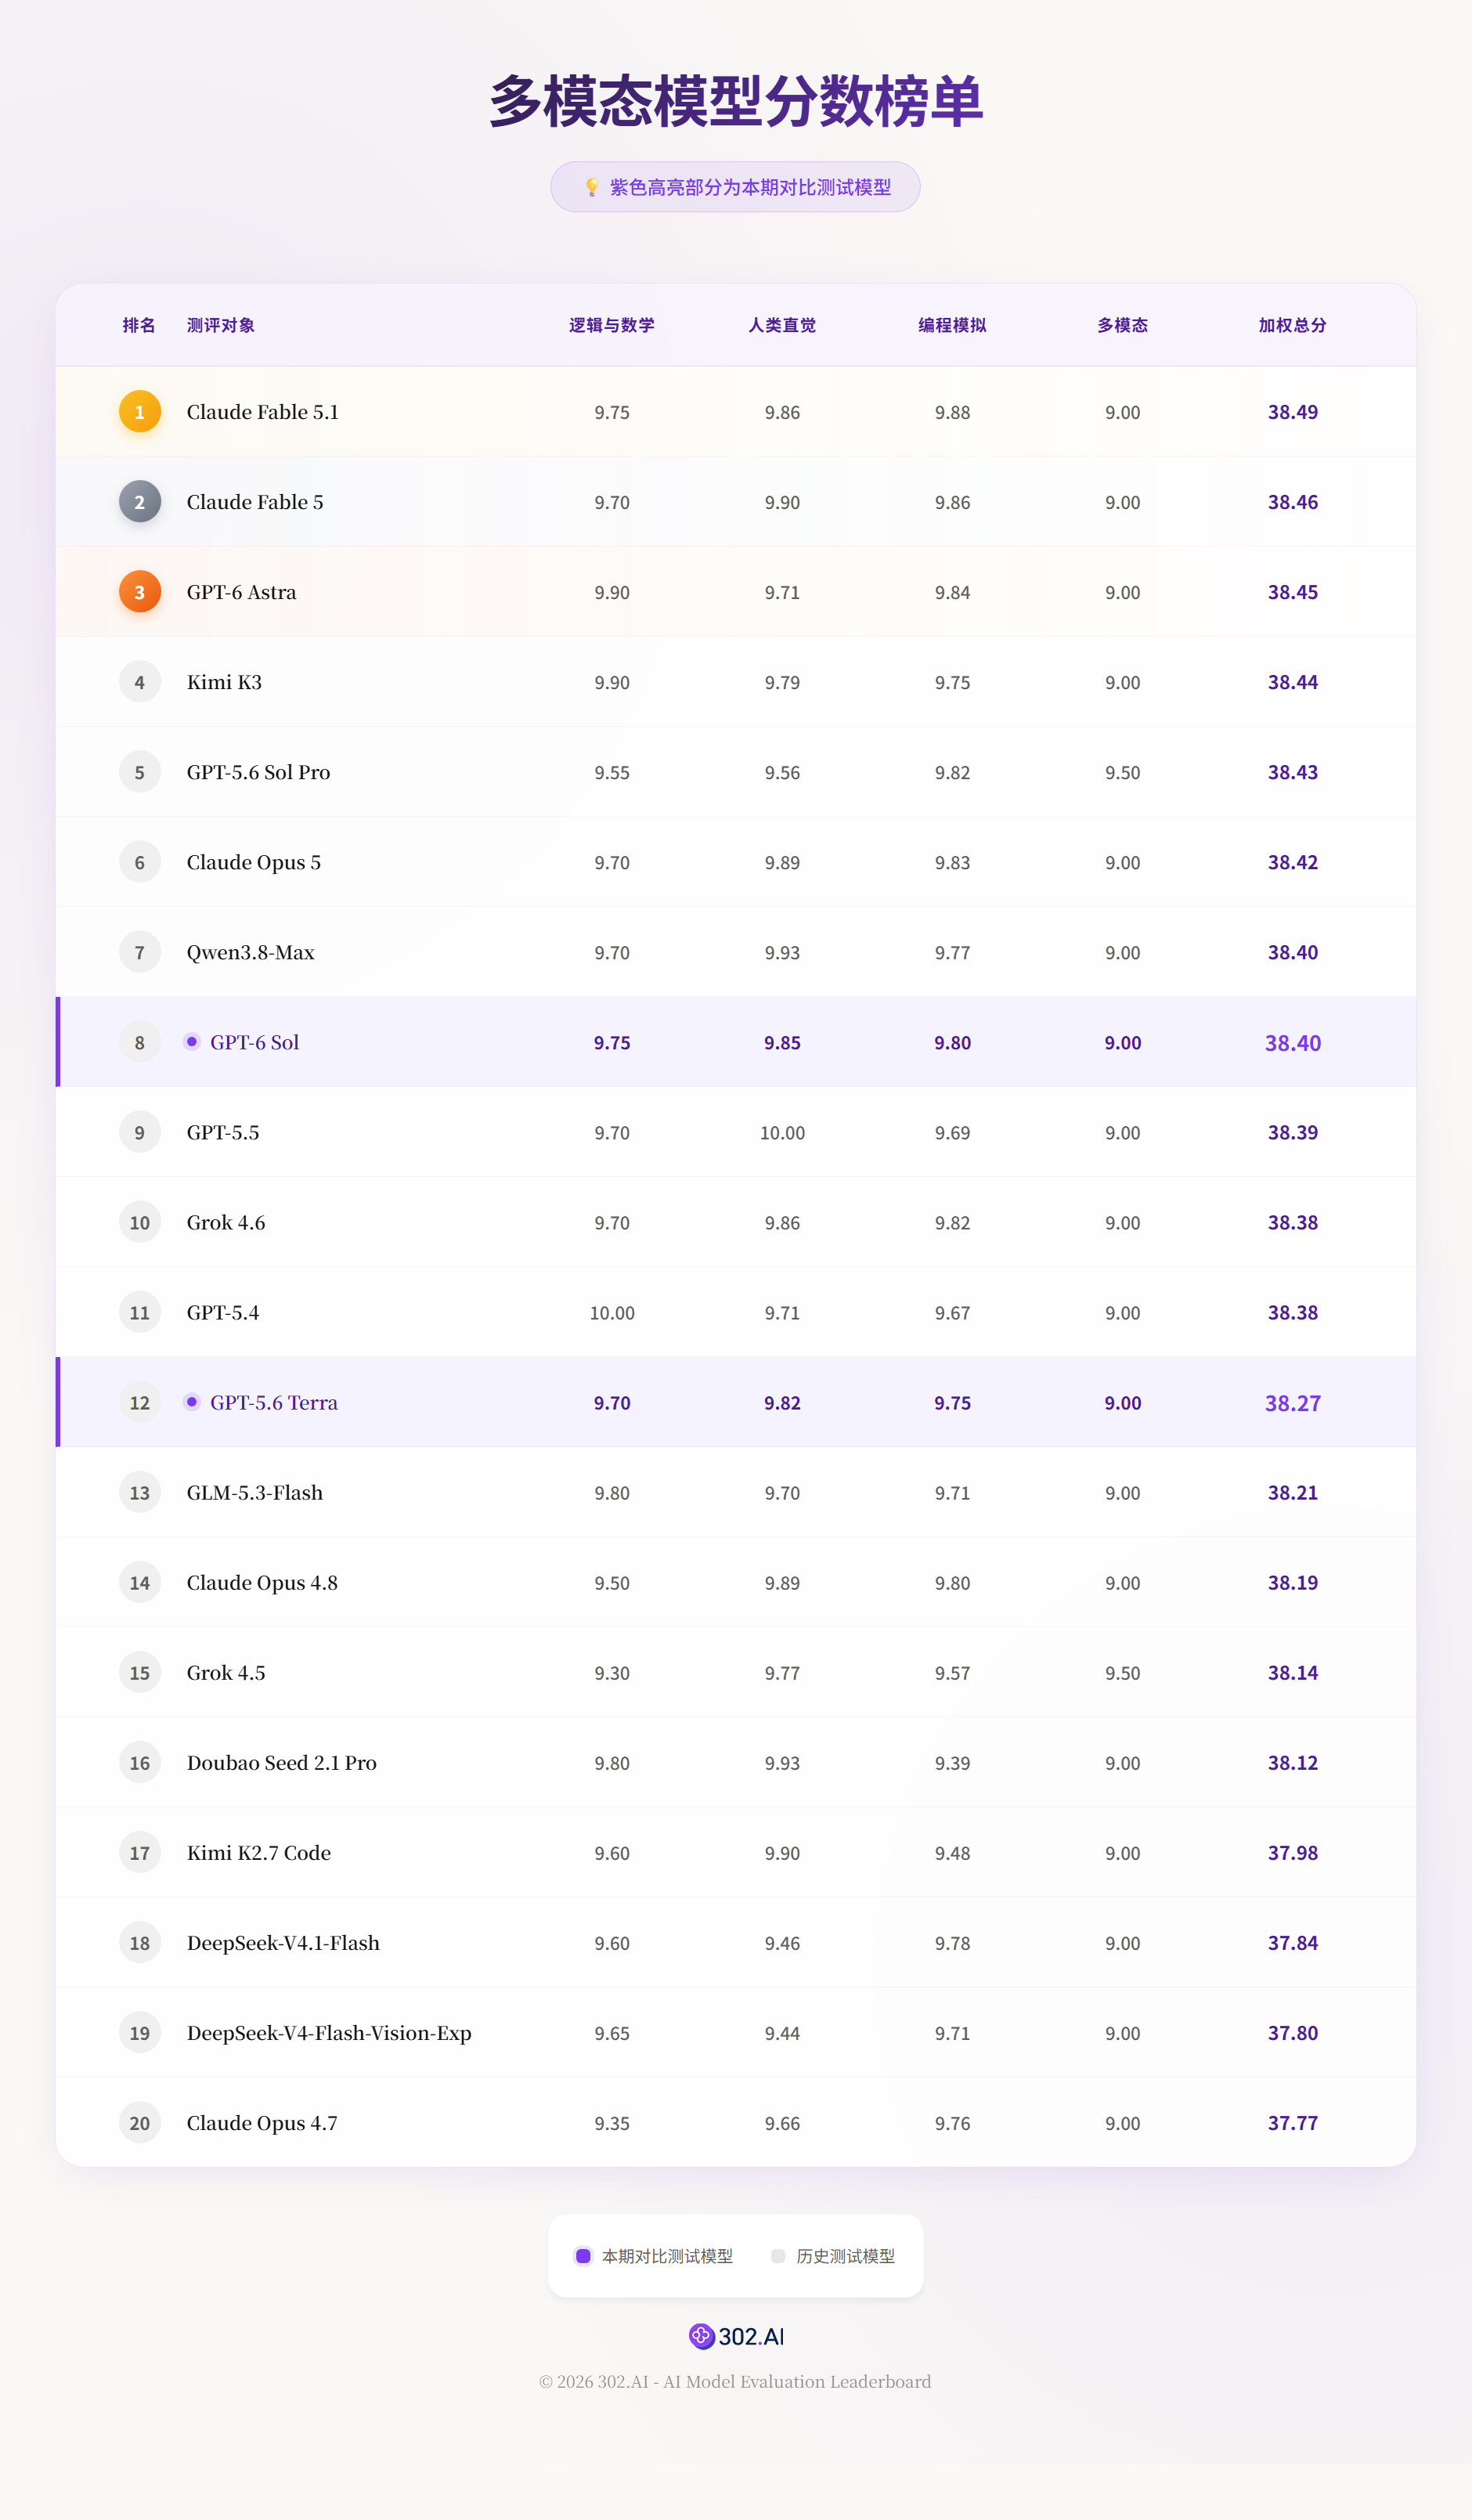
GPT-6 Sol 加权总分 38.40,在榜单中排第 8;GPT-5.6 Terra 38.27,排第 12。Sol 在逻辑与数学(9.75 对 9.70)、人类直觉(9.85 对 9.82)和编程模拟(9.80 对 9.75)上小幅领先,多模态两者同为 9.00。
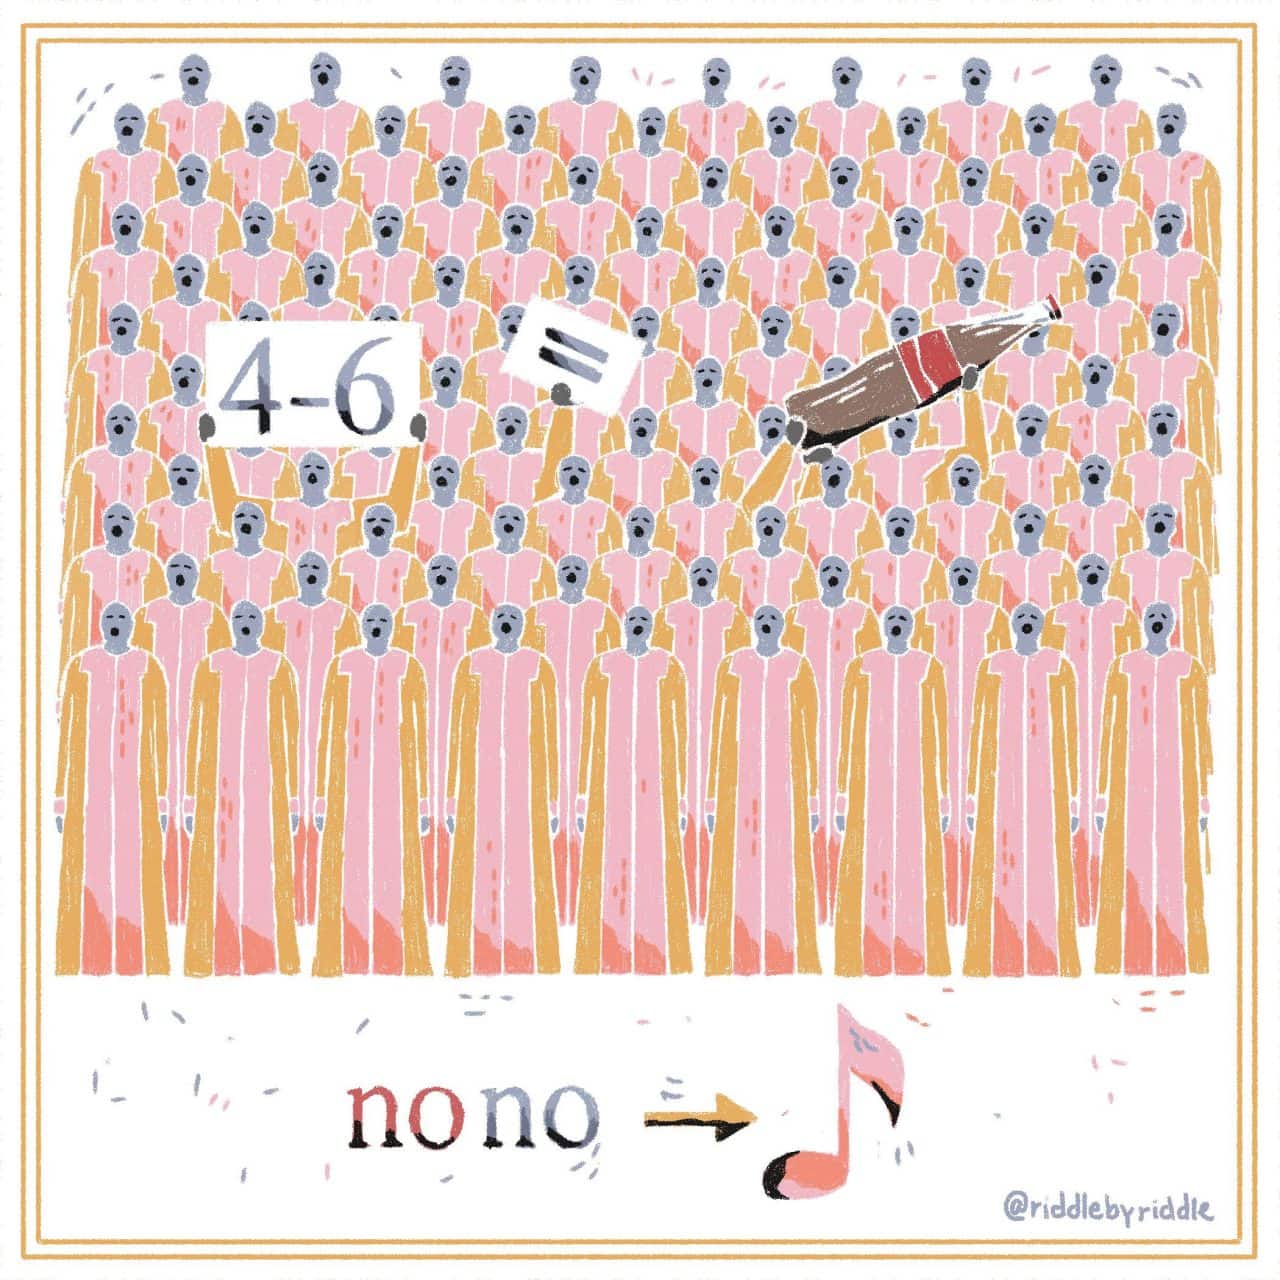
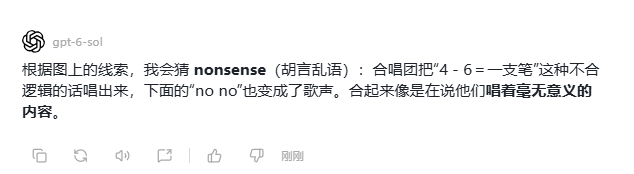
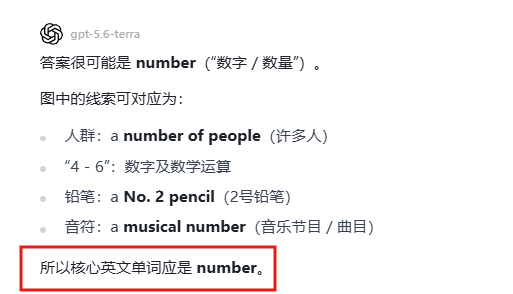
提示词:推测图中描述的是哪个英文单词。
答案:CHOCOLATE。图中的歌手代表合唱团(CHORUS),把第 4–6 个字母替换成 COLA,得到 CHOCOLA;再加上 NOTE(音符)去掉 NO 后的部分,就得到 CHOCOLATE。
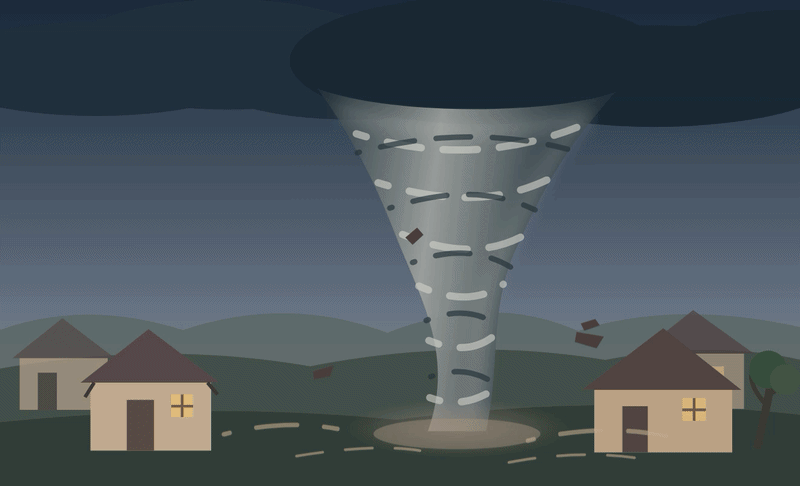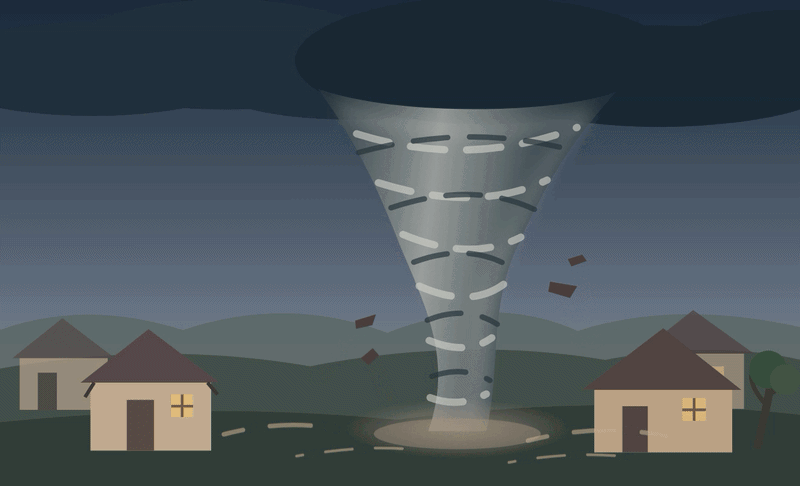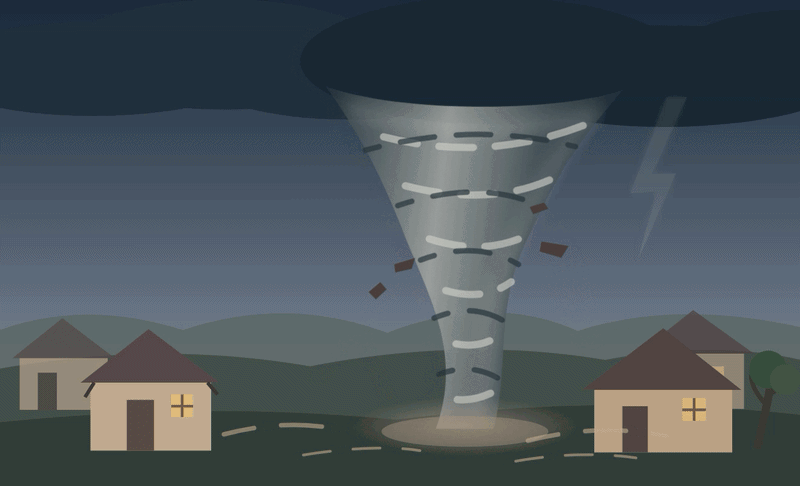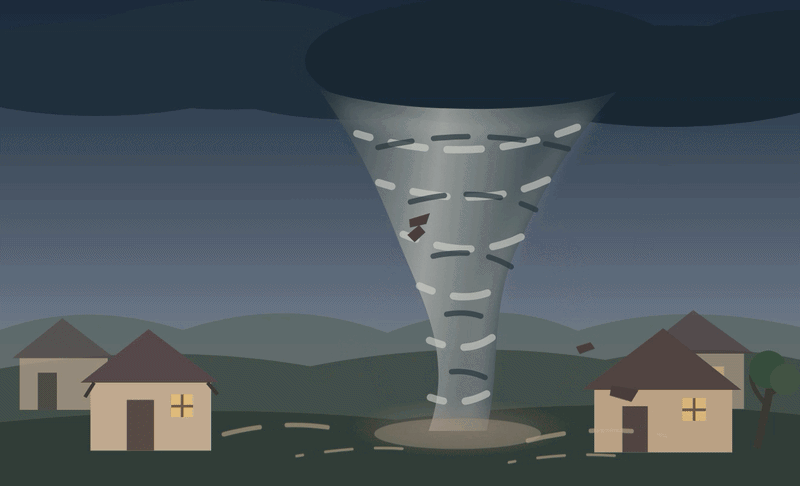
提示词一:绘制一幅龙卷风席卷村庄的动态 SVG 图。
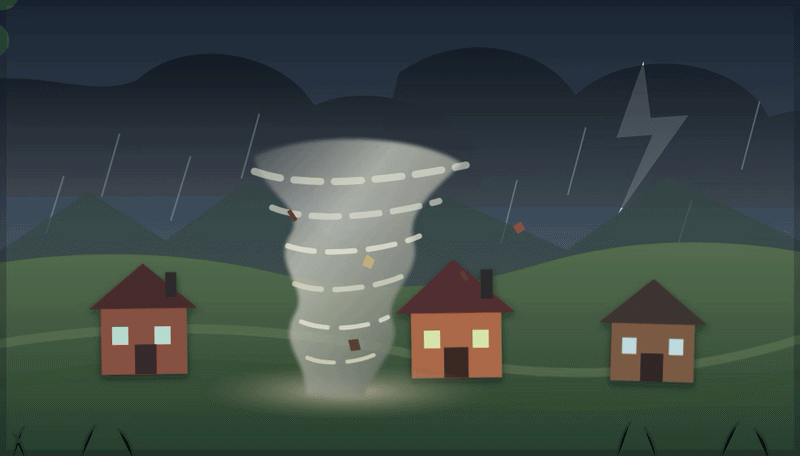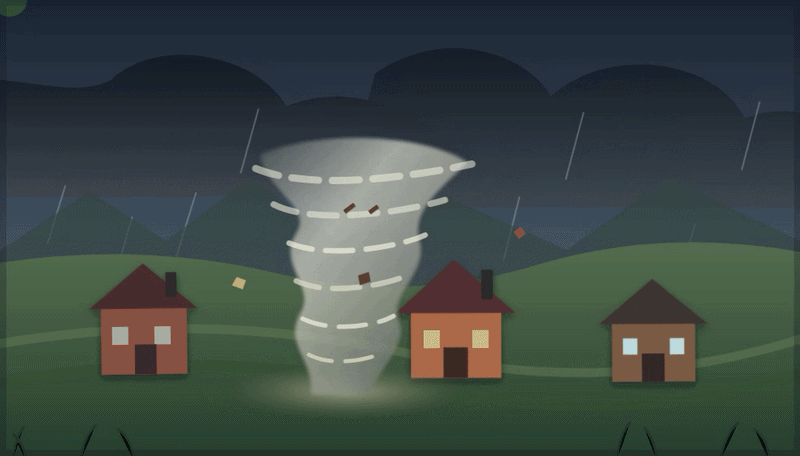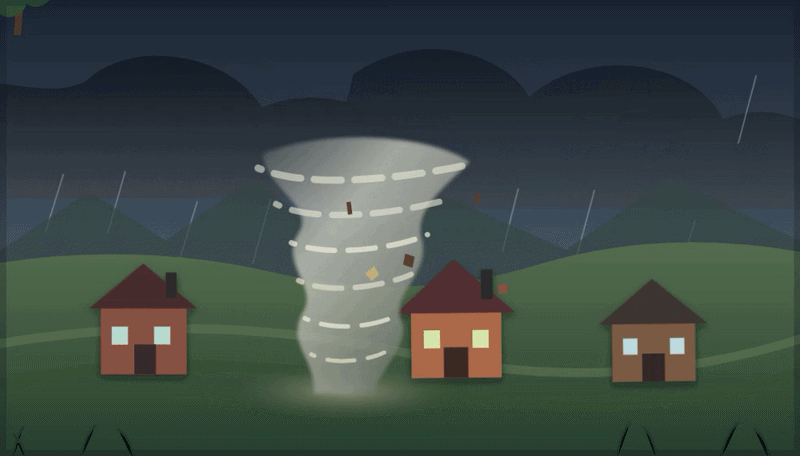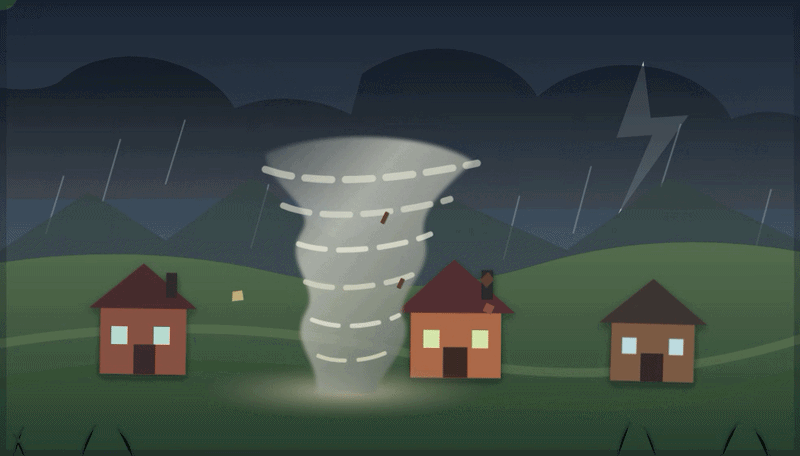
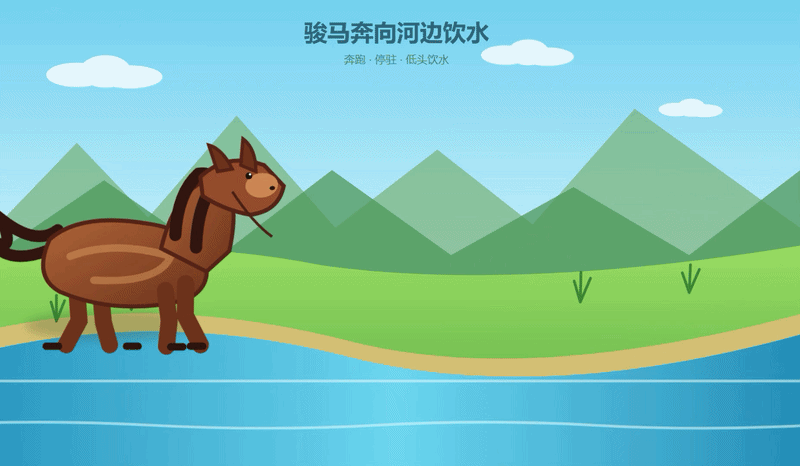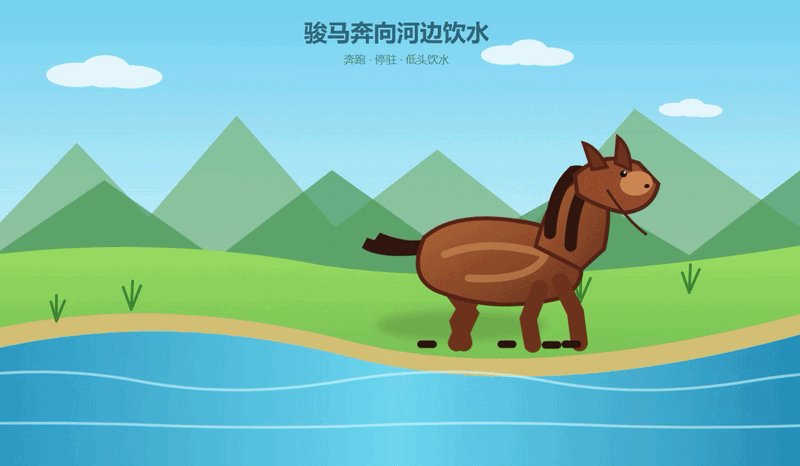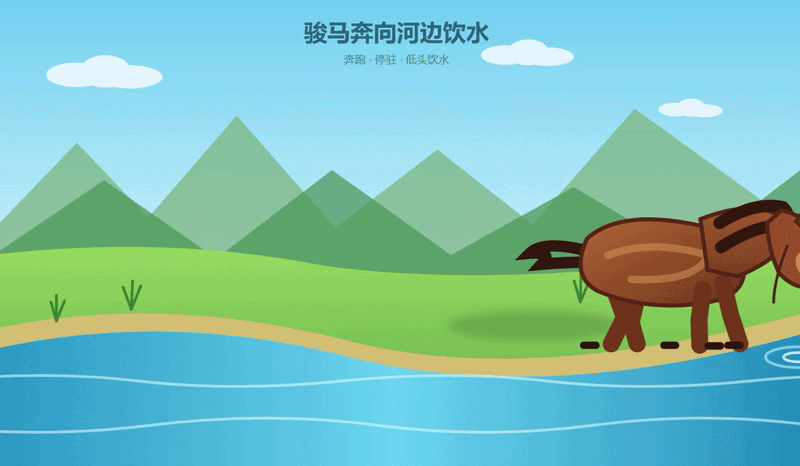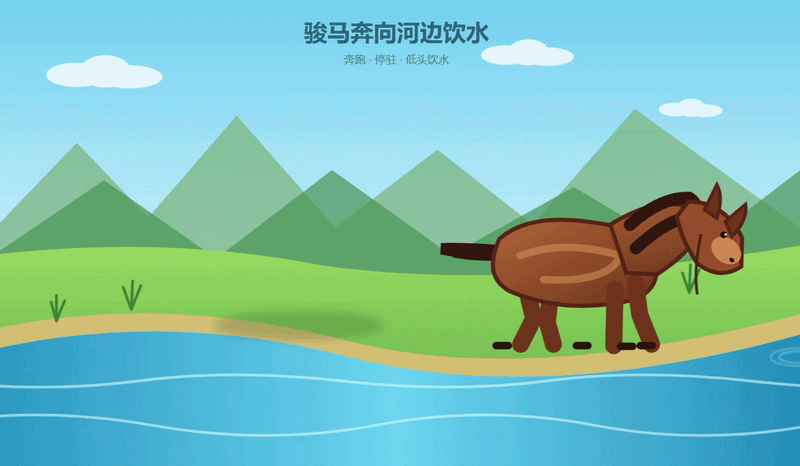
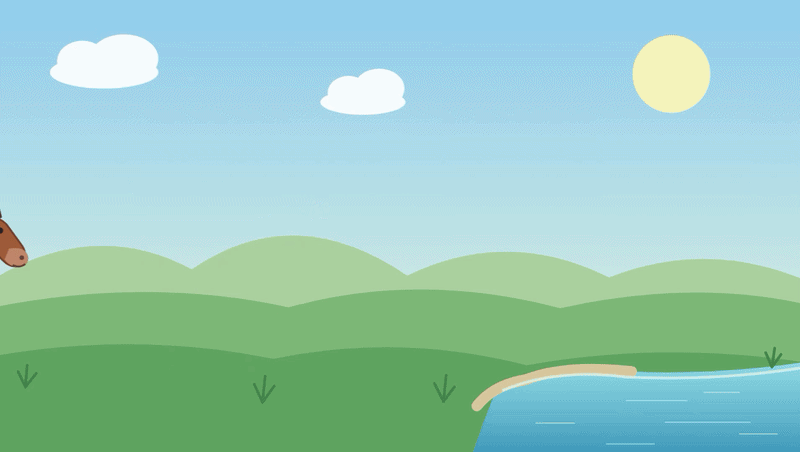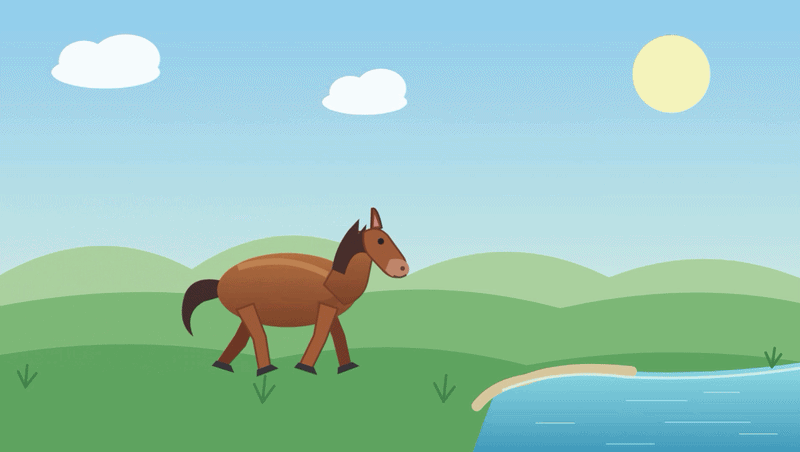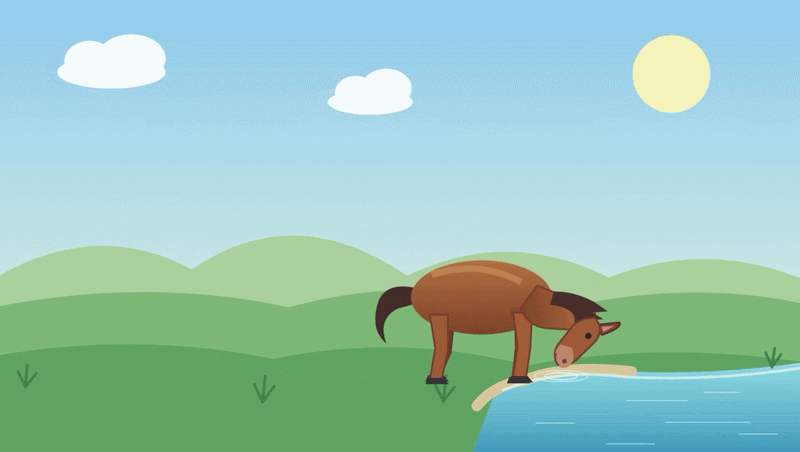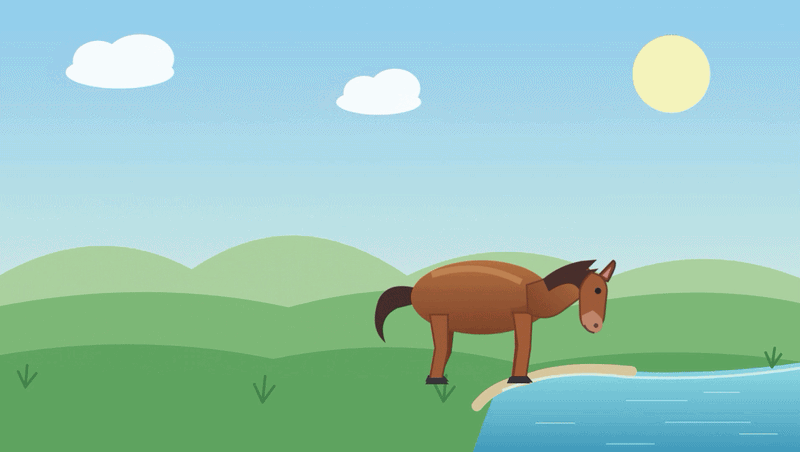
提示词二:绘制一幅马快跑到河边饮水的动态 SVG 图。
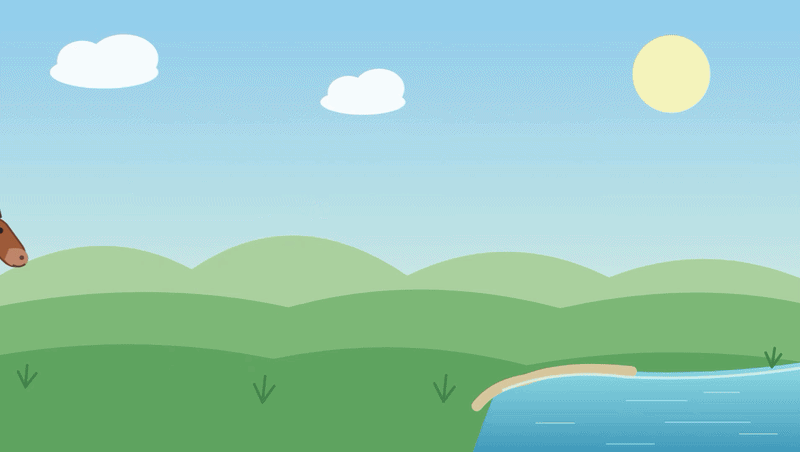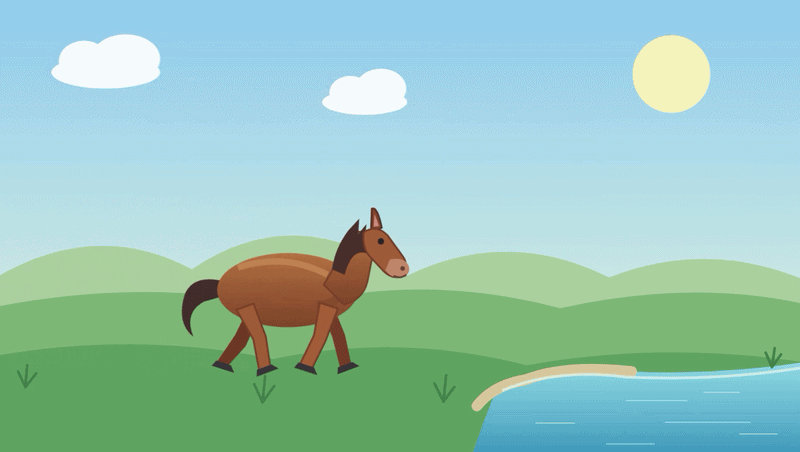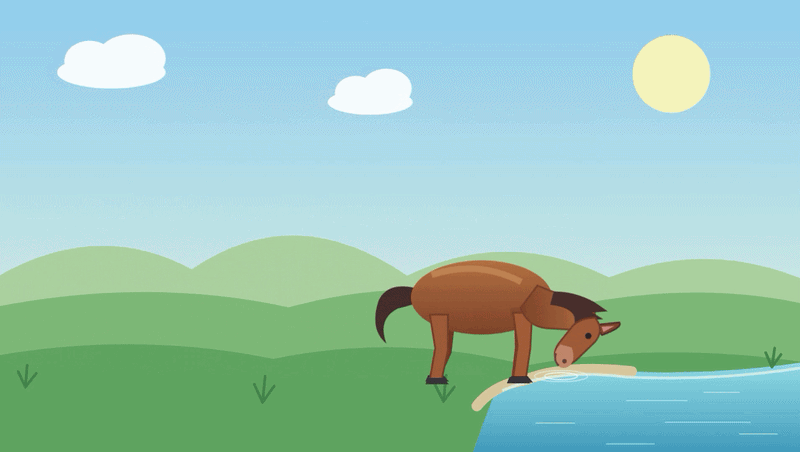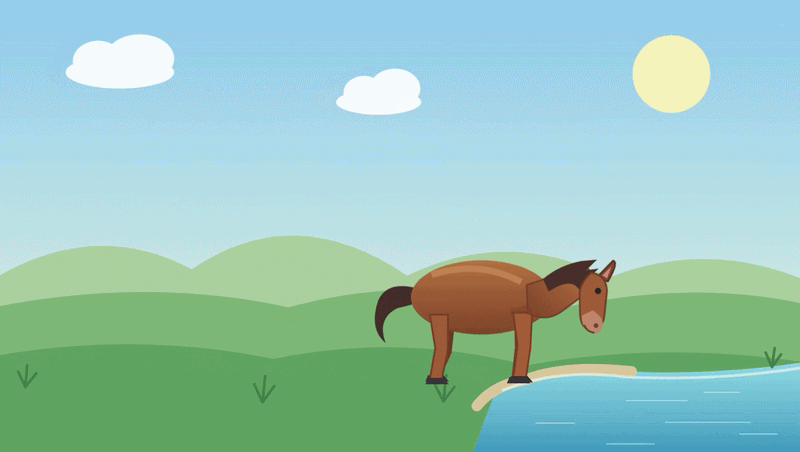
| 测评点 | GPT-6 Sol | GPT-5.6 Terra |
|---|---|---|
| 语义表达准确度 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ |
| 图形构造复杂度 | ⭐⭐⭐ | ⭐⭐ |
| 动态实现质量 | ⭐⭐⭐ | ⭐⭐ |
提示词(英文原文):
Create a polished 3D endless runner game as a single self-contained HTML file.
The gameplay should be inspired by the familiar mechanics of mobile endless runners: the character automatically runs forward along a multi-lane path, while the player can switch lanes, jump, slide, and dodge obstacles. Add collectible items, increasing speed, score tracking, and game-over/restart states.
Create a completely original setting, characters, environment, and visual identity. Do not copy the visual style, characters, locations, props, UI, or assets of any existing game. Use a stylized 3D aesthetic with a strong sense of depth and motion.
Include:
Smooth third-person camera following the character
Three-lane movement with responsive controls
Jumping, sliding, and obstacle avoidance
Procedurally generated sections so the run can continue
Moving obstacles and varied environmental hazards
Collectibles and score progression
Increasing difficulty and speed
Polished animations, lighting, particles, and camera effects
Keyboard and mouse controls
A clear start screen, HUD, game-over screen, and restart button
The final result should feel like a complete, polished 3D mini-game rather than a technical demo.优势:
不足:
优势:
不足:
| 测评点 | GPT-6 Sol | GPT-5.6 Terra |
|---|---|---|
| 玩法创意性 | ⭐⭐⭐⭐ | ⭐⭐⭐⭐ |
| 视觉执行力 | ⭐⭐⭐ | ⭐⭐ |
| 技术实现 | ⭐⭐⭐⭐ | ⭐ |
提示词(英文原文):
Create a premium immersive 3D web experience about the history and making of traditional Chinese mooncakes, delivered as a single self-contained HTML file.
Design it as a cinematic digital museum rather than a conventional webpage. The visitor should move through a virtual exhibition space and experience the story through carefully choreographed camera movements, lighting, animations, spatial transitions, and interactive 3D objects.
The experience should include:
Origin & History — a cinematic introduction explaining the origins and cultural evolution of mooncakes through an immersive historical gallery.
Ingredients — interactively explore flour, lotus seeds, egg yolks, nuts, and other ingredients as detailed 3D objects.
Making Process — show the complete process: preparing the filling, making the dough, wrapping, shaping with a wooden mold, baking, and the final mooncake emerging from the oven.
Mooncake Showcase — create several original regional and traditional mooncake variations with different shapes, patterns, fillings, and textures.
Cultural Story — connect mooncakes with the Mid-Autumn Festival, family reunion, the full moon, lanterns, and traditional Chinese symbolism.
Build all visual elements yourself with Three.js and procedural geometry/materials. Do not rely on external images, downloaded 3D models, stock assets, or image textures. Model the mooncakes, ingredients, utensils, exhibition architecture, lanterns, moon, clouds, tables, shelves, and other major visual elements from scratch.
Use a sophisticated visual language: dark museum architecture, warm golden illumination, subtle volumetric atmosphere, realistic materials, soft shadows, reflections, floating particles, and restrained Chinese-inspired visual details.
The transitions should feel like a digital film or high-end interactive museum installation rather than a website slideshow. Use cinematic camera choreography, depth of field, slow reveals, object close-ups, environmental animation, and smooth transitions between exhibition spaces.
Make the experience highly polished and interactive. Users should be able to explore objects, trigger animations, zoom into the mooncake-making process, and move naturally between different exhibition areas.
The final result should feel like an award-winning interactive digital exhibition, with strong storytelling, atmosphere, spatial depth, and visual craftsmanship — not a collection of simple 3D objects placed on a webpage.优势:
不足:
采用需要拖动浏览的走廊式空间叙事,创意不错;但明暗关系把握不足,动画和建模较为粗糙,视觉观感不佳,整体显得单调乏味。
| 测评点 | GPT-6 Sol | GPT-5.6 Terra |
|---|---|---|
| 视觉执行力 | ⭐⭐⭐⭐ | ⭐⭐ |
| 叙事与信息完整度 | ⭐⭐⭐⭐ | ⭐⭐⭐ |
| 交互与用户体验 | ⭐⭐⭐⭐ | ⭐⭐ |
先说结论:放在旗舰级模型的队列里,GPT-6 Sol 的整体表现中规中矩。
和上一代中端主力 GPT-5.6 Terra 相比,它在各方面的综合水平确实有进步;但放回 GPT-6 整个产品梯队里看,Sol 就显得有些平淡了。
这次实测中,Sol 的多模态推理表现一般,个别逻辑推断任务还会出现漏洞;相比之下,它在复杂任务上的发挥比上一代同级模型有所提升,稳定性也更好。换句话说,Sol 更擅长把一个复杂项目做出来,单拼某一道高难度推理题时,优势并不明显。
作为 GPT-6 系列的主力模型,Sol 确实什么都能做,代码、网页、视觉理解、复杂任务编排基本都能覆盖;但在旗舰模型中,它更偏稳定和保守,没有出现把同级模型远远甩开的跨越式提升。
就本次案例而言,Sol 在复杂代码生成和 3D 网页开发上表现不错,生成的项目已经具备比较完整的工程结构,能够同时处理相机系统、动画、音效、交互逻辑等多层需求。相比 GPT-5.6 Terra,它在技术实现上的提升相当直观。
但从实际体感来看,如果只追求最强的编程能力,Sol 目前还没有展现出旗舰级的碾压感。尤其和同期的 Claude Opus 5.5 相比,Sol 在一些复杂编程任务上仍被拉开差距,Astra 也依然是更高一档的首选。Sol 更适合需要大量生成、反复修改、又希望控制成本的开发任务。
简单来说,它的编程优势更多来自能力、速度、成本三者之间的平衡。
这也是 GPT-6 Sol 发布后最先被关注的地方。
Sol 的 API 价格已降到每百万 token 输入 $2、输出 $10,输入价与 GPT-5.6 Terra 持平,输出价更低。同时,GPT-6 新的缓存机制还能进一步压低重复上下文带来的成本。
这意味着,即便它没有在每项能力指标上都令人惊艳,对每天都要和 Agent、代码、长上下文任务打交道的用户来说,够用的能力、稳定的水平加上更低的成本,本身就是最大的优势。尤其是长周期 Coding Agent、复杂网页生成、批量任务这类场景,单次生成也许只花几美元,但每天跑几十次,模型之间的成本差距很快就会被放大。
从这个角度看,Sol 的产品定位非常清楚:一个可以放心大量调用的高能力主力模型。
这次发布,价格是 GPT-6 Sol 最大的亮点。值不值得用,还要看具体任务和取舍;对 Sol 而言,价格便宜一半带来的优势,远大于能力提升的幅度。
转自 302.AI
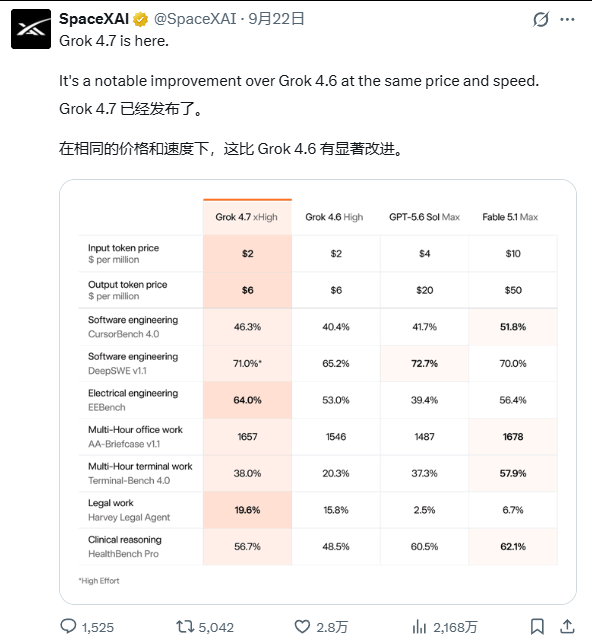
9 月 22 日,SpaceXAI 正式推出最新旗舰模型 Grok 4.7。官方稿里最朴素的一句话,也是这次发布的核心卖点:与 Grok 4.6 同价同速($2/$6),能力大幅升级。
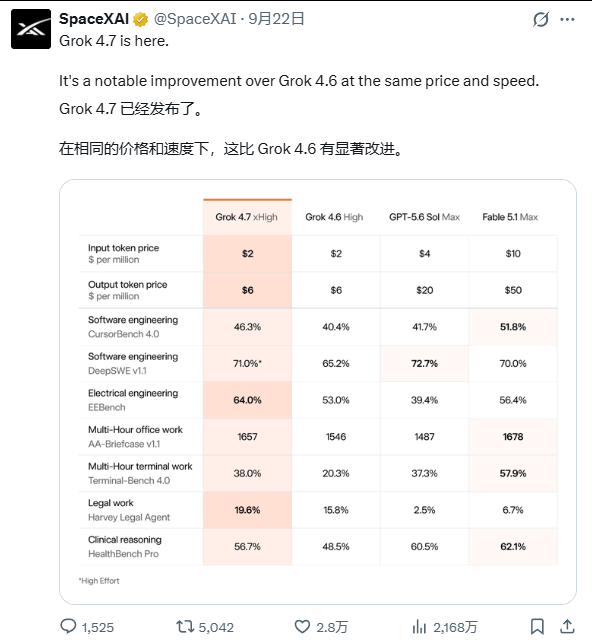
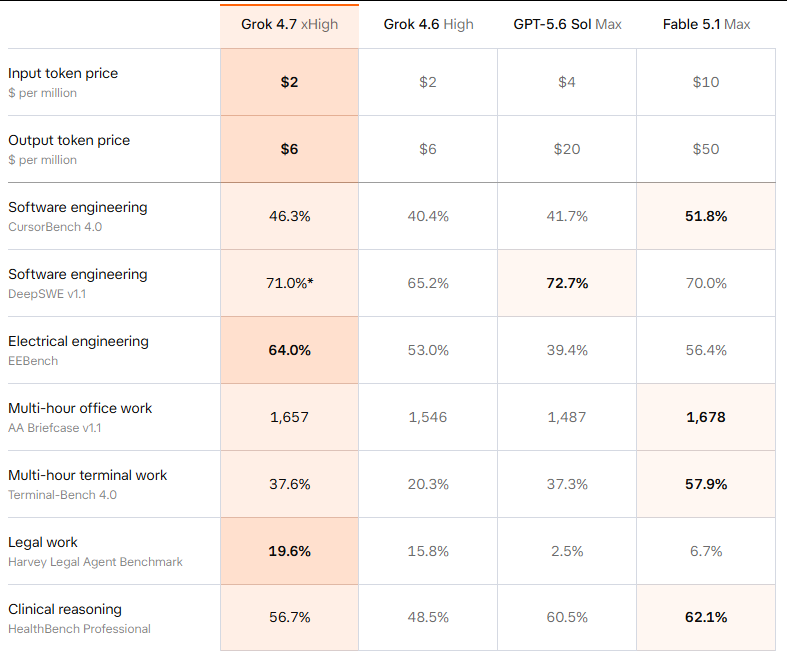
这张官方对比表传达的核心信息是:单看分数,Grok 4.7 并不是冠军;把价格算进来,它就成了最具性价比的模型。
以 CursorBench 为例,Fable 5.1 的分数高出 5.5%,成本却高出五倍以上;在 Harvey 法律基准上,Grok 4.7 拿到 19.6%,Fable 5.1 只有 6.7%,以更低的价格换来近三倍的分数。
所以官方的措辞相当准确:它不是最强的模型,而是处在“性价比前沿”(at the frontier in price-performance)。智能不封顶,定价封顶,这就是马斯克眼下的打法。
尴尬的是,九月末这一波密集的模型更新,让这张对比表一发布就过时了:Grok 4.7 如今的对手已经是 GPT-6 Astra 与 Opus 5.5。
价格之外,安全能力也是官方重点提及的方向。官方给出了一组双向指标,既看危险请求能否拦住,也看正常工作会不会被误伤:
一个模型的护栏水平,不取决于它拒绝了多少坏请求:坏请求全部拒绝谁都做得到,把分数刷到 100% 毫无意义。真正要看的是,它在拒绝坏请求的同时,能把误拦控制在什么水平。96.7% 的拒绝率与低误伤,正是 Grok 4.7 所强调的。
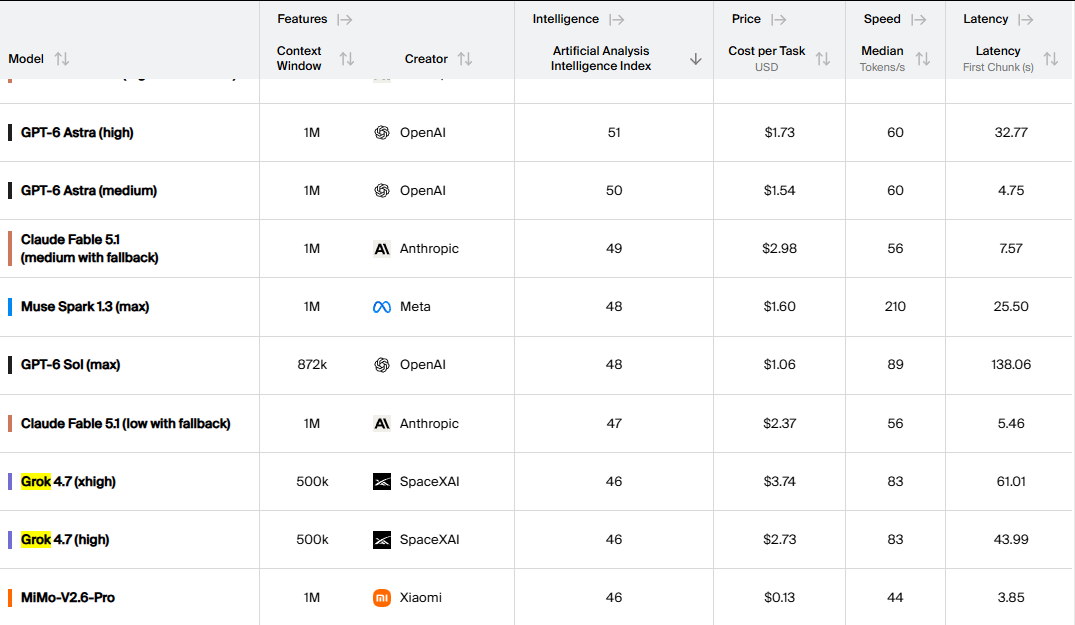
在 Artificial Analysis 榜单中,Grok 4.7 排名第 16 位。
Grok 4.7 的实际生产力边界究竟在哪里?以下是它与 GPT-6 Sol 在同一套题目下的对比实测。
| 模型 | 上下文窗口 | 官方价格(每百万 token,输入/输出) |
|---|---|---|
| grok-4.7 | 500K | $2 / $6 |
| gpt-6-sol | 1M | — |
本次评测侧重逻辑、数学、编程、多模态和人类直觉类问题,并非专业前沿领域的权威测试,目的是观察模型的进化趋势,为选型提供参考。
编程案例按以下等级评定:
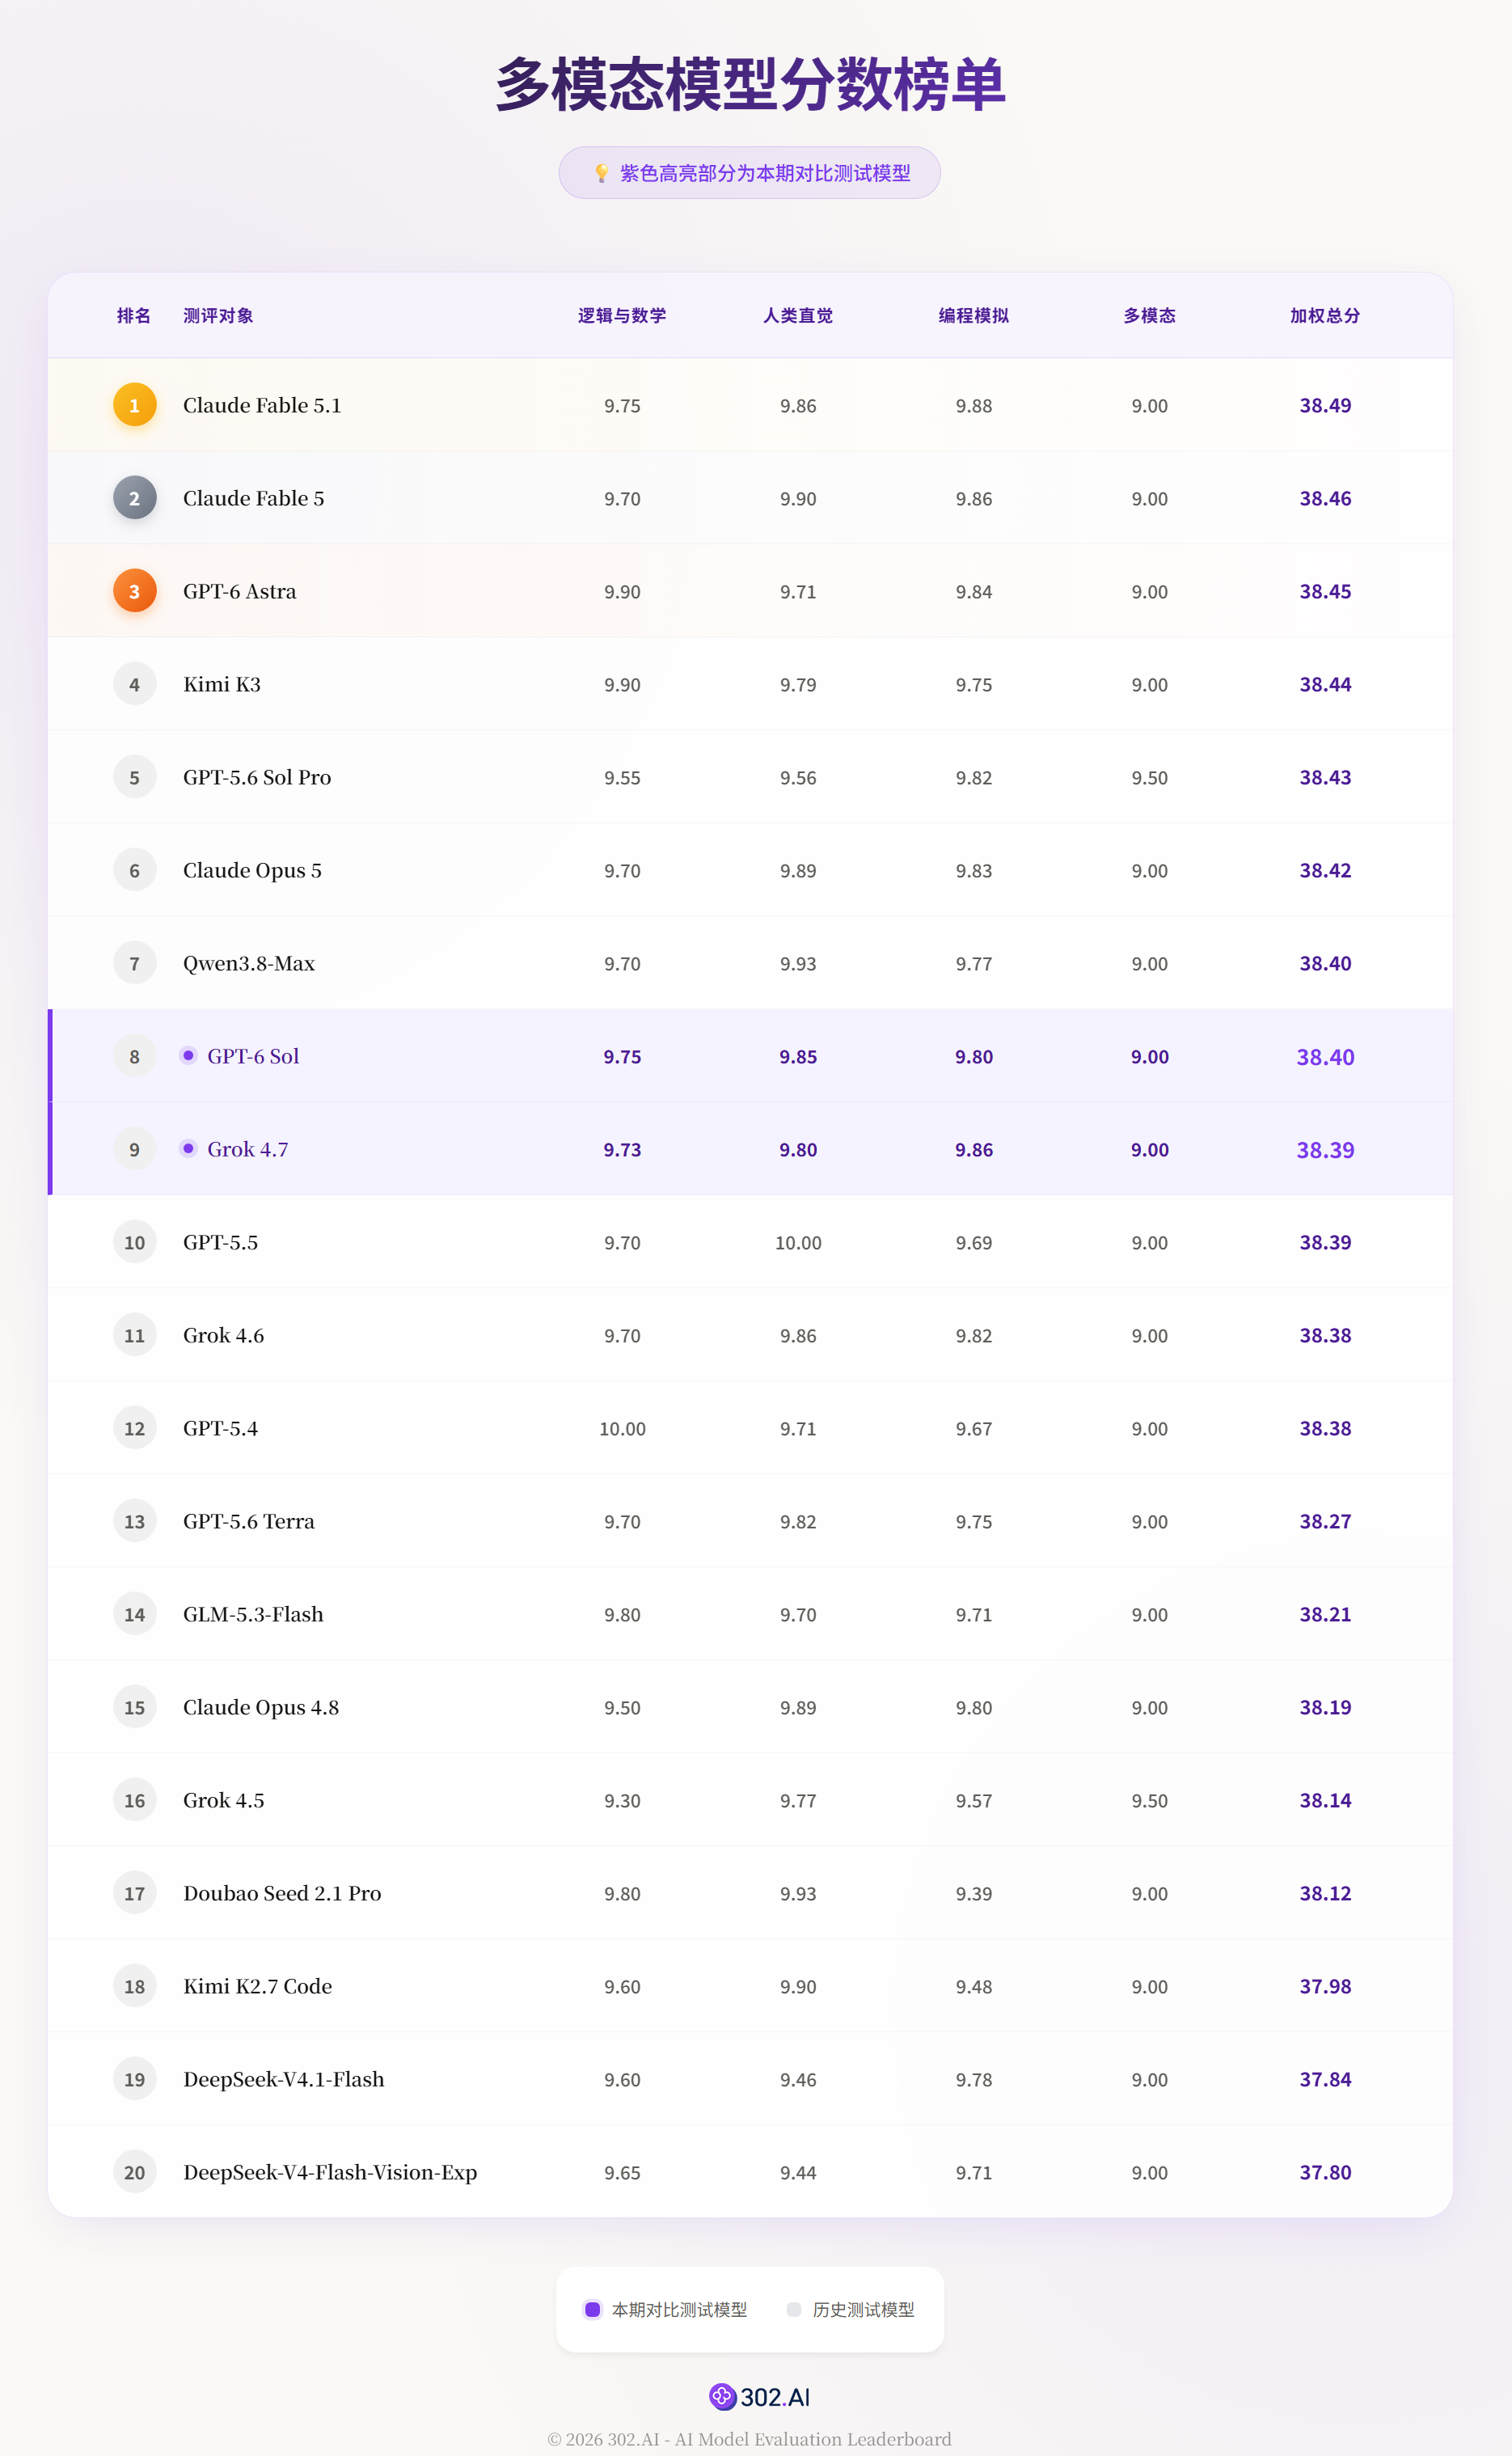
GPT-6 Sol 加权总分 38.40,排第 8;Grok 4.7 以 38.39 紧随其后,排第 9,上一代 Grok 4.6 为 38.38,排第 11。分项上,Grok 4.7 在编程模拟上领先(9.86 对 9.80),逻辑与数学(9.73 对 9.75)和人类直觉(9.80 对 9.85)略逊,多模态两者同为 9.00。
提示词:根据以下图片,推测它们分别描述的是哪些著名电影。
答案:
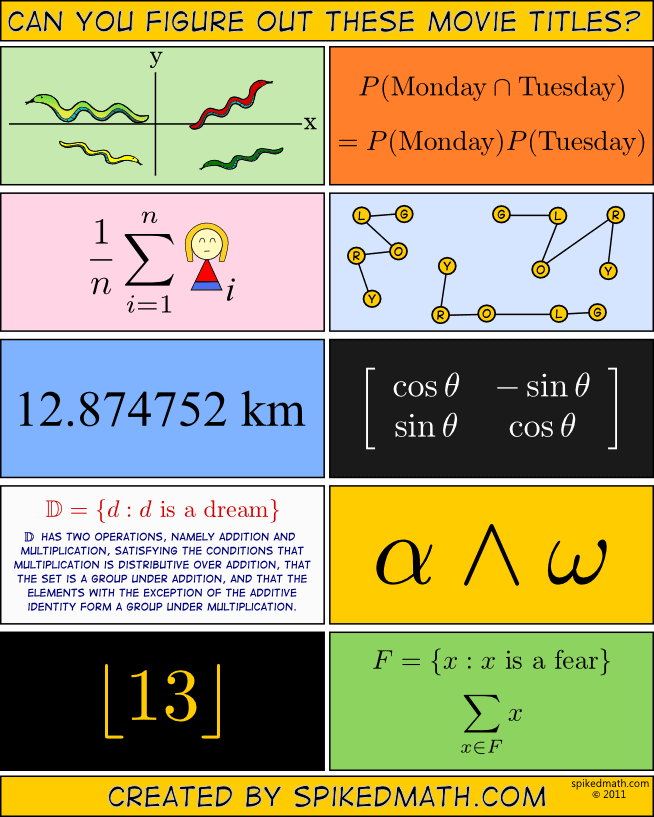
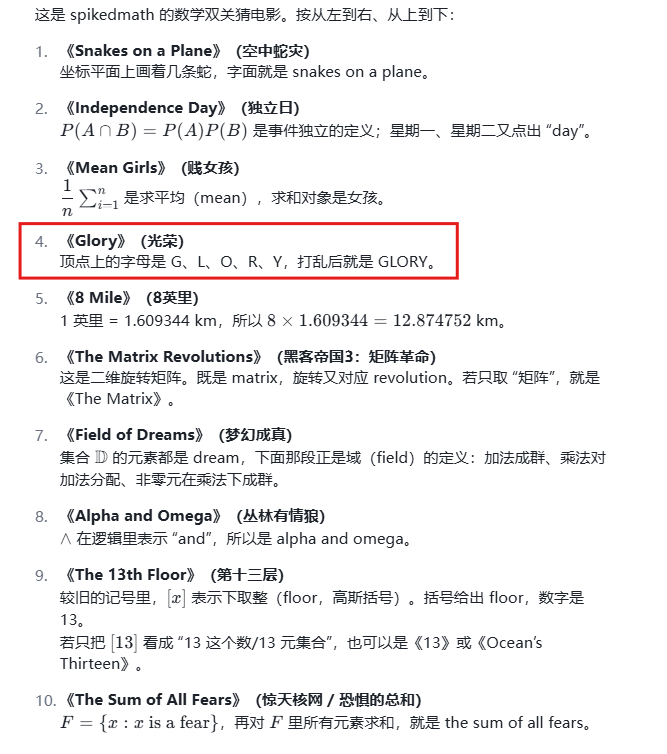
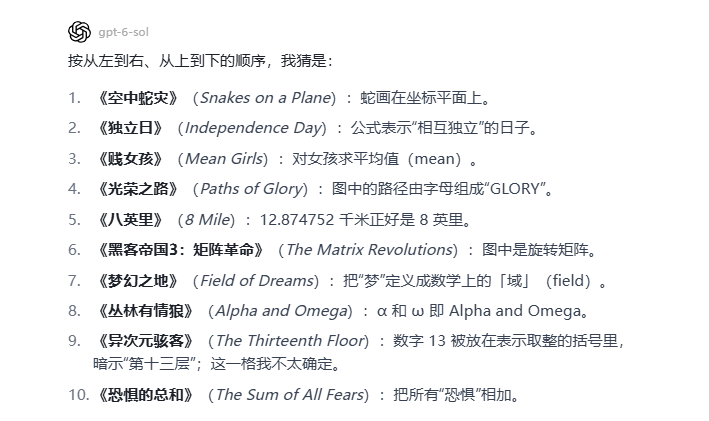
提示词一:绘制一幅运动员在网球对打的动态 SVG 图。
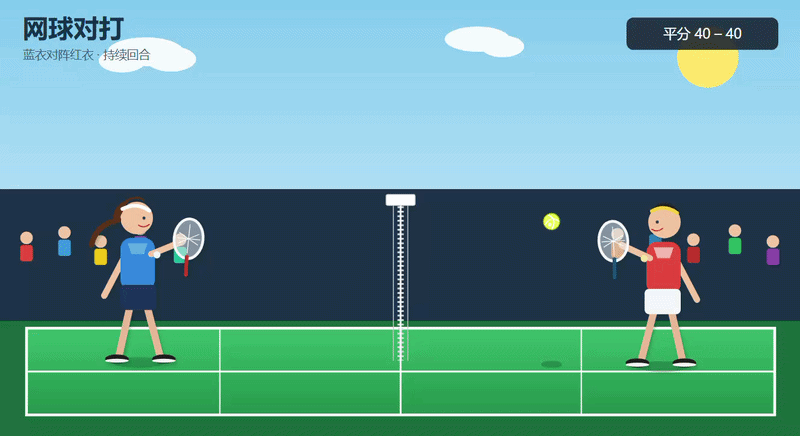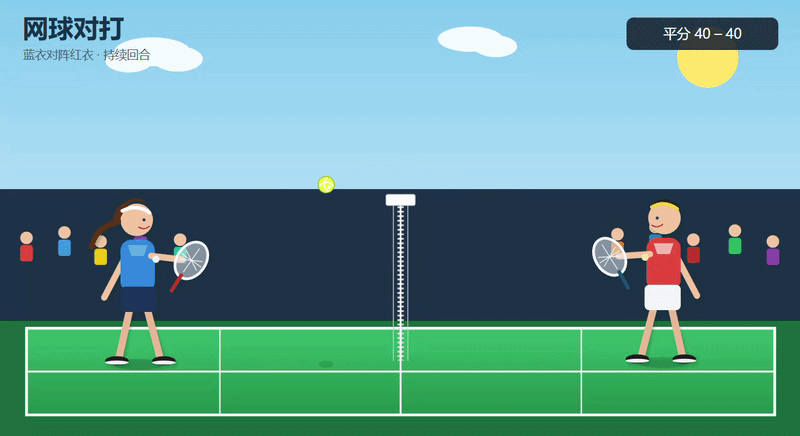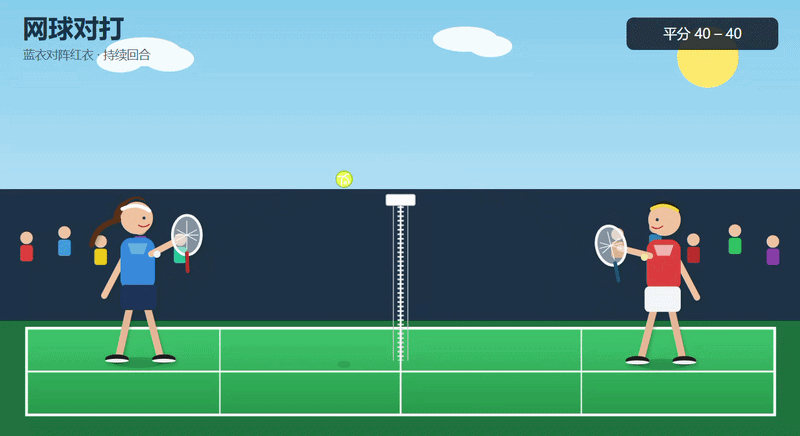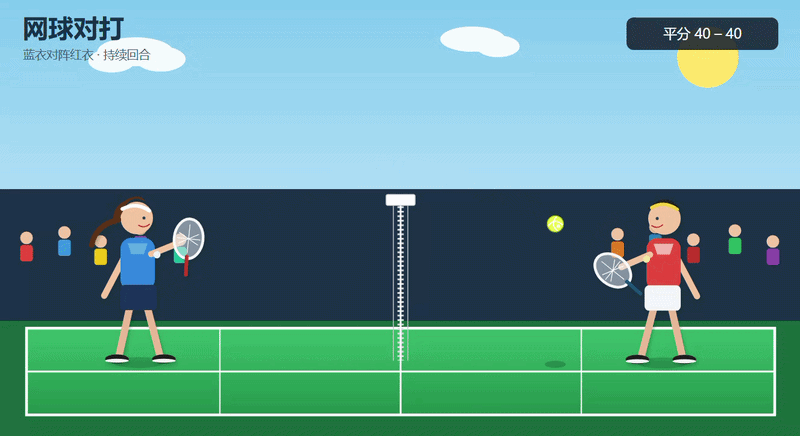
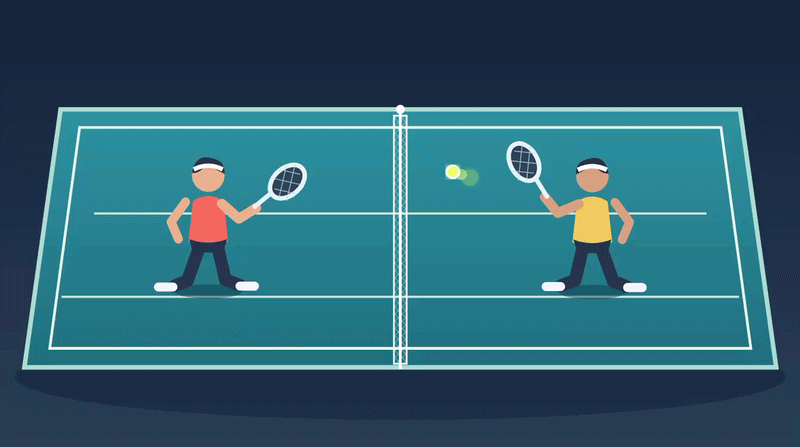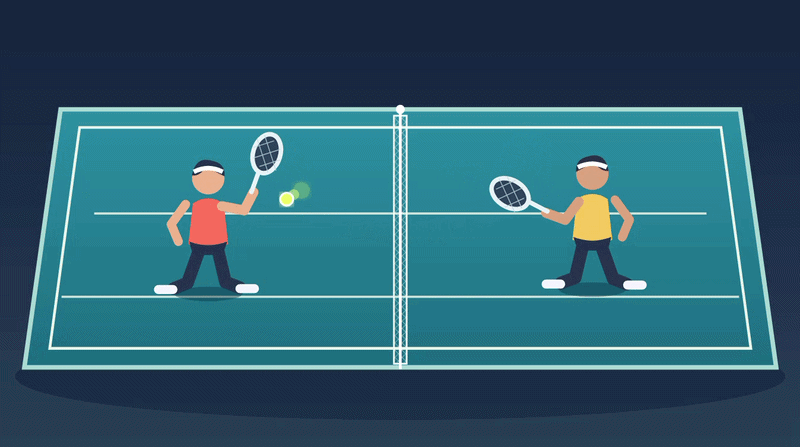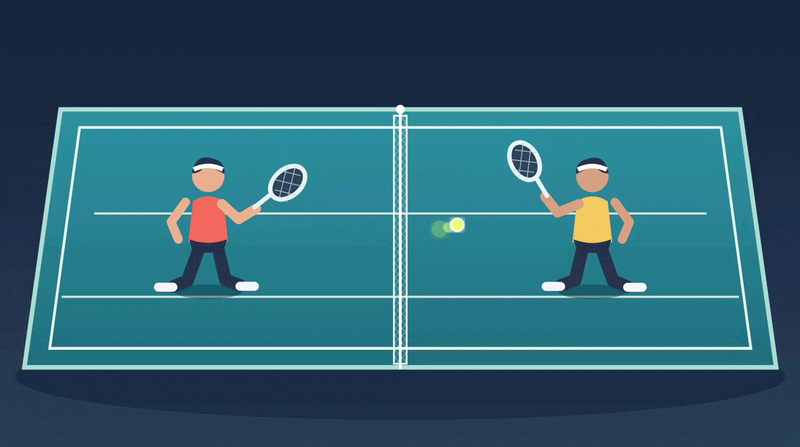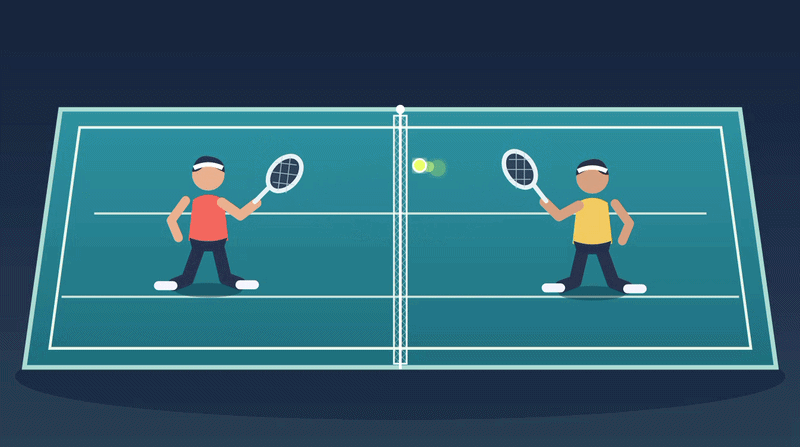
提示词二:绘制一幅马快跑到河边饮水的动态 SVG 图。
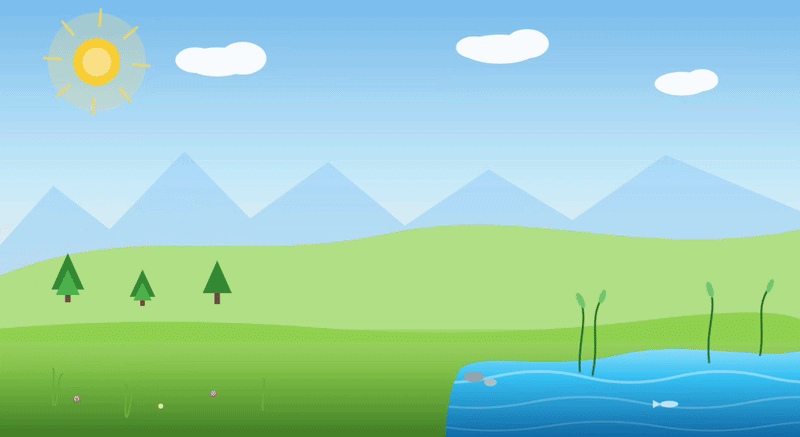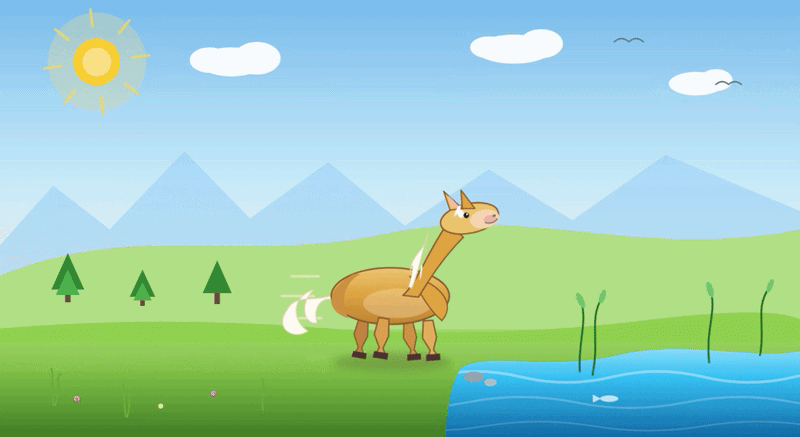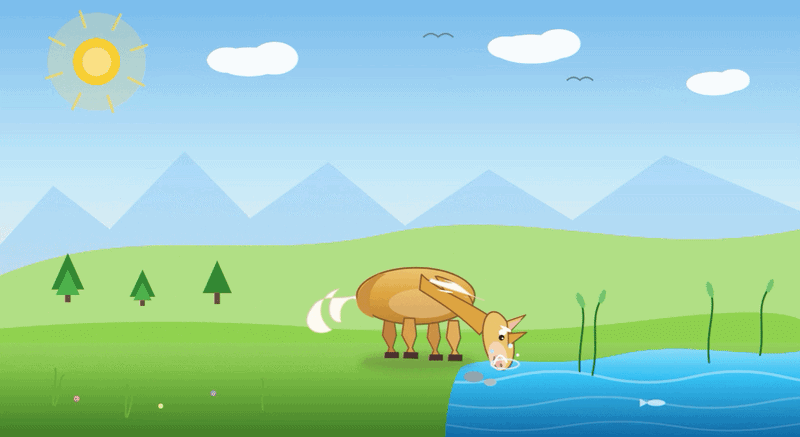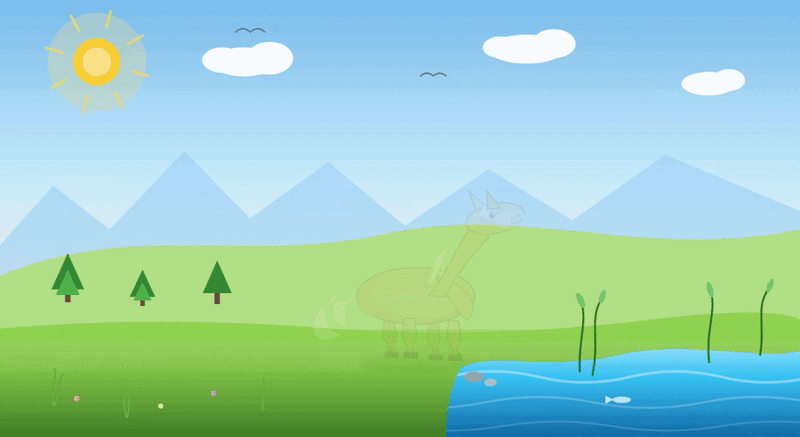
| 测评点 | Grok 4.7 | GPT-6 Sol |
|---|---|---|
| 语义表达准确度 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ |
| 图形构造复杂度 | ⭐⭐⭐ | ⭐⭐⭐ |
| 动态实现质量 | ⭐⭐⭐⭐ | ⭐⭐⭐ |
提示词(英文原文):
Create a polished 3D endless runner game as a single self-contained HTML file.
The gameplay should be inspired by the familiar mechanics of mobile endless runners: the character automatically runs forward along a multi-lane path, while the player can switch lanes, jump, slide, and dodge obstacles. Add collectible items, increasing speed, score tracking, and game-over/restart states.
Create a completely original setting, characters, environment, and visual identity. Do not copy the visual style, characters, locations, props, UI, or assets of any existing game. Use a stylized 3D aesthetic with a strong sense of depth and motion.
Include:
Smooth third-person camera following the character
Three-lane movement with responsive controls
Jumping, sliding, and obstacle avoidance
Procedurally generated sections so the run can continue
Moving obstacles and varied environmental hazards
Collectibles and score progression
Increasing difficulty and speed
Polished animations, lighting, particles, and camera effects
Keyboard and mouse controls
A clear start screen, HUD, game-over screen, and restart button
The final result should feel like a complete, polished 3D mini-game rather than a technical demo.优势:
不足:
优势:
不足:
| 测评点 | Grok 4.7 | GPT-6 Sol |
|---|---|---|
| 玩法创意性 | ⭐⭐⭐⭐ | ⭐⭐⭐⭐ |
| 视觉执行力 | ⭐⭐ | ⭐⭐⭐ |
| 技术实现 | ⭐⭐ | ⭐⭐⭐⭐ |
提示词(英文原文):
Create a premium immersive 3D web experience about the history and making of traditional Chinese mooncakes, delivered as a single self-contained HTML file.
Design it as a cinematic digital museum rather than a conventional webpage. The visitor should move through a virtual exhibition space and experience the story through carefully choreographed camera movements, lighting, animations, spatial transitions, and interactive 3D objects.
The experience should include:
Origin & History — a cinematic introduction explaining the origins and cultural evolution of mooncakes through an immersive historical gallery.
Ingredients — interactively explore flour, lotus seeds, egg yolks, nuts, and other ingredients as detailed 3D objects.
Making Process — show the complete process: preparing the filling, making the dough, wrapping, shaping with a wooden mold, baking, and the final mooncake emerging from the oven.
Mooncake Showcase — create several original regional and traditional mooncake variations with different shapes, patterns, fillings, and textures.
Cultural Story — connect mooncakes with the Mid-Autumn Festival, family reunion, the full moon, lanterns, and traditional Chinese symbolism.
Build all visual elements yourself with Three.js and procedural geometry/materials. Do not rely on external images, downloaded 3D models, stock assets, or image textures. Model the mooncakes, ingredients, utensils, exhibition architecture, lanterns, moon, clouds, tables, shelves, and other major visual elements from scratch.
Use a sophisticated visual language: dark museum architecture, warm golden illumination, subtle volumetric atmosphere, realistic materials, soft shadows, reflections, floating particles, and restrained Chinese-inspired visual details.
The transitions should feel like a digital film or high-end interactive museum installation rather than a website slideshow. Use cinematic camera choreography, depth of field, slow reveals, object close-ups, environmental animation, and smooth transitions between exhibition spaces.
Make the experience highly polished and interactive. Users should be able to explore objects, trigger animations, zoom into the mooncake-making process, and move naturally between different exhibition areas.
The final result should feel like an award-winning interactive digital exhibition, with strong storytelling, atmosphere, spatial depth, and visual craftsmanship — not a collection of simple 3D objects placed on a webpage.优势:
不足:
优势:
不足:
| 测评点 | Grok 4.7 | GPT-6 Sol |
|---|---|---|
| 视觉执行力 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐ |
| 叙事与信息完整度 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ |
| 交互与用户体验 | ⭐⭐⭐⭐ | ⭐⭐⭐ |
评价 Grok 4.7 始终绕不开一组矛盾:脱离价格谈性能,它算不上赛场上的最高分选手;把成本纳入权衡,它又站到了性价比的前沿。综合基准榜单和多轮实测来看,Grok 4.7 相比上一代 Grok 4.6 的提升确实可以感知,但与第一梯队旗舰相比,短板同样无法回避。
Grok 4.7 在长时任务和复杂知识方向上有所提升。对于需要模型持续处理多个步骤、不断生成代码并维持整体结构的任务,这种优势会更加明显。
从本次实测案例看,Grok 4.7 拆解和执行复杂需求的能力都比较突出,案例 4 的数字博物馆效果尤其惊艳:模型一次性搭建起多展厅结构、相机巡览、交互系统和完整的内容叙事,最终产出的不是简单的 3D 物体堆砌,而是具备一定完整度的沉浸式体验。
Grok 4.7 沿用了上一代 Grok 4.6 的定价,输入每百万 token 2 美元、输出每百万 token 6 美元,按单价看确实是前沿模型里最低的一档。在能力已经可以与第一梯队竞争的情况下,这个价格留出了充足的使用空间。对于需要大量调用模型、又需要一定复杂任务能力的开发者,低单价会直接降低试错成本。
在官方基准中,Grok 4.7 在 CursorBench、Terminal-Bench、EEBench 等项目上都有明显提升,但第三方独立测试的分数有所回落,并没有同步来到绝对领先的位置。Artificial Analysis 综合榜单上它只排第 16 位,综合智能指数 46 分,与 GPT-6 Astra、Fable 5.1 拉开了一档差距。
实测案例同样显示,Grok 4.7 在复杂项目上具备较强的生成能力,但离真正意义上的工程优化还有一段距离。对于这类大型 HTML/Three.js 项目,代码越长,后续维护和修改的成本也越高。
此外,模型针对安全护栏做了迭代,生物安全和网络安全基准表现不错,兼顾了拦截风险请求和不误伤正常工作。但在通用对话和精细指令理解方面,偶尔可能出现输出冗余、逻辑僵硬的情况。
虽然 Grok 4.7 的定价与 Grok 4.6 完全一致,但部分社区反馈提到,处理复杂任务时模型会输出更长的推理链路,输出 token 消耗随之抬升。
简单任务下,Grok 4.7 的单 token 成本优势明显;而在长流程、持续迭代的场景中,整体花费不一定比高端模型更低。
Grok 4.7 并没有朝全能通用模型的方向做全面迭代,而是把资源更多地倾斜到了长流程工程、Agent 这类专项能力上。它的能力区间不能单凭跑分来定义,潜在问题也不能用低价标签来掩盖。实际选型时,除了参考基准分数和公开标价,还需要把任务复杂度、迭代次数、token 消耗等实际运行因素纳入考量,才能判断它是否适合自己的业务场景。
转自 302.AI
9 月 22 日 Anthropic 发布 Opus 5.5 时,不少开发者就在等 Sonnet 5.5 和 Haiku 5.5。10 月 8 日 Haiku 5.5 上线,Claude 5.5 家族至此补齐:Opus 5.5(旗舰,输入/输出每百万 token $4/$20)、Sonnet 5.5(主力,$2/$10)、Haiku 5.5(轻量,$0.10/$0.50)。
这次发布最受关注的是价格:$0.10/$0.50 与 OpenAI 的 GPT-6 Luna 完全一致。两家公司这两个月在中高端模型上贴身竞争,到了轻量级,连价签都不再错开。
官方 benchmark 表里有一行格外醒目:在 Terminal-Bench 4.0(命令行多步任务)上,Haiku 4.5 的成绩是 0.0%,Haiku 5.5 是 39.2%。
上一代 Haiku 在这项测试中一件任务都没完成。这也是过去两年小模型的普遍处境:总结、分类、改写、翻译可以胜任,但只要任务需要长程规划,就无能为力。
Haiku 4.5 到 5.5 的主要指标变化如下:
| 基准 | Haiku 4.5 | Haiku 5.5 | 提升 |
|---|---|---|---|
| 知识工作 GDPval-AA | 735 | 1620 | 2.2× |
| 办公任务 AA-Briefcase | 614 | 1578 | 2.6× |
| 计算机操作 OSWorld 2.1 | 15.7% | 72.4% | 4.6× |
| 跨学科推理 HLE(无工具) | 10.2% | 45.9% | 4.5× |
| 命令行任务 Terminal-Bench | 0.0% | 39.2% | 从零到有 |
| 图表理解 Chartography | 6.4% | 46.4% | 7.2× |
提升明显,但不宜拿它和旗舰比。官方选的参照是中端主力 Sonnet 5.5:Terminal-Bench 70.6%,OSWorld 83.9%。
这组数字真正说明的是:小模型的能力边界从“不能”变成了“入门”。OSWorld 72.4% 意味着 Haiku 级模型第一次能胜任真实的电脑操作任务;Terminal-Bench 39.2% 意味着它能完成约四成需要连续执行几十步的任务。
Anthropic 对 Haiku 5.5 的定位很明确:摘要、上下文压缩(compaction)、数据库查询、分类这类快速且重复的工作;凭借速度优势,适合在线客服、浏览器操作等对延迟敏感的场景;以及作为 Opus/Sonnet 的 subagent 参与编码。
用过 Agent 编程的人对这个场景不会陌生:Opus 在规划代码架构时,需要有人翻文档、查日志、跑测试、做摘要,让旗舰亲自做这些显然大材小用。Haiku 5.5 就是来承担这些跑腿活的。它首次在 Haiku 级别提供 5.5 家族同款的自适应思考和 effort 档位,简单任务压低档位,复杂任务调高;支持 1M token 上下文、128k 输出,并原生支持浏览器操作工具。
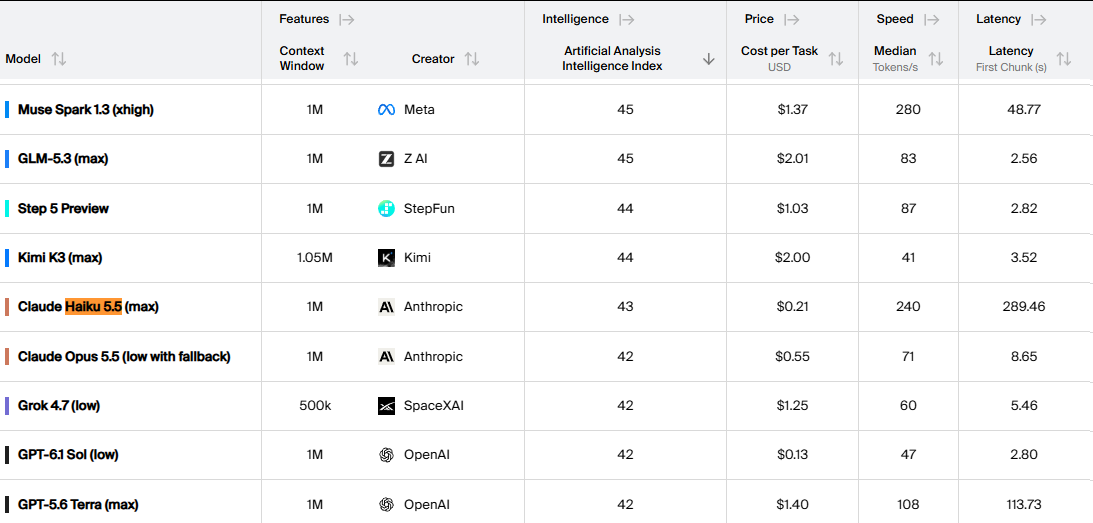
在 Artificial Analysis 榜单中,Haiku 5.5 目前总排名第 31 位,在 Flash 级别模型中排名第一。
基准分数之外,同价位的实际表现更值得关注。以下是 Haiku 5.5 与 GPT-6 Luna 在同一套题目下的对比实测。
| 模型 | 上下文窗口 | 官方价格(每百万 token,输入/输出) |
|---|---|---|
| claude-haiku-5-5 | 1M | ≤ 100K:$0.10 / $0.50;> 100K:$0.50 / $2.50 |
| gpt-6-luna | 1.05M | ≤ 272K:$0.10 / $0.50;> 272K:$0.20 / $0.75 |
本次评测侧重逻辑、数学、编程、多模态和人类直觉类问题,并非专业前沿领域的权威测试,目的是观察模型的进化趋势,为选型提供参考。
编程案例按以下等级评定:
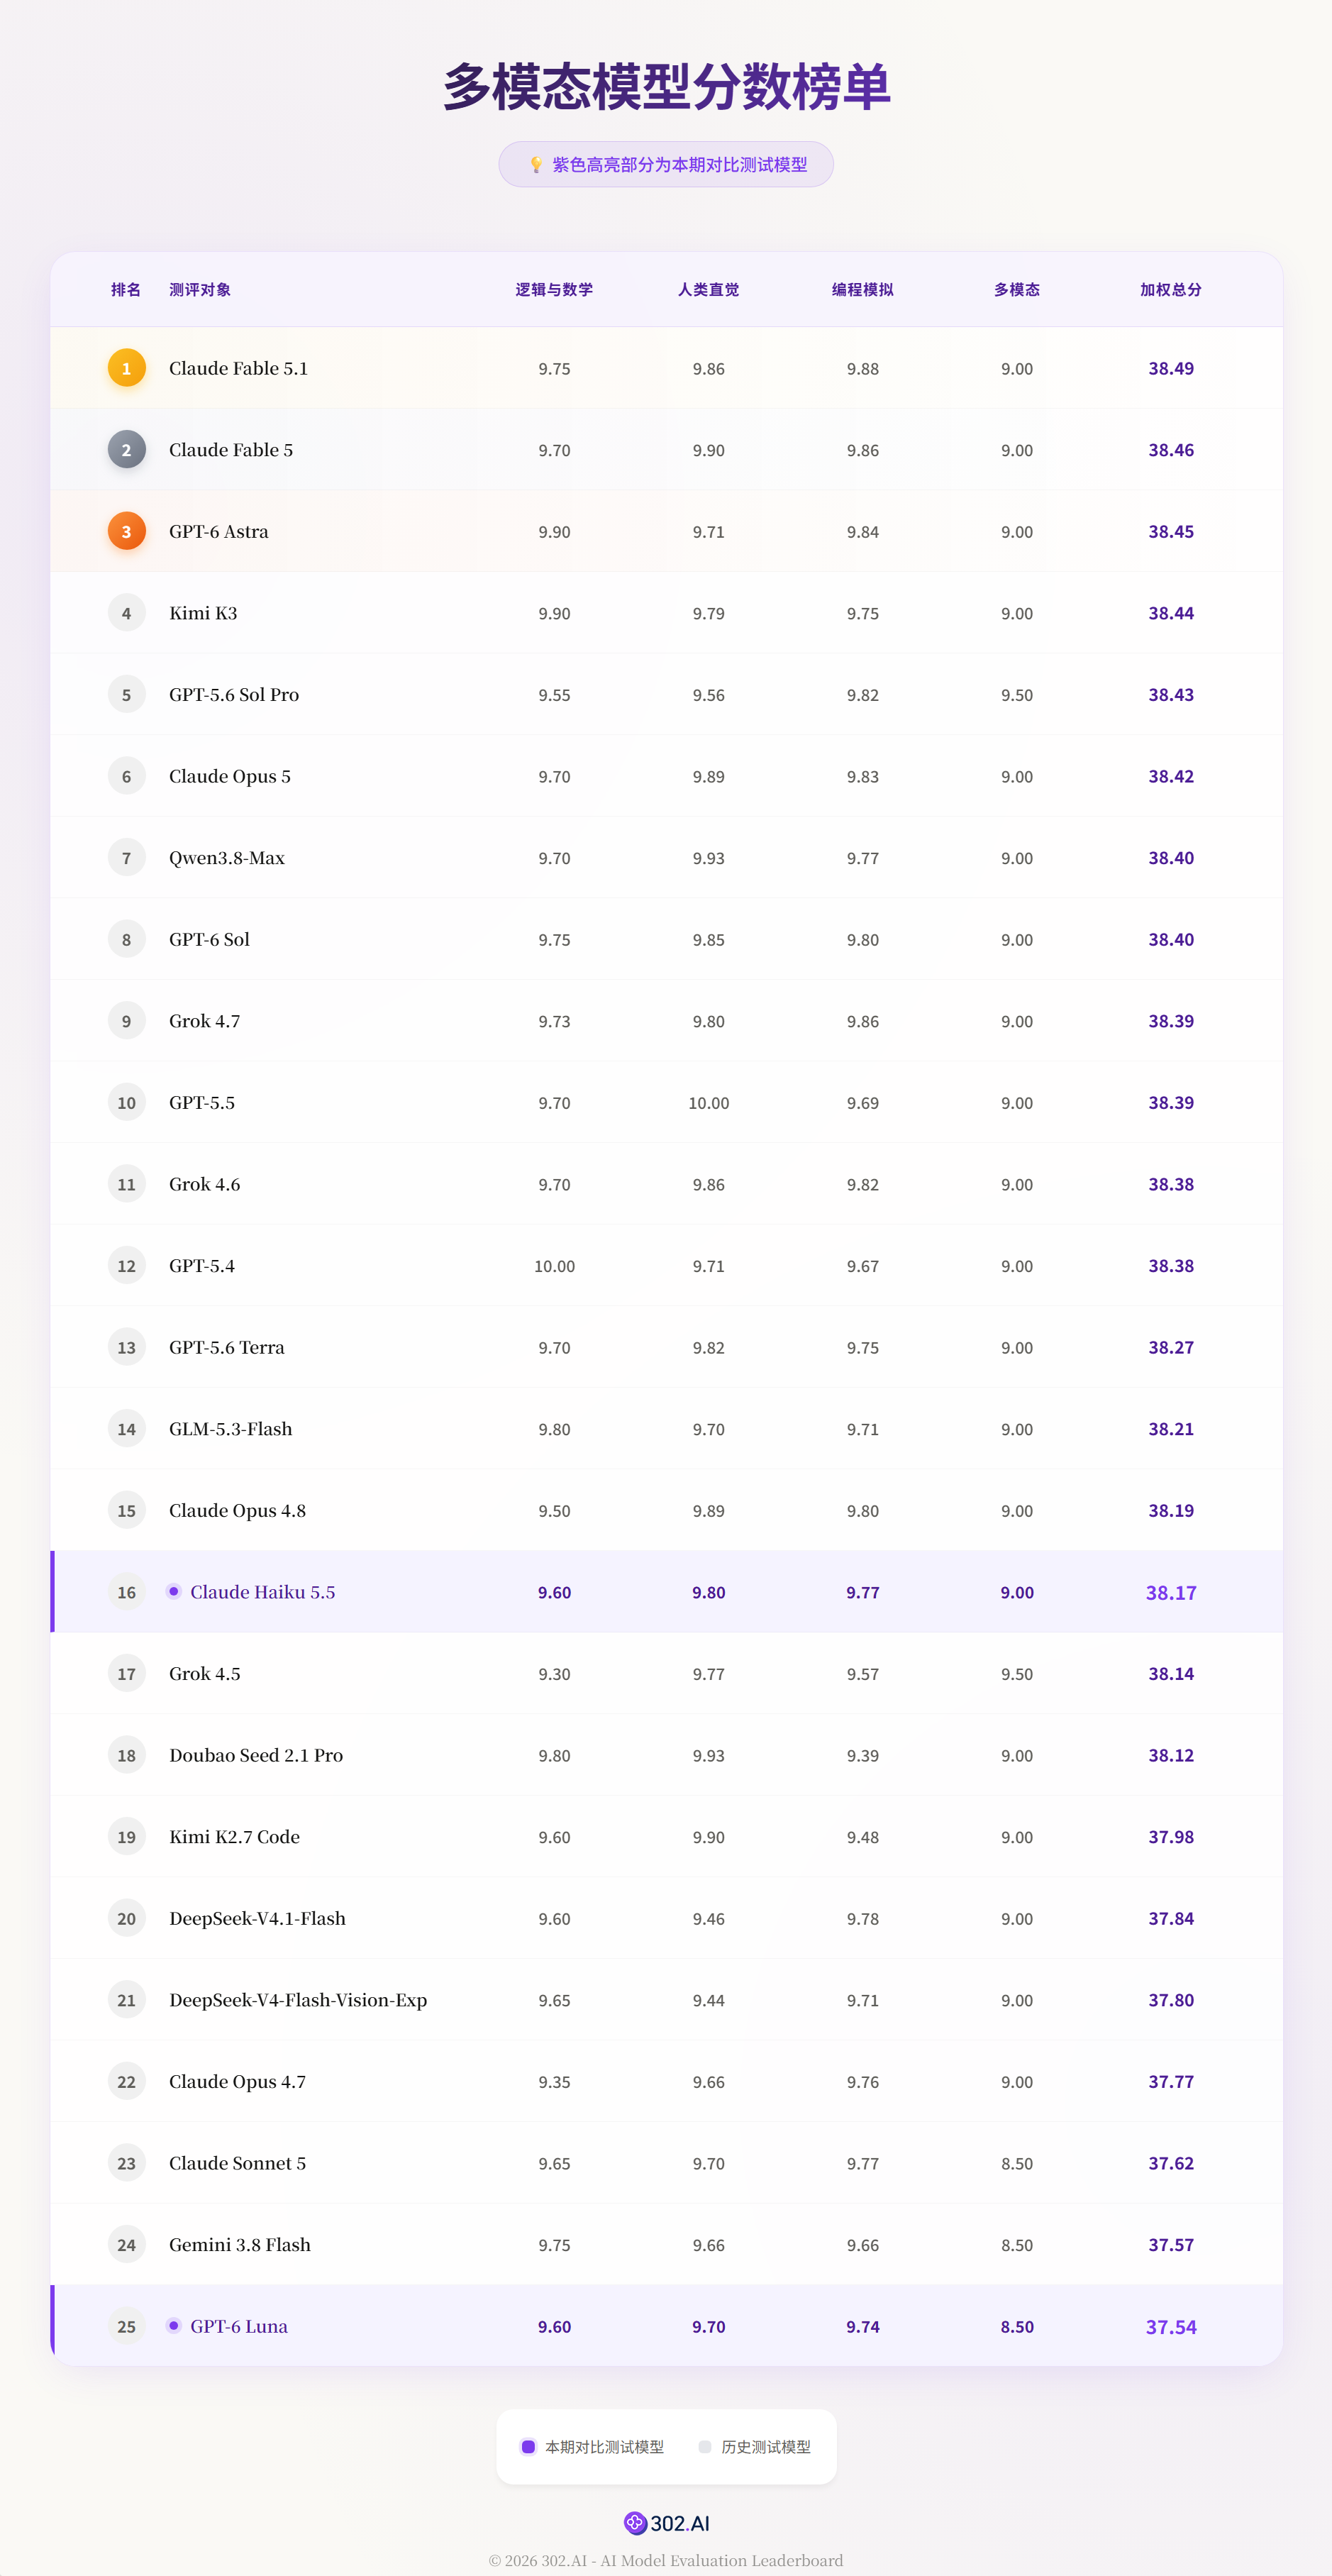
Haiku 5.5 加权总分 38.17,在榜单中排第 16;GPT-6 Luna 37.54,排第 25。两者在逻辑与数学上同为 9.60 分,Haiku 5.5 在人类直觉(9.80 对 9.70)、编程模拟(9.77 对 9.74)和多模态(9.00 对 8.50)上均领先。
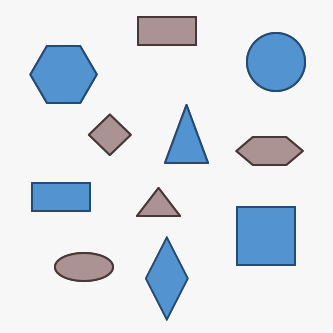
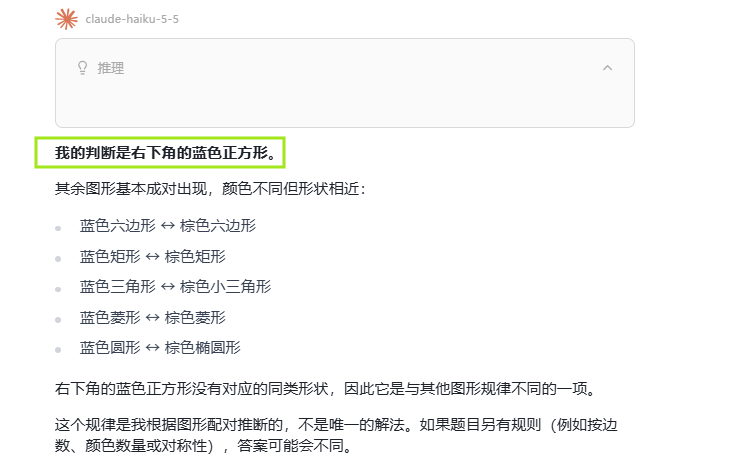
提示词:找出与其他图形规律有区别的一项。
答案:蓝色正方形。每个图形都有一个对应的异色复制项,只有蓝色正方形没有。
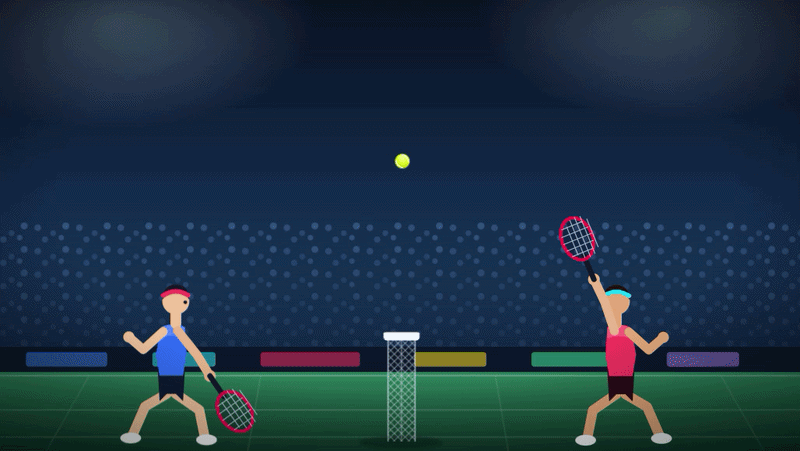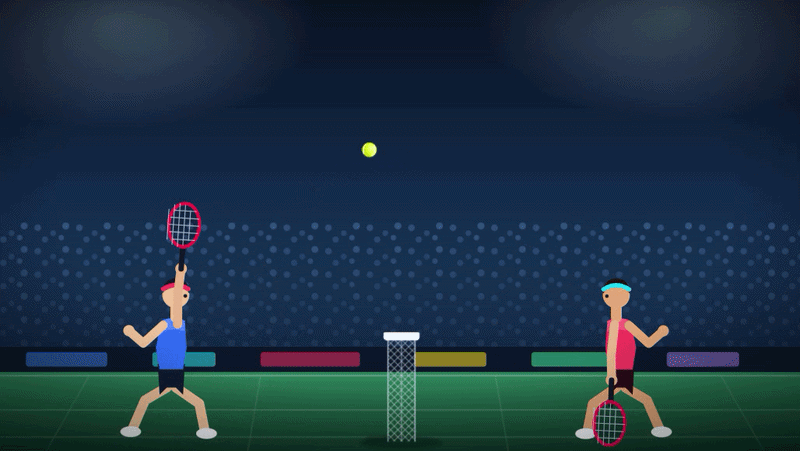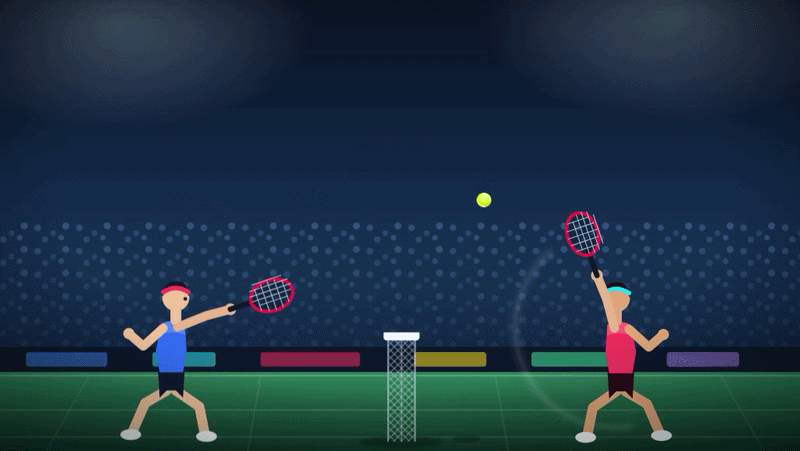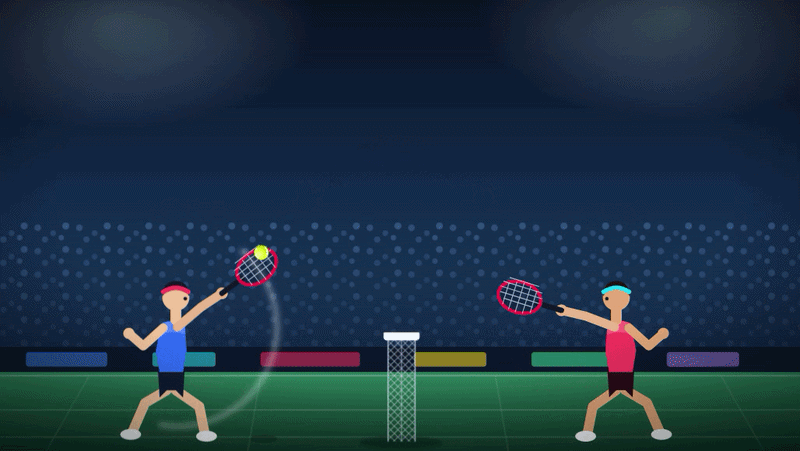
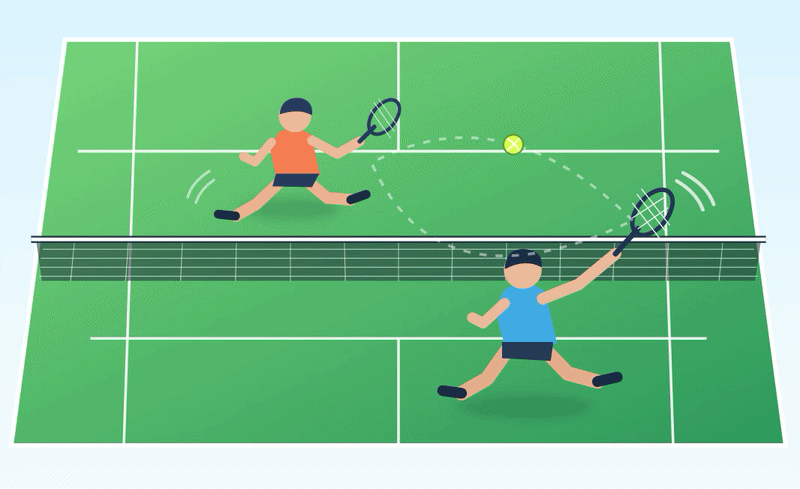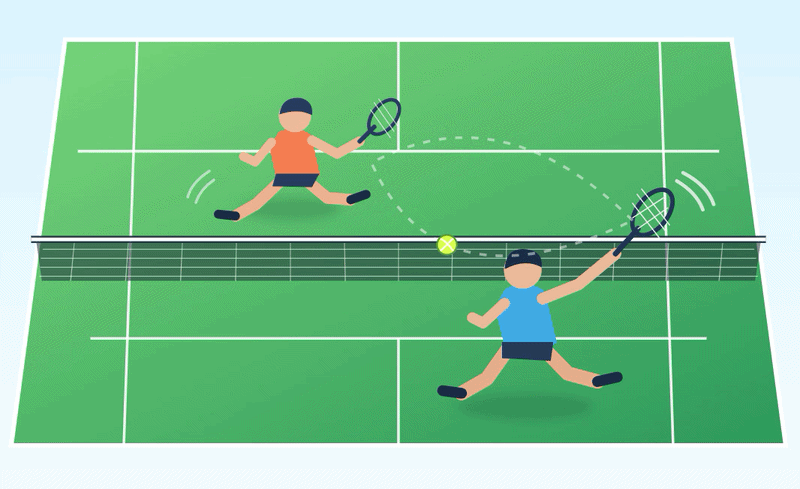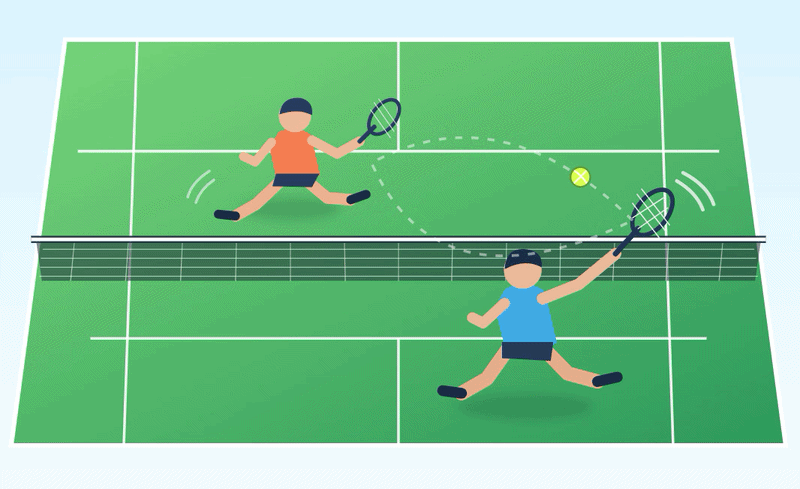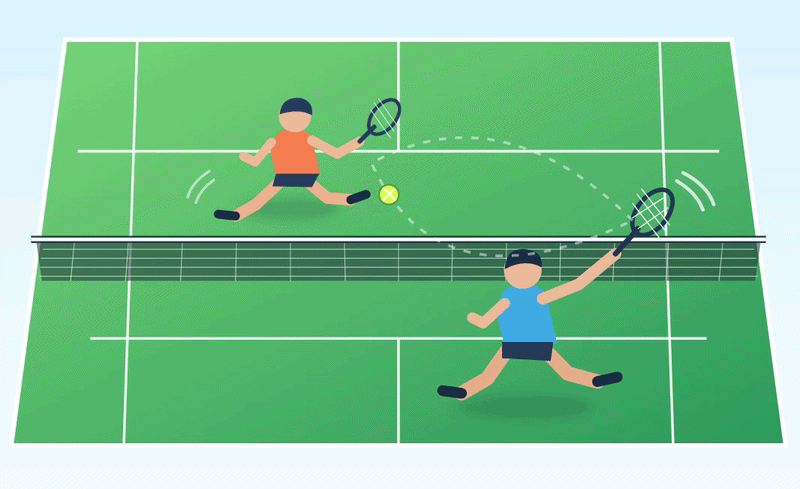
提示词一:绘制一幅运动员在网球对打的动态 SVG 图。
提示词二:绘制一幅马快跑到河边饮水的动态 SVG 图。
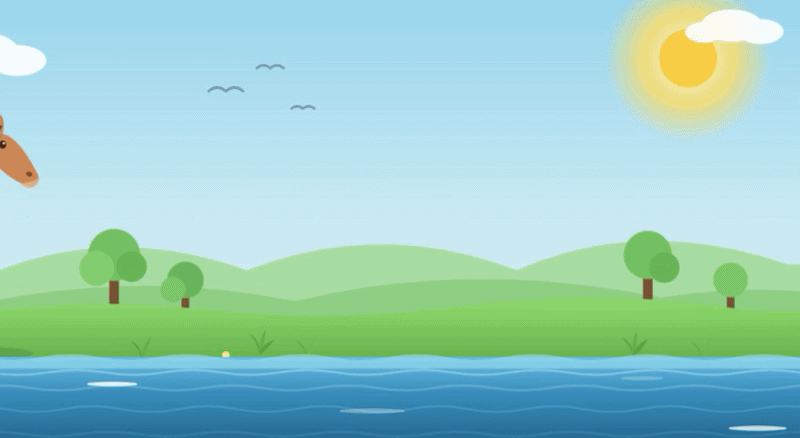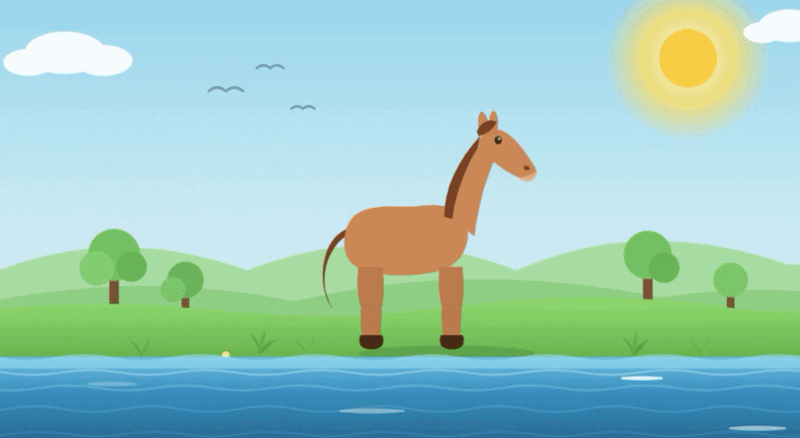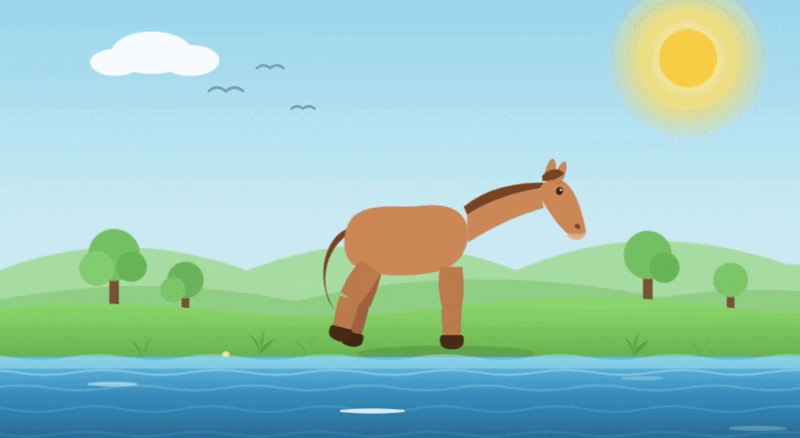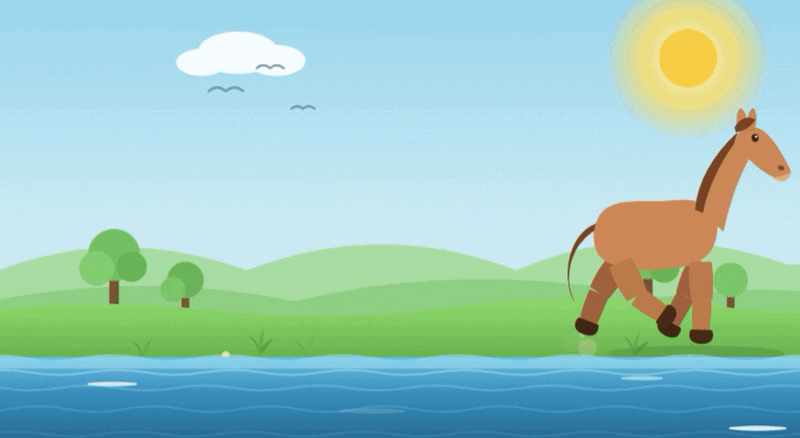
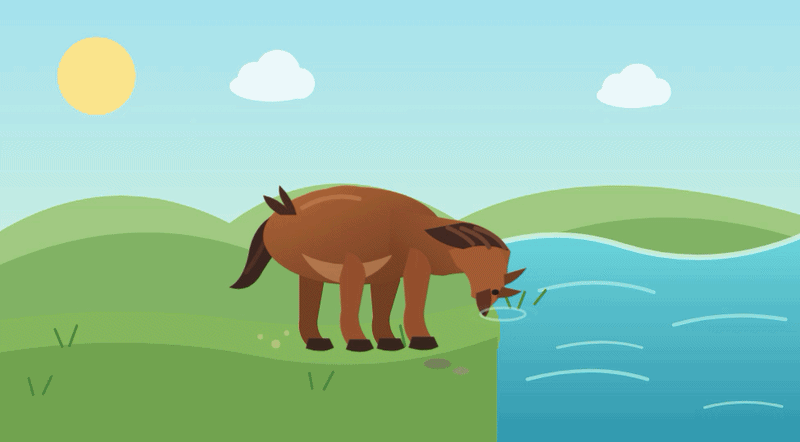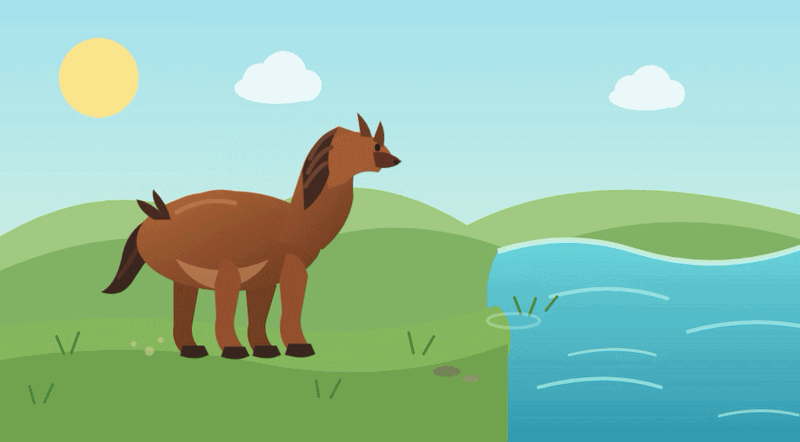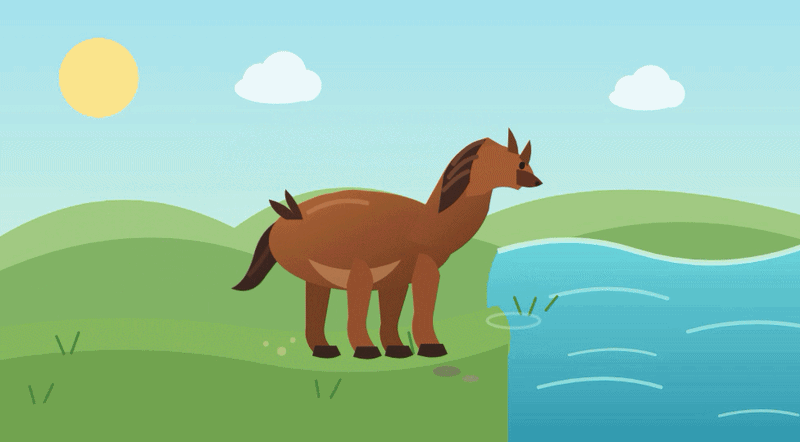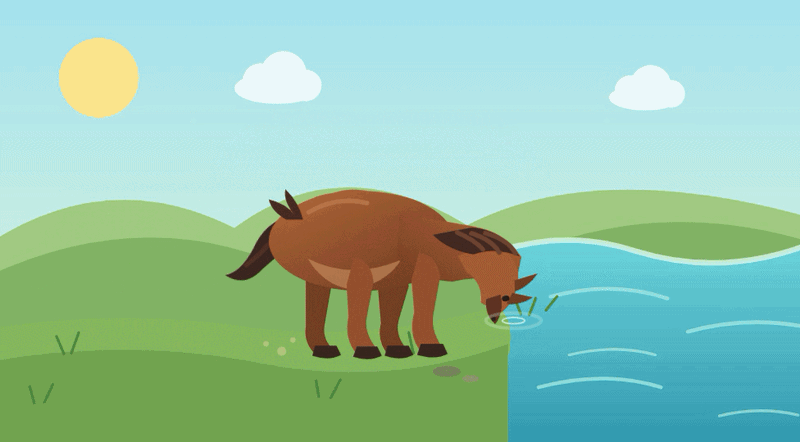
简评:Haiku 5.5 在图形构成复杂度和动态表现上都略优于 GPT-6 Luna。
| 测评点 | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| 语义表达准确度 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ |
| 图形构造复杂度 | ⭐⭐⭐⭐ | ⭐⭐⭐ |
| 动态实现质量 | ⭐⭐⭐ | ⭐⭐ |
提示词(英文原文):
Create a polished 3D endless runner game as a single self-contained HTML file.
The gameplay should be inspired by the familiar mechanics of mobile endless runners: the character automatically runs forward along a multi-lane path, while the player can switch lanes, jump, slide, and dodge obstacles. Add collectible items, increasing speed, score tracking, and game-over/restart states.
Create a completely original setting, characters, environment, and visual identity. Do not copy the visual style, characters, locations, props, UI, or assets of any existing game. Use a stylized 3D aesthetic with a strong sense of depth and motion.
Include:
Smooth third-person camera following the character
Three-lane movement with responsive controls
Jumping, sliding, and obstacle avoidance
Procedurally generated sections so the run can continue
Moving obstacles and varied environmental hazards
Collectibles and score progression
Increasing difficulty and speed
Polished animations, lighting, particles, and camera effects
Keyboard and mouse controls
A clear start screen, HUD, game-over screen, and restart button
The final result should feel like a complete, polished 3D mini-game rather than a technical demo.优势:
不足:
优势:
不足:
| 测评点 | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| 玩法创意性 | ⭐⭐⭐ | ⭐⭐⭐ |
| 视觉执行力 | ⭐⭐⭐ | ⭐⭐⭐ |
| 技术实现 | ⭐⭐⭐⭐ | ⭐⭐ |
提示词(英文原文):
Create a polished, interactive editorial website titled "The Making of a Painting", exploring how Vincent van Gogh created The Starry Night.
Design it as an immersive digital art exhibition, not a standard gallery or information page. Use elegant typography, generous whitespace, subtle paper textures, large artwork, and a restrained palette inspired by the painting.
Structure the experience as a visual journey:
Opening: Full-screen artwork, title, artist, year, and subtle background motion.
The Context: Explore the painting's historical background, creation, and Van Gogh's circumstances through archival imagery and concise text.
The Sketch: Present preparatory sketches with hover/zoom interactions and a transition from sketch to finished painting.
Color & Composition: Interactive highlights reveal how colors, stars, moon, village, and cypress tree shape the composition.
The Brushwork: Zoom into swirling brushstrokes, using subtle animation to emphasize texture and movement.
The Finished Painting: Dramatically reveal the complete artwork with essential details and a brief interpretation.
Legacy: Conclude with a visual timeline tracing the painting's cultural influence.
Use scroll-driven transitions, parallax, image reveals, hover effects, zoomable artwork, and smooth typography animations. Keep motion subtle and purposeful, like a curated museum exhibition.
Make the website fully responsive, with coherent storytelling, strong visual hierarchy, polished interactions, and high-quality external images where appropriate. Prioritize visual storytelling, editorial design, and atmosphere over complex UI components.优势:
不足:
优势:
不足:
| 测评点 | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| 视觉与交互 | ⭐⭐⭐⭐ | ⭐⭐⭐ |
| 技术实现 | ⭐⭐⭐⭐ | ⭐⭐⭐ |
| 用户意图理解 | ⭐⭐⭐⭐ | ⭐⭐⭐ |
只看同级对手,Haiku 5.5 交出了一份更有竞争力的答卷:对比 GPT-6 Luna,基础题整体占优,编程实现也体现出更成熟的工程思路。不过,降价解决的是使用门槛,能力边界依然存在,复杂编程和高难度自主执行任务上,它与旗舰模型仍有差距。
Haiku 5.5 在多模态推理和 SVG 绘制上都略胜 GPT-6 Luna,真正拉开差距的是编程。在 3D 跑酷和主题网页这类复杂任务里,它的优势体现在工程细节和完成度上:前者有较完整的对象管理、操作反馈和游戏状态设计,后者有展览级叙事、线稿到彩绘的交互过渡和细节放大。Luna 在部分视觉设计和响应式布局上也有亮点,但论综合完成度与实现质量,这个价位里能正面胜过它的只有 Haiku 5.5。
这是 Haiku 有史以来降价最多的一次,起步价只有上一代的十分之一。价格分两档:10 万 token 以内的请求(占 Haiku 4.5 调用量的九成)输入输出都降了九成,每百万 token 输入 $0.10、输出 $0.50;再配合首次加入的五档 effort,开发者可以按任务难度调节推理投入。摘要、分类、信息提取,以及需求和验收标准都明确的小型编程任务,都能从中受益。
但便宜账经得起细算吗?Haiku 5.5 换了分词器,相同内容的 token 消耗可能增加约 30%;在高 effort 和 Agent 多轮调用中,额外的思考 token、重复执行和上下文累积也会推高成本;提示词超过 10 万 token 后,输入和输出价格分别升至每百万 token $0.50 和 $2.50。评估性价比时,最好把完整任务的成功率、token 用量、重试次数和执行时间一起算进去,只看 API 单价很容易高估降本幅度。
Haiku 5.5 的价值在于“被调度”,而不是“挑大梁”。Anthropic 建议把它用作高阶模型的子代理,这与它的能力相符:旗舰负责拆解和统筹,Haiku 承担边界清晰、便于并行的执行工作。它的进步集中在执行层:OSWorld 从 15.7% 升到 72.4%,无工具 HLE 从 10.2% 升到 45.9%,路径清晰的执行任务相当能打,摘要、分类、压缩上下文、当子代理都是它的主场。
一旦任务依赖常识和世界知识,短板就会暴露:需要根据现实情况自动补全的任务,表现会明显变差,这是世界知识储备不足的典型特征。编程差距最直观:Terminal-Bench 39.2%,而 Sonnet 5.5 是 70.6%。复杂多步编码、跨文件重构、长周期自主规划,仍应首选 Sonnet 或 Opus。
把 Haiku 5.5 放进由旗舰模型指挥的流水线里,它才真正称得上便宜、快速、够用。总体来看,这是一次有分量的小模型升级:同级对比有优势,价格足够有竞争力,适合高频、标准化、边界清楚的工作流,值得用来压低一部分任务的成本。
转自 302.AI
据 Anthropic 官方版本说明,Claude Code 2.1.303 已发布,本次变更概括为错误修复与可靠性改进。采集到的版本说明未列出具体修复项目。
官方版本页仅列出错误修复和可靠性改进。
据 ggml 发布说明,llama.cpp b11721 将 qwen4exp 的 SCALE、SIGMOID、SCALE 与 hc_post 运算链融合,原先四个内核的处理改为一个内核执行。该实现移植了 Vulkan 的 HC_POST_GATE 融合方案。
版本说明描述将 qwen4exp 的 HC_POST 运算链融合为一个 CUDA 内核。
据 ggml 发布说明,llama.cpp b11720 预发布版本为 CPU、CUDA、Vulkan 和 WebGPU 后端加入非连续 SUM 运算支持,并添加对非连续视图执行 SUM 的测试用例。
预发布说明新增多个后端的非连续 SUM 支持及相关测试。
据 vLLM 发布说明,0.32.0 新增默认提供的 /v1/systemone 结构化决策端点,并加入读取模型 response_template 的 hf 工具与推理解析器。版本还扩展了低精度 KV 缓存支持。
发布说明列出结构化决策端点、通用解析器及低精度缓存扩展。
据 IT之家和 36氪报道,微软已退出与 Nscale 位于英国埃塞克斯郡劳顿的数据中心合作项目,微软原为该项目的锚定租户。IT之家称,退出原因尚未披露,微软和 Nscale 暂未回应置评请求。
据 Google API 更新日志,Gemini 4 Argon 已正式可用,模型标识为 gemini-4-argon,面向复杂编程、智能体、数学与科学任务。
Google 更新日志宣布 Gemini 4 Argon 正式可用。
据 Google API 更新日志,Gemini Nano Banana 2.1 正式可用,支持图像生成与对话式编辑。作为 Nano Banana 2 的更新版,它改进了视觉质量、指令遵循、多轮角色一致性和文字渲染。
Google 宣布 Nano Banana 2.1 正式可用,并列出图像生成改进。
据 ggml 发布说明,llama.cpp b11716 为 Hexagon 后端新增 Q1_0 和 Q2_0 量化格式支持,并让二维 HMX 矩阵乘路径能够处理 Q1_0 权重。
ggml 发布说明列出 Hexagon 新增两种量化格式支持及矩阵乘修复。
据 Anthropic 公告,公司拟向新设的 Anthropic Public Benefit Fund 承诺投入 5% 股份,仍需股东批准。公司估值超过设定基线后,每增长 50%,董事会可酌情再增加 2% 的股份投入。
官方宣布公益基金股权安排,初始承诺仍待股东批准。
据 36氪和 IT之家报道,微信鸿蒙版已出现小艺语音操作能力,可向联系人发文字消息或发起语音、视频通话。IT之家称该能力处于测试中,暂不支持群聊和微信分身。
据 36氪和 IT之家报道,DeepSeek V4.1 Flash 已更新至 Flash-1017,网页端、App 与 API 同步切换。API 调用方式和价格不变,仍可通过 deepseek-flash 访问新版本。
据 Google 发布说明,Gemini CLI 0.66.0 的 20261017 夜间预发布版新增提示,说明 CLI 尚未针对 Gemini 4 优化,并修复 PATH 遮蔽导致更新被误报成功的问题。
Google 夜间版说明新增 Gemini 4 提示,并修复更新验证与按键配置。
据 OpenAI 更新日志,所有 API 客户均可通过 API 或声音 Playground,用文本描述创建自定义声音,并在 GPT-Live 会话中复用。创建声音免费,语音生成按常规 GPT-Live 会话计费。
OpenAI 公布文本生成自定义声音的开放范围与计费方式。
据 ggml 发布记录,llama.cpp 的 b11701 版本新增 Reflection 的 Beam 模型支持,发布条目将这项模型适配列为该版本的更新。
ggml 的 b11701 发布记录列出 Reflection Beam 模型支持。
据 Anthropic 发布说明,Claude Code 2.1.302 可通过 CLAUDE_CODE_AUTO_MODE_MODEL 选择客户端自动模式分类器的模型,但不影响服务端自动模式;配置页另增空闲压缩开关。
Anthropic 列出客户端自动模式分类器配置与空闲压缩开关。
Anthropic 宣布用 Claude 研究 NIST 标准椭圆曲线的种子来源。IT之家报道,团队将五条曲线的种子追溯至以 Unix 时间戳初始化的伪随机数生成器;这并非破解 ECDSA,Anthropic 表示用户无需因此采取措施。
Anthropic 宣布追溯 ECDSA 曲线种子来源,并表示用户无需采取措施。
IT之家报道时间戳与伪随机生成器的复现方法,并列出尚未解释的细节。
据 The Verge 和 36氪报道,Meta 已移除商业条款中涉及网页内容用于 AI 训练的争议措辞。The Verge 指出,相关文字此前被专家解释为可能允许抓取新闻网站等站点;报道确认的是措辞变更。
Ars Technica 报道商业条款将涵盖关联网站内容,并引述法律界担忧。
The Verge 报道新条款可能允许抓取关联网站内容用于 AI 训练。
The Verge 称相关措辞已移除,原先的抓取授权效果属于专家解释。
36氪亦报道,涉及网页内容用于 AI 训练的争议表述已删除。
据 GitHub 公告,开源许可证合规功能正式面向 Enterprise Cloud 客户开放,包括数据驻留版本,但仓库须启用 Code Security。企业可通过规则集,在合并前检查新增或变更依赖的许可证。
GitHub 说明许可证策略的正式开放范围、合并检查和例外处理方式。
据 Hugging Face 发布说明,Transformers 5.20.1 新增 Reflection Beam 模型支持,并修复旧版 torch 下的模型加载问题。更新还修正自动映射及 HunYuan-VL 批量生成时的图像分配问题。
Hugging Face 发布 5.20.1,列出 Beam 支持及模型加载修复。
据 GitHub 公告,Actions 的 Xcode 27 托管运行器镜像结束公开预览,正式用于构建和测试 Apple 应用。镜像运行 macOS 27,包含 Xcode 27 工具链与 Apple SDK,仅支持 Apple Silicon 运行器。
GitHub 公布 Xcode 27 托管镜像正式开放,并明确仅支持 arm64。
据 GitHub 公告,Slack 和 Teams 中的 @GitHub 现可在同一段会话里跨多个仓库工作,包括创建问题、修改代码并发起拉取请求,以及结合前后端仓库调查故障。
GitHub 介绍 Slack 和 Teams 内跨仓库处理问题、拉取请求和故障调查的能力。
据 Anthropic 更新日志,Compliance API 开始向 Claude Enterprise 组织测试开放用户偏好查询,可返回成员在 claude.ai 保存的 Claude 指令,以及在 Cowork 保存的全局指令。
Anthropic 公布企业合规接口的用户指令查询测试版。
据 Anthropic 更新日志,Claude Opus 5.5 快速模式结束研究预览,无需再申请访问或发送快速模式 beta 请求头。所有用量层级均有默认快速模式限额,Azure 托管的 Microsoft Foundry 部署也已支持。
Anthropic 宣布 Opus 5.5 快速模式结束研究预览。
据 OpenAI 发布说明,Codex 0.163.0 可在配置页跨类别搜索偏好,并标明哪些设置需要重启。响应过程中发送后续消息可立即调整任务方向;中断回合也会停止活动 Code Mode 单元及其嵌套工具调用。
OpenAI 发布 Codex 0.163.0,增加设置搜索与响应中即时引导。
据 ggml 的 b11671 发布说明,llama.cpp 新增 Muse Spark Open 模型支持,覆盖文本、视觉和音频路径。实现包含潜在空间混合专家结构,并对量化处理作出专门调整。
ggml 的 b11671 发布说明新增 Muse Spark Open 文本、视觉与音频支持。
据 GitHub 公告,Team 和 Enterprise Cloud 用户现可下载 Code Quality 许可证用量 CSV。报告列出消耗许可证的活跃提交者、过去 90 天收到其提交的仓库,以及提交者是否仅属于单一仓库或组织。
GitHub 支持导出 Code Quality 许可证用量及提交者明细。
据 GitHub 公告,Copilot 将于 2026 年 11 月 16 日停用 Claude Opus 4.8、Opus 5 和 GPT-5.6 Terra,覆盖聊天、编辑、智能体与代码补全等体验。年付个人订阅者仍可使用 Opus 4.8,不受该项停用影响。
GitHub 列出 11 月 16 日停用模型及年付订阅例外。
据 Anthropic 版本说明,Claude Code 2.1.301 新增无人值守重试的用量限额等待上限配置,避免等待过远的重置时间。更新还修复搜索程序异常时错误返回无匹配结果的问题,改为明确报告搜索失败。
Anthropic 发布 Claude Code 2.1.301,调整无人值守重试并修复搜索错误反馈。
据 Ollama 发布说明,0.40.5 支持通过云端运行 clef 与 clef-flash 决策模型,无需先下载到本地。该版本还修复了 OpenAI 兼容 Responses 对话包含自定义工具调用时,继续对话会报错的问题。
Ollama 0.40.5 发布说明增加云端决策模型并修复 Responses 对话续接。
据 OpenAI 公告,Rosalind Academic Plan 将向符合条件的学术实验室提供 GPT-Rosalind 及相关工具的赞助访问,用于推进生命科学研究。
OpenAI 宣布向符合条件的学术实验室提供 Rosalind 赞助访问计划。
据 IT之家、The Verge 和 TechCrunch 报道,Bluesky 扩展实验性 AI 平台 Attie,用户可输入提示词生成小游戏、投票、测验和仪表盘等轻量互动应用,并作为独立网站分享。
IT之家报道 Attie 可生成小游戏、投票和仪表盘,并说明应用仍较轻量。
The Verge 报道用户可输入提示生成小型社交应用,并以独立网站分享。
TechCrunch 报道实验性 Attie 平台扩展至互动体验创作。
Google 介绍研究人员利用 Antigravity 发现一种新型抗菌肽候选分子,预测其对呼吸道感染病原体具有活性,目前仍在湿实验室验证。IT之家亦报道该流程,候选分子的预测效果尚未等同实验确认。
Google 介绍用 Antigravity 筛选抗菌肽候选,湿实验验证仍在进行。
IT之家报道研究者借助 ProtNLM 扫描 UniProt 蛋白质数据。
据 GitHub 公告,拉取请求 AI Scan 正式可用,可补充 CodeQL 尚未覆盖的语言和框架检测。结果仅供参考,不会使扫描检查失败或阻止合并;来自分叉仓库及 Dependabot 创建的拉取请求不运行此扫描。
GitHub 宣布 PR AI Scan 正式可用,并明确结果不能阻止合并。
NVIDIA 发布开放模型 Nemotron 3.5 Super VL 与 Bolt 74B-A9B,分别面向多模态智能体及本地工作负载,两者已可用。面向快速对话智能体的 Bolt E4B 4GB 计划于 10 月 23 日开放;IT之家亦报道此次发布。
NVIDIA 发布 Super VL 与 Bolt 74B,并预告 Bolt E4B 的开放日期。
IT之家介绍 Super VL 的多模态能力与配套权重、训练资料。
据 GitHub 公告,代码扫描告警的智能体自动修复正式可用,面向 Enterprise Cloud 上的 Code Security 与 Advanced Security 客户,包括数据驻留版本。Copilot 会探索代码、提出修复并重新运行 CodeQL 验证,再提交草稿拉取请求供审查。
GitHub 的智能体自动修复正式可用,提交草稿 PR 前重新运行 CodeQL。
据 GitHub 公告,仓库推送事件邮件通知已于 2026 年 10 月 15 日退役并停止发送。官方表示,此前接收者无需同意即可收到邮件,功能可能被用于通过 GitHub 邮件基础设施发送不受欢迎的消息。
GitHub 停止发送仓库推送事件邮件,以减少垃圾邮件与滥用。
据 Mistral 公告,Timestral 是其首个时序基础模型家族,提供 500 万至 2.09 亿参数的四种规模。模型支持概率多变量预测、仅历史可用及未来已知的协变量,并提供通过 Mistral Forge 进行领域适配微调的选项。
Mistral 发布 Timestral 时序模型家族,提供四种参数规模。
据 Anthropic 更新日志,OpenTelemetry 导出进入测试,可在可观测性后端跟踪 Messages API 请求和 Claude Managed Agents 会话。Claude SDK 支持七种语言输出追踪跨度;接收 API 跨度需在 Claude Console 配置导出目标。
据 GitHub 公告,HydraFusion 更新模型池和多模型编排流程,并新增 Max 选项,两者仍处于研究预览,可在 VS Code、Copilot 应用及 CLI 使用。流程会为起草与审查分别配置推理强度,并加入按需修复及多个模型并行审查的能力。
据 Anthropic 发布说明,Claude Code 2.1.300 将缓存写入遥测按五分钟和一小时有效期区分,并新增生成式 AI 语义约定追踪属性。模组可在提示框绘制不进入实际提交内容的虚拟文字;AWS 平台新增顾问入口,但选定顾问后才会运行。
据 GitHub 更新公告,Actions 工作流依赖锁文件公开预览支持 Enterprise Cloud、其数据驻留版本以及 Team 和 Free 套餐。锁文件让工作流按已记录的提交运行,避免标签或分支移动改变依赖代码;锁定不代表依赖本身安全,仍须审查。
据 Anthropic 版本说明,Claude Code 2.1.299 列出文件引用控制选项,可让模型通过文件工具读取路径,而非直接接收文件内容。终端长对话闲置约 54 分钟后可在缓存过期前压缩,压缩门槛可调;智能体视图还新增推理强度和快速模式设置入口。
据 Ollama 版本说明,0.40.4 可直接在终端运行决策模型,用于是非判断、文本分类或按规则评分。该版本新增通过 llama-server 使用多模态嵌入的支持,并让启动的 Codex 模型选择器列出本地 Ollama 模型,同时包含模型加载与推测解码相关修复。
据 GitHub 公告,GitHub Apps 和细粒度个人访问令牌新增仓库创建及安装仓库管理权限。应用可单独申请创建仓库能力,无需同时取得包含删除和转移能力的广泛管理权限。公告还介绍了应用管理和凭据管理界面的调整,以支持最小权限配置。
据 Google 的 Gemini CLI 发布说明,0.64.0 对文件工具操作进行串行处理并采用原子写入,状态持久化也支持原子保存及损坏后的备份恢复。更新还修复无界面模式的文件夹信任状态传递、活动操作期间的紧急中断,以及部分 Windows 交互问题。
据 GitHub 公告,Gemini 4 Argon 已在 Copilot 正式可用,面向 Pro+、Max、Business 和 Enterprise 用户逐步推送,可从支持的编辑器、命令行及应用中选择。模型采用按用量计费,Business 和 Enterprise 管理员可通过模型策略控制访问。
据 GitHub 公告,秘密扫描新增 Anthropic 服务与用户 API 密钥、Cloudsmith 密钥等检测类型,Salesforce 加入合作方计划。启用秘密扫描的仓库,包括免费公共仓库,会默认阻止包含新增 Anthropic 密钥类型的提交;公共仓库中的合作方凭据会报告给签发方。
Google 宣布 Gemini 4 Argon 已通过 AI Studio 和 Gemini 平台 API 向开发者及企业开放。Antigravity 面向 AI Ultra 用户,Gemini 应用和搜索 AI 模式面向 Ultra 与 Pro 用户;不同付费套餐仍有访问差异。
据 Anthropic 公告,公司在新加坡开设亚太地区第五个办公室,并与新加坡数字发展及新闻部签署合作备忘录。双方列出的合作方向包括 AI 安全、信息安全及模型评估。本地团队将支持新加坡企业和政府客户,公告提及的现有用户包括 GovTech、Grab 和 DBS。
据 GitHub 公告,企业管理员可要求 Copilot CLI、VS Code 和 Copilot 应用在启动时获取最新托管设置。启用该选项后,缓存不能替代策略确认;无法确认时客户端停止运行。沙箱设置还开始约束最低客户端版本,未启用强制刷新时仍沿用普通缓存机制。
据 GitHub 公告,Dependabot 在原漏洞依据失效后撤销告警时,webhook 新增 withdrawn 动作并携带移除前的标识信息。读取或更新已撤销告警的 REST 请求改为返回 410,而非 404。功能已面向 github.com 仓库开放,并将纳入企业服务器 3.24。
据 GitHub 公告,管理员可在安全概览查看 AI Scan 的发现数量、修复率、涉及仓库、趋势及自动修复建议采用情况。此次公开预览面向 github.com 上使用 Code Security 或 Advanced Security 的客户,暂不支持 Enterprise Server。